量子情報入門 第1章 §1.6
代表的な量子アルゴリズムを、詳細な回路よりも「なぜ量子的優位性が生まれるか」に焦点を絞って概観する。
Deutsch–Jozsaアルゴリズム
関数 f : { 0 , 1 } n → { 0 , 1 } f:\{0,1\}^n\to\{0,1\} f : { 0 , 1 } n → { 0 , 1 } 0 0 0 1 1 1 2 n − 1 + 1 2^{n-1}+1 2 n − 1 + 1 f f f 1回 で判定できる。鍵は、f f f x x x 干渉 させることで大域的な性質を1回の測定で読み出す点にある。
Groverアルゴリズム(振幅増幅)
N = 2 n N=2^n N = 2 n N N N N / 2 N/2 N /2 O ( N ) O(\sqrt N) O ( N ) 最良の一般的高速化 であることが知られている(BBBV下界)。
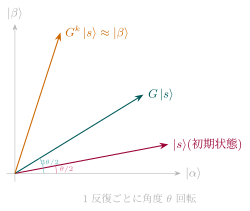
幾何学的描像
全 N N N
∣ β ⟩ = ∣ x ∗ ⟩ (マーク要素) , ∣ α ⟩ = 1 N − 1 ∑ x ≠ x ∗ ∣ x ⟩ (非マーク) . \ket\beta = \ket{x_\ast}\ \text{(マーク要素)},\qquad
\ket\alpha = \frac{1}{\sqrt{N-1}}\sum_{x\neq x_\ast}\ket x\ \text{(非マーク)}. ∣ β ⟩ = ∣ x ∗ ⟩ ( マーク要素 ) , ∣ α ⟩ = N − 1 1 x = x ∗ ∑ ∣ x ⟩ ( 非マーク ) .
初期の一様重ね合わせ
∣ s ⟩ = 1 N ∑ x ∣ x ⟩ = cos θ 2 ∣ α ⟩ + sin θ 2 ∣ β ⟩ , sin θ 2 = 1 N \ket s = \frac{1}{\sqrt N}\sum_x \ket x = \cos\frac{\theta}{2}\ket\alpha + \sin\frac{\theta}{2}\ket\beta,\qquad \sin\frac\theta2 = \frac{1}{\sqrt N} ∣ s ⟩ = N 1 x ∑ ∣ x ⟩ = cos 2 θ ∣ α ⟩ + sin 2 θ ∣ β ⟩ , sin 2 θ = N 1
はこの2次元平面内のベクトルで、∣ α ⟩ \ket\alpha ∣ α ⟩ θ / 2 ≈ 1 / N \theta/2\approx 1/\sqrt N θ /2 ≈ 1/ N 1 / N 1/\sqrt N 1/ N
Groverの1反復 G G G ∣ s ⟩ \ket s ∣ s ⟩ この2次元平面内での角度 θ \theta θ になる(2つの鏡映の合成は回転)。
∣ s ⟩ \ket s ∣ s ⟩ ∣ β ⟩ \ket\beta ∣ β ⟩ π / 2 \pi/2 π /2 θ ≈ 2 / N \theta \approx 2/\sqrt N θ ≈ 2/ N
k ≈ π / 2 θ ≈ π 4 N . k \approx \frac{\pi/2}{\theta} \approx \frac{\pi}{4}\sqrt N. k ≈ θ π /2 ≈ 4 π N .
「ステップサイズ ∼ 1 / N \sim 1/\sqrt N ∼ 1/ N ∼ 1 \sim 1 ∼ 1 N \sqrt N N
要点
Groverの N \sqrt N N 指数的加速 とは質的に異なる。指数的加速には問題に何らかの隠れた構造(周期性・群構造など)が必要で、非構造的な問題では原理的に N \sqrt N N
Shorの因数分解アルゴリズム
RSA暗号の安全性の基礎となる整数の素因数分解問題 は、古典的には多項式時間アルゴリズムが知られていない(O ( exp ( n 1 / 3 log 2 / 3 n ) ) O(\exp(n^{1/3}\log^{2/3} n)) O ( exp ( n 1/3 log 2/3 n )) n = log N n=\log N n = log N N N N 多項式時間 O ( n 3 ) O(n^3) O ( n 3 ) で因数分解する。
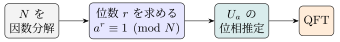
構造は以下の3段階からなり、核心の量子計算は最後のQFT に集約されている :
各ステップの意味:
古典帰着(因数分解 → 位数発見) :1 < a < N 1<a<N 1 < a < N a r ≡ 1 ( m o d N ) a^r\equiv 1\pmod N a r ≡ 1 ( mod N ) r r r a a a N N N r r r a r / 2 ≢ − 1 ( m o d N ) a^{r/2}\not\equiv -1\pmod N a r /2 ≡ − 1 ( mod N ) gcd ( a r / 2 ± 1 , N ) \gcd(a^{r/2}\pm 1, N) g cd( a r /2 ± 1 , N ) N N N 量子帰着(位数発見 → 位相推定) :モジュラー乗算ユニタリ
U a ∣ x ⟩ = ∣ a x m o d N ⟩ U_a\ket x = \ket{ax\bmod N} U a ∣ x ⟩ = ∣ a x mod N ⟩
の固有値は e 2 π i s / r e^{2\pi i s/r} e 2 π i s / r s = 0 , 1 , … , r − 1 s=0,1,\ldots,r-1 s = 0 , 1 , … , r − 1 U a U_a U a s / r s/r s / r r r r 核心(位相推定 → QFT) :位相推定の最終段は QFT。古典 FFT が O ( N log N ) O(N\log N) O ( N log N ) O ( log 2 N ) O(\log^2 N) O ( log 2 N ) 指数的に速い 。
要点
なぜ古典で難しく量子で速いのか 。古典では位数 r r r a , a 2 , a 3 , … a, a^2, a^3,\ldots a , a 2 , a 3 , … r r r N N N
補遺:U a U_a U a
上の段階2「位数発見 → 位相推定」を支える代数構造を詳しく調べる。以下 gcd ( a , N ) = 1 \gcd(a,N)=1 g cd( a , N ) = 1 gcd \gcd g cd
U a U_a U a U a ∣ x ⟩ = ∣ a x m o d N ⟩ U_a\ket x=\ket{ax\bmod N} U a ∣ x ⟩ = ∣ a x mod N ⟩
は計算基底を計算基底に写す置換型の演算子である。gcd ( a , N ) = 1 \gcd(a,N)=1 g cd( a , N ) = 1 a a a m o d N \bmod\,N mod N a − 1 a^{-1} a − 1 x ↦ a x m o d N x\mapsto ax\bmod N x ↦ a x mod N Z / N Z \mathbb Z/N\mathbb Z Z / N Z 全単射 になる。基底を基底に写す全単射は置換行列であり、置換行列はユニタリである。もし gcd ( a , N ) > 1 \gcd(a,N)>1 g cd( a , N ) > 1 a x ≡ a x ′ ax\equiv ax' a x ≡ a x ′ x ≠ x ′ x\neq x' x = x ′ U a U_a U a ユニタリ性は「可逆な古典計算の埋め込み」の量子力学的な表現 であり、gcd ( a , N ) = 1 \gcd(a,N)=1 g cd( a , N ) = 1
固有ベクトルの構成
位数を r r r a r ≡ 1 m o d N a^r\equiv 1\bmod N a r ≡ 1 mod N { 1 , a , a 2 , … , a r − 1 } \{1,a,a^2,\ldots,a^{r-1}\} { 1 , a , a 2 , … , a r − 1 } m o d N \bmod\,N mod N U a U_a U a r r r U a U_a U a
∣ u s ⟩ ≡ 1 r ∑ k = 0 r − 1 e − 2 π i s k / r ∣ a k m o d N ⟩ , s = 0 , 1 , … , r − 1 \ket{u_s} \equiv \frac{1}{\sqrt r}\sum_{k=0}^{r-1} e^{-2\pi i sk/r}\,\ket{a^k\bmod N},\qquad s=0,1,\ldots,r-1 ∣ u s ⟩ ≡ r 1 k = 0 ∑ r − 1 e − 2 π i s k / r ∣ a k mod N ⟩ , s = 0 , 1 , … , r − 1
である。実際、
U a ∣ u s ⟩ = 1 r ∑ k = 0 r − 1 e − 2 π i s k / r ∣ a k + 1 m o d N ⟩ = e 2 π i s / r 1 r ∑ k ′ = 1 r e − 2 π i s k ′ / r ∣ a k ′ m o d N ⟩ = e 2 π i s / r ∣ u s ⟩ U_a\ket{u_s} = \frac{1}{\sqrt r}\sum_{k=0}^{r-1}e^{-2\pi isk/r}\ket{a^{k+1}\bmod N}
= e^{2\pi is/r}\,\frac{1}{\sqrt r}\sum_{k'=1}^{r}e^{-2\pi isk'/r}\ket{a^{k'}\bmod N}
= e^{2\pi is/r}\ket{u_s} U a ∣ u s ⟩ = r 1 k = 0 ∑ r − 1 e − 2 π i s k / r ∣ a k + 1 mod N ⟩ = e 2 π i s / r r 1 k ′ = 1 ∑ r e − 2 π i s k ′ / r ∣ a k ′ mod N ⟩ = e 2 π i s / r ∣ u s ⟩
となる(k ′ = k + 1 k'=k+1 k ′ = k + 1 k ′ = r k'=r k ′ = r a r ≡ 1 a^r\equiv 1 a r ≡ 1 k ′ = 0 k'=0 k ′ = 0 N = 15 , a = 2 , r = 4 N=15,a=2,r=4 N = 15 , a = 2 , r = 4 s s s e 2 π i s / r e^{2\pi is/r} e 2 π i s / r φ s = s / r \varphi_s=s/r φ s = s / r
ここで s s s 整数 であることは仮定ではなく帰結である点に注意したい。巡回置換を対角化する位相 e i θ e^{i\theta} e i θ r r r U a r ∣ a k ⟩ = ∣ a k ⟩ U_a^r\ket{a^k}=\ket{a^k} U a r ∣ a k ⟩ = ∣ a k ⟩ e i r θ = 1 e^{ir\theta}=1 e i r θ = 1 θ = 2 π s / r \theta=2\pi s/r θ = 2 π s / r s ∈ Z s\in\mathbb Z s ∈ Z 離散化 される。有限次元の巡回構造が位相を量子化するのであって、連続な s s s
固有ベクトルを用意できない問題とその解決
位相推定には固有ベクトル ∣ u s ⟩ \ket{u_s} ∣ u s ⟩ ∣ u s ⟩ \ket{u_s} ∣ u s ⟩ r r r r r r
1 r ∑ s = 0 r − 1 ∣ u s ⟩ = ∣ 1 ⟩ \frac{1}{\sqrt r}\sum_{s=0}^{r-1}\ket{u_s} = \ket 1 r 1 s = 0 ∑ r − 1 ∣ u s ⟩ = ∣ 1 ⟩
である(幾何級数 ∑ s e − 2 π i s k / r = r δ k 0 \sum_s e^{-2\pi isk/r}=r\delta_{k0} ∑ s e − 2 π i s k / r = r δ k 0 ∣ 1 ⟩ \ket 1 ∣ 1 ⟩ 全固有ベクトルの一様な重ね合わせ になっている。∣ 1 ⟩ \ket 1 ∣ 1 ⟩ ∣ u s ⟩ \ket{u_s} ∣ u s ⟩ s s s φ s = s / r \varphi_s = s/r φ s = s / r
連分数展開による r r r
位相推定の出力は m / 2 t ≈ s / r m/2^t \approx s/r m / 2 t ≈ s / r t t t t t t t ≥ 2 log 2 N + 1 t\ge 2\log_2 N+1 t ≥ 2 log 2 N + 1 s / r s/r s / r m / 2 t m/2^t m / 2 t 連分数展開 の近似分数(convergent)として一意に復元できる(分母 ≤ N \le N ≤ N 1 / N 2 1/N^2 1/ N 2 gcd ( s , r ) = 1 \gcd(s,r)=1 g cd( s , r ) = 1 s s s r r r r r r gcd ( a r / 2 ± 1 , N ) \gcd(a^{r/2}\pm1,N) g cd( a r /2 ± 1 , N )
要点
このsubsectionの構造を振り返ると、数論(gcd \gcd g cd という往復になっている。第1.5.6 節の位相キックバックが「固有値の位相を制御レジスタに転写する」一般機構であり、Shorはそれを巡回群の表現論が保証する離散位相 s / r s/r s / r
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com