相対エントロピーから情報と物理を組み立てる 第1部 第5章 §1.5.5 ★★★ 記号を n n n H / ln 2 H/\ln2 H / ln 2 1 / n 1/n 1/ n H H H 0 0 0
ブロック符号:可変長の場合
無記憶情報源の記号を n n n X n = ( X 1 , … , X n ) X^n=(X_1,\dots,X_n) X n = ( X 1 , … , X n ) X n X^n X n p n ( x n ) = p ( x 1 ) ⋯ p ( x n ) p^n(x^n)=p(x_1)\cdots p(x_n) p n ( x n ) = p ( x 1 ) ⋯ p ( x n ) n n n 第1部第2章 ・第1部第3章 )ので H ( X n ) = n H ( X ) H(X^n)=nH(X) H ( X n ) = n H ( X )
定理 1.5.12(情報源符号化定理(可変長)★★★)
X n X^n X n ℓ ˉ n ∗ \bar\ell_n^* ℓ ˉ n ∗
H ( X ) ln 2 ≤ ℓ ˉ n ∗ n < H ( X ) ln 2 + 1 n (1.5.9) \frac{H(X)}{\ln2}\ \le\ \frac{\bar\ell_n^*}{n}\ <\ \frac{H(X)}{\ln2}+\frac1n\tag{1.5.9} ln 2 H ( X ) ≤ n ℓ ˉ n ∗ < ln 2 H ( X ) + n 1 ( 1.5.9 )
が成り立つ。したがって n → ∞ n\to\infty n → ∞ H ( X ) / ln 2 H(X)/\ln2 H ( X ) / ln 2
証明 X n X^n X n 1.5.7 と定理 1.5.8 (q = p q=p q = p n H ( X ) / ln 2 ≤ ℓ ˉ n ∗ < n H ( X ) / ln 2 + 1 nH(X)/\ln2\le\bar\ell_n^*<nH(X)/\ln2+1 n H ( X ) / ln 2 ≤ ℓ ˉ n ∗ < n H ( X ) / ln 2 + 1 n n n
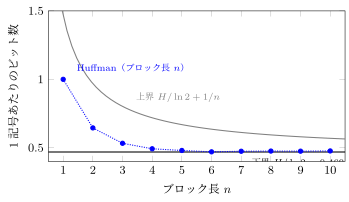
下界は、D ≥ 0 D\ge0 D ≥ 0 n n n 1 / n 1/n 1/ n n n n 1.5.4 節の最後の例(確率 0.9 0.9 0.9 0.1 0.1 0.1 n n n 1.5.3 である。n = 1 n=1 n = 1 1 1 1 n = 2 n=2 n = 2 0.645 0.645 0.645 n = 4 n=4 n = 4 0.493 0.493 0.493 n = 6 n=6 n = 6 0.470 0.470 0.470 0.469 0.469 0.469 n = 7 n=7 n = 7 0.474 0.474 0.474 n = 6 n=6 n = 6 (1.5.9) が保証するのは 1 / n 1/n 1/ n n n n 2 2 2
図 1.5.3 確率 ( 0.9 , 0.1 ) (0.9,0.1) ( 0.9 , 0.1 ) n n n 1.5.12 の下界と上界。値は 2 n 2^n 2 n
固定長の符号と典型集合
可変長の符号は、記号列ごとに長さが変わる。これに対して、長さ n n n n R nR n R R R R 符号化率 と呼び、単位はビット毎記号)。n R nR n R 2 n R 2^{nR} 2 n R ∣ X ∣ n \lvert \mathcal X\rvert ^n ∣ X ∣ n H / ln 2 H/\ln2 H / ln 2
ここで第1部第2章 の漸近等分割性(AEP)を使う。ϵ > 0 \epsilon>0 ϵ > 0
A ϵ ( n ) = { x n : ∣ − 1 n ln p n ( x n ) − H ( X ) ∣ ≤ ϵ } (1.5.10) A_\epsilon^{(n)}=\Bigl\{x^n:\ \Bigl|-\frac1n\ln p^n(x^n)-H(X)\Bigr|\le\epsilon\Bigr\}\tag{1.5.10} A ϵ ( n ) = { x n : − n 1 ln p n ( x n ) − H ( X ) ≤ ϵ } ( 1.5.10 )
を典型集合 と呼ぶ。第1部第2章で示したとおり、大数の法則から Pr ( X n ∈ A ϵ ( n ) ) → 1 \Pr(X^n\in A_\epsilon^{(n)})\to1 Pr ( X n ∈ A ϵ ( n ) ) → 1 n → ∞ n\to\infty n → ∞ e − n ( H + ϵ ) ≤ p n ( x n ) ≤ e − n ( H − ϵ ) \mathrm{e}^{-n(H+\epsilon)}\le p^n(x^n)\le\mathrm{e}^{-n(H-\epsilon)} e − n ( H + ϵ ) ≤ p n ( x n ) ≤ e − n ( H − ϵ ) ∣ A ϵ ( n ) ∣ ≤ e n ( H + ϵ ) \lvert A_\epsilon^{(n)}\rvert \le\mathrm{e}^{n(H+\epsilon)} ∣ A ϵ ( n ) ∣ ≤ e n ( H + ϵ )
定理 1.5.13(情報源符号化定理(固定長)★★★)
符号化率 R R R
(i) R ln 2 > H ( X ) R\ln2>H(X) R ln 2 > H ( X ) n → ∞ n\to\infty n → ∞ 0 0 0 (ii) R ln 2 < H ( X ) R\ln2<H(X) R ln 2 < H ( X ) n → ∞ n\to\infty n → ∞ 1 1 1
証明 (i) R ln 2 > H + ϵ R\ln2>H+\epsilon R ln 2 > H + ϵ ϵ > 0 \epsilon>0 ϵ > 0 n R nR n R e n ( H + ϵ ) < 2 n R \mathrm{e}^{n(H+\epsilon)}<2^{nR} e n ( H + ϵ ) < 2 n R X n X^n X n n → ∞ n\to\infty n → ∞ 0 0 0
(ii) R ln 2 < H − 2 ϵ R\ln2<H-2\epsilon R ln 2 < H − 2 ϵ ϵ > 0 \epsilon>0 ϵ > 0 B n B_n B n ∣ B n ∣ ≤ 2 n R \lvert B_n\rvert \le2^{nR} ∣ B n ∣ ≤ 2 n R
Pr ( X n ∈ B n ) ≤ Pr ( X n ∈ B n ∩ A ϵ ( n ) ) + Pr ( X n ∉ A ϵ ( n ) ) ≤ 2 n R e − n ( H − ϵ ) + Pr ( X n ∉ A ϵ ( n ) ) . \Pr(X^n\in B_n)\le\Pr(X^n\in B_n\cap A_\epsilon^{(n)})+\Pr(X^n\notin A_\epsilon^{(n)})
\le2^{nR}\,\mathrm{e}^{-n(H-\epsilon)}+\Pr(X^n\notin A_\epsilon^{(n)}) . Pr ( X n ∈ B n ) ≤ Pr ( X n ∈ B n ∩ A ϵ ( n ) ) + Pr ( X n ∈ / A ϵ ( n ) ) ≤ 2 n R e − n ( H − ϵ ) + Pr ( X n ∈ / A ϵ ( n ) ) .
第1項は e n ( R ln 2 − H + ϵ ) ≤ e − n ϵ \mathrm{e}^{n(R\ln2-H+\epsilon)}\le\mathrm{e}^{-n\epsilon} e n ( R l n 2 − H + ϵ ) ≤ e − n ϵ 0 0 0 0 0 0 1 − δ 1-\delta 1 − δ e n ( H − ϵ ) \mathrm{e}^{n(H-\epsilon)} e n ( H − ϵ )
(ii) の証明が示すのは、典型集合の1つ1つの列の確率がほぼ e − n H \mathrm{e}^{-nH} e − n H e n H \mathrm{e}^{nH} e n H H H H e n H \mathrm{e}^{nH} e n H (1.5.5) と D ≥ 0 D\ge0 D ≥ 0
例題 1.5.5 有限の n n n
オリジナル 1 1 1 0.1 0.1 0.1 0 0 0 0.9 0.9 0.9 n = 100 n=100 n = 100
1 1 1 1 1 1 k k k 1 % 1\% 1% k k k そのとき必要なビット数を求め、n H ( X ) / ln 2 nH(X)/\ln2 n H ( X ) / ln 2 100 100 100
n n n 1000 1000 1000 10000 10000 10000
解答 (1) 1 1 1 K K K B i n ( 100 , 0.1 ) \mathrm{Bin}(100,0.1) Bin ( 100 , 0.1 ) Pr ( K ≤ 17 ) < 0.99 \Pr(K\le17)<0.99 Pr ( K ≤ 17 ) < 0.99 Pr ( K ≤ 18 ) = 0.9954 \Pr(K\le18)=0.9954 Pr ( K ≤ 18 ) = 0.9954 k = 18 k=18 k = 18
(2) 番号を付ける列の数は N = ∑ j = 0 18 ( 100 j ) N=\sum_{j=0}^{18}\binom{100}{j} N = ∑ j = 0 18 ( j 100 ) log 2 N = 65.08 \log_2N=65.08 log 2 N = 65.08 66 66 66 n H ( X ) / ln 2 = 100 × 0.469 = 46.9 nH(X)/\ln2=100\times0.469=46.9 n H ( X ) / ln 2 = 100 × 0.469 = 46.9 100 100 100 19 19 19
(3) 同じ手順(誤り確率 1 % 1\% 1% k k k n = 1000 n=1000 n = 1000 k = 123 k=123 k = 123 0.533 0.533 0.533 n = 10000 n=10000 n = 10000 k = 1070 k=1070 k = 1070 0.490 0.490 0.490 H ( X ) / ln 2 = 0.469 H(X)/\ln2=0.469 H ( X ) / ln 2 = 0.469 1 % 1\% 1% n n n K K K n ⋅ 0.1 ⋅ 0.9 \sqrt{n\cdot0.1\cdot0.9} n ⋅ 0.1 ⋅ 0.9 n n n n H / ln 2 nH/\ln2 n H / ln 2 1.5.3 )よりずっと遅く、誤り確率 1 % 1\% 1% 2 ∼ 3 2\sim3 2 ∼ 3 1 1 1
分布を知らない場合
ここまでの符号はすべて情報源の分布 p p p p p p q q q (1.5.7) のとおり1記号あたり D ( p ∥ q ) / ln 2 D(p\,\|\,q)/\ln2 D ( p ∥ q ) / ln 2 n n n 1 1 J. Ziv and A. Lempel (1977), IEEE Transactions on Information Theory 23 , 337–343; (1978), 同 24 , 530–536.0 0 0 ユニバーサル符号 と呼ぶ。推定と符号長の関係は 1.5.6 節で、最尤推定と符号長の最小化が同じ問題であることとして見る。
1 J. Ziv and A. Lempel (1977), IEEE Transactions on Information Theory 23 , 337–343; (1978), 同 24 , 530–536.
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com