相対エントロピーから情報と物理を組み立てる 第1部 第8章 §1.8.3 ★★★ 平均を決めた集合への I 射影は指数型の分布で、指数は対数積率母関数の Legendre 変換になる
平均を決めた集合
物理でも統計でも、問いは多くの場合「ある量の標本平均が a 以上になる確率」の形をとる。f:X→R を1つ決め、fˉn=n1∑i=1nf(Xi) とおく。fˉn=∑apXn(a)f(a)=⟨f⟩pXn なので、「fˉn≥a」は「型が Ea={p:⟨f⟩p≥a} に入る」と同じである。Ea は線形の不等式で決まる凸な閉集合なので、Sanov の定理がそのまま使え、残る仕事は minp∈EaD(p∥q) の計算になる。
そのための道具として、q のもとでの対数積率母関数
Λ(λ)=ln⟨eλf(X)⟩q=lnx∑q(x)eλf(x)(λ∈R)(1.8.9)
と、q を eλf で傾けた指数型の分布
qλ(x)=q(x)eλf(x)−Λ(λ)(1.8.10)
を用意する。Λ は凸で、Λ′(λ)=⟨f⟩qλ、Λ′′(λ)=Varqλ(f)≥0 である。λ=0 では q0=q で、Λ′(0)=μ:=⟨f⟩q、Λ′′(0)=σ2:=Varq(f) になる。λ を 0 から増やすと qλ は f の大きい記号へ重みを移し、平均 Λ′(λ) は f の最小値と最大値の間を単調に動く。
補題 1.8.5(傾きの恒等式 ★★★)
任意の分布 p と任意の λ について
D(p∥q)=D(p∥qλ)+λ⟨f⟩p−Λ(λ).(1.8.11)
証明
式 (1.8.10) から lnq(x)p(x)=lnqλ(x)p(x)+λf(x)−Λ(λ)。両辺を p で平均する。
この恒等式から、平均が a の分布の中での D(p∥q) の最小がすぐに出る。⟨f⟩p=a なら D(p∥q)≥λa−Λ(λ) がすべての λ で成り立ち(D(p∥qλ)≥0 だから)、等号は p=qλ のときに限る。Λ′(λ∗)=a となる λ∗ を選べば qλ∗ 自身の平均が a なので等号が実現し、
⟨f⟩p=aminD(p∥q)=Λ∗(a):=λ∈Rsup(λa−Λ(λ))=λ∗a−Λ(λ∗)(1.8.12)
を得る。Λ∗ は Λ の Legendre 変換(Legendre–Fenchel 変換)で、レート関数と呼ばれる。最小を与える分布は指数型の分布 qλ∗ で、平均が a の分布 p すべてについて式 (1.8.11) はD(p∥q)=D(p∥qλ∗)+D(qλ∗∥q) という Pythagoras の等式になる。
定理 1.8.6(Cramér の定理(有限の X)★★★)
f の最大値を fmax とし、μ<a<fmax とする。このとき
qn(fˉn≥a)≤e−nΛ∗(a)(すべての n),n→∞limn1lnqn(fˉn≥a)=−Λ∗(a).(1.8.13)
証明
上界(Chernoff の評価):λ≥0 について Markov の不等式からqn(fˉn≥a)=qn(eλ∑if(Xi)≥enλa)≤e−nλa⟨eλ∑if(Xi)⟩=e−n(λa−Λ(λ))。a>μ では λa−Λ(λ) の上限は λ≥0 の側でとるので、λ について下限をとれば e−nΛ∗(a) になる。
極限:Ea は凸で、a<fmax なので内部の閉包に等しい。Sanov の定理から指数は minp∈EaD(p∥q) で、Λ∗ は a>μ で増加するので最小は境界 ⟨f⟩p=a の上にあり、式 (1.8.12) から Λ∗(a) に等しい。
上界の証明は Sanov の定理を使わずに1行で済み、しかも多項式の因子がない。この評価は H. Chernoff の名で呼ばれる1H. Chernoff (1952), Ann. Math. Statist. 23, 493–507。。極限の形の定理は H. Cramér による2H. Cramér (1938), Actualités Scientifiques et Industrielles 736(Hermann, Paris)。英訳は H. Touchette による arXiv:1802.05988。。Cramér の定理は X が有限でなくても、Λ(λ) が λ=0 の近くで有限なら成り立つ。たとえば f(X) が平均 μ・分散 σ2 の Gauss 分布に従うなら、Λ(λ)=μλ+21σ2λ2、Λ∗(a)=2σ2(a−μ)2 である。
レート関数の形と中心極限定理
Λ∗ は凸で、a=μ で最小値 0 をとる。μ の近くで展開すると、Legendre 変換は2階微分を逆数にするので Λ∗′′(μ)=1/Λ′′(0)=1/σ2、
Λ∗(a)=2σ2(a−μ)2+O((a−μ)3)(1.8.14)
となる。2次の項だけを残すと qn(fˉn≥a)≈e−n(a−μ)2/(2σ2) で、これは中心極限定理の Gauss 分布の裾と指数の係数で一致する。中心極限定理は a−μ が 1/n の大きさのずれを正しく扱うが、a−μ を n によらず固定した大偏差では、3次以上の項が指数に入るので Gauss 分布の裾を使うことはできない。図 1.8.2 は、さいころの目の平均について2つを比べたものである。
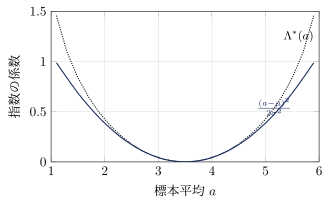
図 1.8.2 公平なさいころ(f(x)=x、μ=3.5、σ2=35/12)のレート関数。点線が厳密な Λ∗(a)、実線が中心極限定理に対応する2次の近似。平均の近くでは一致し、a が 1 や 6 に近づくと Λ∗ は ln6=1.79 に向かって急に立ち上がる。
例題 1.8.4 さいころの平均が4.5以上 ★★
オリジナル公平なさいころを n 回振り、出た目の平均が 4.5 以上になる確率の指数 Λ∗(4.5) を求める。
- Λ(λ) を書き、Λ′(λ∗)=4.5 を数値で解いて λ∗ を求めよ。
- Λ∗(4.5) を求め、2次の近似 2σ2(4.5−3.5)2 と比べよ。
- 平均が 4.5 以上だったと知ったとき、目の分布として最もありそうなもの qλ∗ を求めよ。
解答
(1) Λ(λ)=ln61∑x=16eλx で、Λ′(λ)=∑xxeλx/∑xeλx。これは λ について単調増加なので二分法で解けて、λ∗=0.371 を得る。
(2) Λ∗(4.5)=4.5λ∗−Λ(λ∗)=0.178。2次の近似は 2×35/121=356=0.171 で、厳密な値より 4% ほど小さい。目の範囲に上限 6 があるので、平均を上げるのは Gauss 分布で見積もるより少し難しく、指数が大きくなる。
(3) qλ∗(x)∝e0.371x を規格化して、x=1,…,6 の順に (0.054,0.079,0.114,0.165,0.240,0.347)。平均を 4.5 に上げる方法は「6が多く出る」だけでなく無数にあるが、そのうち D が最小のものは、各目の確率を eλ∗x に比例して一様に傾けたものである。
1 H. Chernoff (1952), Ann. Math. Statist. 23, 493–507。
2 H. Cramér (1938), Actualités Scientifiques et Industrielles 736(Hermann, Paris)。英訳は H. Touchette による arXiv:1802.05988。
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com
