相対エントロピーから情報と物理を組み立てる 第1部 第8章 §1.8.5 ★★★ 2つの分布を見分ける検定の第2種の誤りは e−nD(p0∥p1) で減る。D の非対称性の意味
2つの仮説と2種類の誤り
データ X1,…,Xn が独立同分布で、その分布が p0 か p1 のどちらかだと分かっているとする。p0 だとする仮説を H0、p1 だとする仮説を H1 と書く。検定とは、系列の集合 An を決め、xn∈An なら H0 を採る(受容する)と決める規則である。誤りは2種類ある。
αn=p0n(Anc)(第1種の誤り),βn=p1n(An)(第2種の誤り).(1.8.16)
両方を同時に 0 にはできないので、αn≤ϵ という制約の下で βn を最小にする。制約の下での最小値を βnϵ と書く。
Neyman–Pearson の補題によれば、最適な検定は尤度比 ∏ip0(xi)/p1(xi) が閾値以上のとき H0 を採る形をとる。対数尤度比を n で割ったものは型で書けて、
n1i=1∑nlnp1(xi)p0(xi)=a∑pxn(a)lnp1(a)p0(a)=D(pxn∥p1)−D(pxn∥p0)(1.8.17)
となる。尤度比検定は「経験分布が p1 より p0 に D の意味で近いか」を比べる検定である。
Stein の補題
定理 1.8.8(Stein の補題 ★★★)
0<ϵ<1 を固定し、D(p0∥p1)<∞ とする。このとき
n→∞lim−n1lnβnϵ=D(p0∥p1).(1.8.18)
証明
達成(βnϵ をここまで小さくできる):δ>0 を決め、対数尤度比 (1.8.17) が D(p0∥p1)−δ 以上の系列の集合を An とする。p0 のもとで対数尤度比の平均はちょうど D(p0∥p1) なので、大数の法則から αn=p0n(Anc)→0 で、十分大きな n で αn≤ϵ になる。An の上では p1n(xn)≤p0n(xn)e−n(D(p0∥p1)−δ) なので、βn=p1n(An)≤e−n(D(p0∥p1)−δ)p0n(An)≤e−n(D(p0∥p1)−δ)。
逆(これより小さくはできない):任意の検定 An を、系列 xn を「An に入るか否か」の2値に写す通信路とみなす。データ処理不等式(第1部第4章)と D(p0n∥p1n)=nD(p0∥p1) から、2値の分布の相対エントロピーd(x∥y)=xlnyx+(1−x)ln1−y1−x について
nD(p0∥p1)≥d(1−αn∥βn)≥(1−αn)lnβn1−hb(αn)≥(1−ϵ)lnβn1−ln2.(1.8.19)
2つ目の不等号は d(x∥y)=−hb(x)+xlny1+(1−x)ln1−y1 の最後の項が非負であることによる。したがって−n1lnβn≤1−ϵD(p0∥p1)+ln2/n。ここから limsup−n1lnβnϵ≤D(p0∥p1)/(1−ϵ) が出る。ϵ によらず D(p0∥p1) まで上界を下げるには、達成の側と似た集合 Bn(対数尤度比が D+δ 以下)を使い、βn≥p1n(An∩Bn)≥e−n(D+δ)p0n(An∩Bn)≥e−n(D+δ)(1−ϵ−p0n(Bnc)) とする。大数の法則から p0n(Bnc)→0 なので、limsup−n1lnβnϵ≤D(p0∥p1)+δ で、δ は任意である。
Stein の補題によって、相対エントロピーは「2つの分布を見分けるときの、誤りの減る速さ」という操作的な意味を持つ。式 (1.8.19) の形の逆の証明は、データ処理不等式が「どんな検定(データの加工)も D を増やせない」と言っていることの直接の帰結で、見分ける力の上限は nD(p0∥p1) で決まる。
D の非対称性
αn を小さく固定して βn の指数を問うと D(p0∥p1) が出て、役割を入れ替えると D(p1∥p0) が出る。2つは一般に違う。D(p0∥p1) は「p0 から出たデータを p1 だと見誤る」ことの難しさで、データが従う側の分布で平均をとる。両方の誤りを同じ速さで減らしたいとき(事前確率をつけて誤りの和を最小にするとき)の指数は Chernoff 情報
C(p0,p1)=−0≤s≤1minlnx∑p0(x)1−sp1(x)s(1.8.20)
で、D(p0∥p1) と D(p1∥p0) のどちらよりも小さい。記号 C はこの節だけで使う(通信路容量 C とは別)。
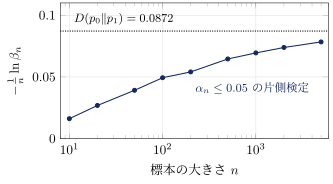
図 1.8.4 H0:表の確率 0.5、H1:表の確率 0.7 の検定で、αn≤0.05 を満たす「表の回数が閾値以下なら H0」の検定の第2種の誤りの指数(二項分布から計算した厳密な値)。点線の D(p0∥p1) への近づき方は O(1/n) で遅い。
例題 1.8.6 公平な硬貨と偏った硬貨を見分ける ★★
オリジナルH0:表の確率 0.5、H1:表の確率 0.7 とする。
- D(p0∥p1) と D(p1∥p0) を求めよ。
- αn≤0.05 のもとで βn≈10−3 にしたい。Stein の補題の指数で見積もると n はおよそいくら要るか。
- Chernoff 情報 C(p0,p1) を数値で求め、(1) の2つと比べよ。
解答
(1) D(p0∥p1)=0.5ln0.70.5+0.5ln0.30.5=0.0872、D(p1∥p0)=0.7ln0.50.7+0.3ln0.50.3=0.0823。値は近いが等しくない。
(2) e−n×0.0872=10−3 から n=ln1000/0.0872=79 程度。ただし図 1.8.4 のとおり、αn を 0.05 に固定した検定の指数は n が数百から千でも D の 6〜8 割にとどまるので、実際に要る n はこれより大きい。Stein の補題は指数の極限についての主張で、有限の n では多項式の因子と O(1/n) の補正が残る。
(3) g(s)=ln(0.51−s0.7s+0.51−s0.3s) を 0≤s≤1 で最小にすると s=0.493 で、C=0.0213。これは D(p0∥p1) と D(p1∥p0) のおよそ4分の1で、両方の誤りを同時に小さくするほうが、片方だけを小さくするよりずっと多くの標本を要する。
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com
