実験計画法 第1章 §1.1 ★★ 反復・無作為化・局所管理の3原則が、それぞれ誤差の推定・偏りの除去・誤差の縮小を担う
実験計画法は、限られた回数の実験から、どの要因が結果にどれだけ影響するかを、誤差の大きさと比べて判定するための方法である。その中身は次の2つに分かれる。
計画 :実験をどう組むか(因子と水準の選び方、実験の順序、ブロックの作り方)を決める部分。解析 :得られたデータから平方和を分解して検定と推定を行う部分。
計画が悪いと、解析をどれだけ丁寧に行っても要因の効果と別の原因の影響を区別することができない。そのため、この章ではまず計画の側の原則(Fisher の3原則)を、数式で確かめられる形で述べる。
次に、解析の側の道具として、正規母集団の平均と分散に関する検定と区間推定を復習する。分散分析の F F F t t t 1.2 で導いておくと、第2章以降の分散分析表が何を計算しているかを、既に知っている t t t
資格試験の応用(理工学)の科目で、この章の内容が単独の大問になることは少ない。ただし、「この実験で無作為化が必要な理由を述べよ」「ブロックを設けると誤差分散がどう変わるか」のような説明の小問や、2群比較の t t t F F F
実験計画法の対象と手順
実験で結果として測る量を特性値 、特性値に影響しそうな原因のうち実験者が意図的に変えるものを因子 、因子をどの値に設定するかの段階を水準 と呼ぶ(第2章 §2.1 で詳しく定義する)。たとえば、樹脂の引張強度を特性値とし、成形温度を因子として 160 , 180 , 200 ∘ C 160,180,200\,{}^\circ\mathrm{C} 160 , 180 , 200 ∘ C
同じ水準で実験を繰り返しても、特性値は毎回少しずつ違う値になる。原料のロットの違い、測定器の読みの揺らぎ、室温の変化など、実験者が制御していない多くの原因が重なって生じるこのばらつきを誤差 と呼ぶ。実験計画法の問題は、水準を変えたときの特性値の違いが、誤差によるばらつきの範囲を超えているかどうかを判定することである。
実験は、おおよそ次の順序で進める。
実験の目的を決め、目的に合う特性値を選ぶ。
取り上げる因子と水準を決め、因子の数と実験回数の制約から配置(1元配置・2元配置・直交配列表・乱塊法など)を選ぶ。
実験の順序と割り付けを無作為に決めて実施し、データを分散分析で解析する。
最適と判断した条件での特性値を推定し、その条件で確認の実験をして推定が当たっているかを確かめる。
この解説の第2章以降は、このうち「配置を選ぶ」から「推定する」までの部分を、配置ごとに扱う。
Fisher の3原則
R. A. Fisher は、農業の圃場試験(区画に分けた畑で品種や肥料を比べる試験)の解析を通じて、実験の計画が満たすべき原則を3つにまとめた。反復 (replication)・無作為化 (randomization)・局所管理 (local control)である。3つの原則は、それぞれ誤差に対して異なる役割を担う。
定義 1.1(Fisher の3原則)
反復 :同じ処理(水準)の実験を2回以上行う。無作為化 :実験の順序や、実験の単位(試験片・区画・日)への処理の割り付けを、乱数で決める。局所管理 :実験の場を、内部では条件がそろっている小さなブロック (同じ日・同じロット・隣り合う区画)に分け、各ブロックの中で処理を比べる。
反復:誤差を推定し、平均の分散を小さくする
ある水準で r r r x 1 , … , x r x_1,\dots,x_r x 1 , … , x r N ( μ , σ 2 ) \mathrm{N}(\mu,\sigma^2) N ( μ , σ 2 )
第一に、反復があると誤差分散 σ 2 \sigma^2 σ 2 σ 2 \sigma^2 σ 2
V = ∑ j ( x j − x ˉ ) 2 r − 1 V=\frac{\sum_j(x_j-\bar x)^2}{r-1} V = r − 1 ∑ j ( x j − x ˉ ) 2
で、分母の自由度 r − 1 r-1 r − 1 r ≥ 2 r\ge2 r ≥ 2 a a a r r r
ϕ e = a ( r − 1 ) \phi_e=a(r-1) ϕ e = a ( r − 1 )
である(第2章 §2.2)。r = 1 r=1 r = 1 ϕ e = 0 \phi_e=0 ϕ e = 0
第二に、反復は平均の精度を上げる。水準平均 x ˉ \bar x x ˉ
V [ x ˉ ] = σ 2 r (1.1) V[\bar x]=\frac{\sigma^2}{r}\tag{1.1} V [ x ˉ ] = r σ 2 ( 1.1 )
で、r r r x ˉ 1 − x ˉ 2 \bar x_1-\bar x_2 x ˉ 1 − x ˉ 2 r r r
V [ x ˉ 1 − x ˉ 2 ] = 2 σ 2 r V[\bar x_1-\bar x_2]=\frac{2\sigma^2}{r} V [ x ˉ 1 − x ˉ 2 ] = r 2 σ 2
信頼区間の幅は標準偏差に比例するので、幅を半分にするには r r r
無作為化:系統的な影響による偏りを取り除く
実験を時間の順に行うと、室温・装置の温まり方・作業者の慣れなどが、実験の順番とともに少しずつ変わる。実験は N N N N N N k k k u k u_k u k
x k = μ ( k ) + u k + ε k (1.2) x_k=\mu_{(k)}+u_k+\varepsilon_k\tag{1.2} x k = μ ( k ) + u k + ε k ( 1.2 )
とおく。μ ( k ) \mu_{(k)} μ ( k ) k k k ε k \varepsilon_k ε k N ( 0 , σ 2 ) \mathrm{N}(0,\sigma^2) N ( 0 , σ 2 ) u k u_k u k u k = δ k u_k=\delta k u k = δ k
2水準を n n n N = 2 n N=2n N = 2 n A 1 A_1 A 1 A 2 A_2 A 2 x ˉ 1 − x ˉ 2 \bar x_1-\bar x_2 x ˉ 1 − x ˉ 2 u u u
一次の傾向なら、その差は − n δ -n\delta − n δ δ > 0 \delta>0 δ > 0 A 1 A_1 A 1 交絡 と呼ぶ。
無作為化は、どの枠にどの水準を割り付けるかを乱数で決める操作である。A 1 A_1 A 1 n n n ( N n ) \binom{N}{n} ( n N )
補題 1.2(無作為に選んだ枠の平均)
固定された値 u 1 , … , u N u_1,\dots,u_N u 1 , … , u N
u ˉ = 1 N ∑ k u k , s u 2 = 1 N ∑ k ( u k − u ˉ ) 2 \bar u=\frac1N\sum_k u_k,\qquad s_u^2=\frac1N\sum_k(u_k-\bar u)^2 u ˉ = N 1 k ∑ u k , s u 2 = N 1 k ∑ ( u k − u ˉ ) 2
この中から n n n u ˉ S \bar u_S u ˉ S
E [ u ˉ S ] = u ˉ , V [ u ˉ S ] = N − n N − 1 ⋅ s u 2 n . (1.3) E[\bar u_S]=\bar u,\qquad V[\bar u_S]=\frac{N-n}{N-1}\cdot\frac{s_u^2}{n}.\tag{1.3} E [ u ˉ S ] = u ˉ , V [ u ˉ S ] = N − 1 N − n ⋅ n s u 2 . ( 1.3 )
証明 k k k Z k Z_k Z k u ˉ S = 1 n ∑ k u k Z k \bar u_S=\frac1n\sum_k u_kZ_k u ˉ S = n 1 ∑ k u k Z k n / N n/N n / N E [ Z k ] = n / N E[Z_k]=n/N E [ Z k ] = n / N
E [ u ˉ S ] = 1 n ∑ k u k ⋅ n N = u ˉ . E[\bar u_S]=\frac1n\sum_k u_k\cdot\frac nN=\bar u. E [ u ˉ S ] = n 1 k ∑ u k ⋅ N n = u ˉ .
分散を求める。Z k 2 = Z k Z_k^2=Z_k Z k 2 = Z k V [ Z k ] = n N − n 2 N 2 = n ( N − n ) N 2 V[Z_k]=\frac nN-\frac{n^2}{N^2}=\frac{n(N-n)}{N^2} V [ Z k ] = N n − N 2 n 2 = N 2 n ( N − n ) k ≠ l k\neq l k = l n ( n − 1 ) N ( N − 1 ) \frac{n(n-1)}{N(N-1)} N ( N − 1 ) n ( n − 1 )
C o v ( Z k , Z l ) = n ( n − 1 ) N ( N − 1 ) − n 2 N 2 = n N ⋅ N ( n − 1 ) − n ( N − 1 ) N ( N − 1 ) = − n ( N − n ) N 2 ( N − 1 ) . \mathrm{Cov}(Z_k,Z_l)=\frac{n(n-1)}{N(N-1)}-\frac{n^2}{N^2}=\frac nN\cdot\frac{N(n-1)-n(N-1)}{N(N-1)}=-\frac{n(N-n)}{N^2(N-1)}. Cov ( Z k , Z l ) = N ( N − 1 ) n ( n − 1 ) − N 2 n 2 = N n ⋅ N ( N − 1 ) N ( n − 1 ) − n ( N − 1 ) = − N 2 ( N − 1 ) n ( N − n ) .
d k = u k − u ˉ d_k=u_k-\bar u d k = u k − u ˉ ∑ k d k = 0 \sum_k d_k=0 ∑ k d k = 0 ∑ k Z k = n \sum_k Z_k=n ∑ k Z k = n
∑ k u k Z k = ∑ k d k Z k + u ˉ ∑ k Z k = ∑ k d k Z k + n u ˉ \sum_k u_kZ_k=\sum_k d_kZ_k+\bar u\sum_k Z_k=\sum_k d_kZ_k+n\bar u k ∑ u k Z k = k ∑ d k Z k + u ˉ k ∑ Z k = k ∑ d k Z k + n u ˉ
となる。v = V [ Z k ] v=V[Z_k] v = V [ Z k ] c = C o v ( Z k , Z l ) c=\mathrm{Cov}(Z_k,Z_l) c = Cov ( Z k , Z l )
V [ ∑ k d k Z k ] = ∑ k d k 2 v + ∑ k ≠ l d k d l c = ( v − c ) ∑ k d k 2 + c ( ∑ k d k ) 2 = ( v − c ) N s u 2 . V\Bigl[\sum_k d_kZ_k\Bigr]=\sum_k d_k^2\,v+\sum_{k\neq l}d_kd_l\,c=(v-c)\sum_k d_k^2+c\Bigl(\sum_k d_k\Bigr)^2=(v-c)\,Ns_u^2. V [ k ∑ d k Z k ] = k ∑ d k 2 v + k = l ∑ d k d l c = ( v − c ) k ∑ d k 2 + c ( k ∑ d k ) 2 = ( v − c ) N s u 2 .
ここで v − c = n ( N − n ) N 2 ( 1 + 1 N − 1 ) = n ( N − n ) N ( N − 1 ) v-c=\frac{n(N-n)}{N^2}\bigl(1+\frac1{N-1}\bigr)=\frac{n(N-n)}{N(N-1)} v − c = N 2 n ( N − n ) ( 1 + N − 1 1 ) = N ( N − 1 ) n ( N − n ) V [ ∑ k u k Z k ] = n ( N − n ) N − 1 s u 2 V[\sum_k u_kZ_k]=\frac{n(N-n)}{N-1}s_u^2 V [ ∑ k u k Z k ] = N − 1 n ( N − n ) s u 2 n 2 n^2 n 2 (1.3) を得る。
補題を2水準の比較に使う。A 2 A_2 A 2 n n n
u ˉ S c = N u ˉ − n u ˉ S n = 2 u ˉ − u ˉ S \bar u_{S^c}=\frac{N\bar u-n\bar u_S}{n}=2\bar u-\bar u_S u ˉ S c = n N u ˉ − n u ˉ S = 2 u ˉ − u ˉ S
である。よって u ˉ S − u ˉ S c = 2 ( u ˉ S − u ˉ ) \bar u_S-\bar u_{S^c}=2(\bar u_S-\bar u) u ˉ S − u ˉ S c = 2 ( u ˉ S − u ˉ )
E [ u ˉ S − u ˉ S c ] = 0 , V [ u ˉ S − u ˉ S c ] = 4 V [ u ˉ S ] = 4 ( N − n ) N − 1 ⋅ s u 2 n . (1.4) E[\bar u_S-\bar u_{S^c}]=0,\qquad V[\bar u_S-\bar u_{S^c}]=4V[\bar u_S]=\frac{4(N-n)}{N-1}\cdot\frac{s_u^2}{n}.\tag{1.4} E [ u ˉ S − u ˉ S c ] = 0 , V [ u ˉ S − u ˉ S c ] = 4 V [ u ˉ S ] = N − 1 4 ( N − n ) ⋅ n s u 2 . ( 1.4 )
したがって、無作為化した実験では E [ x ˉ 1 − x ˉ 2 ] = μ 1 − μ 2 E[\bar x_1-\bar x_2]=\mu_1-\mu_2 E [ x ˉ 1 − x ˉ 2 ] = μ 1 − μ 2 u k u_k u k ε \varepsilon ε
系統的な影響 u k u_k u k x ˉ 1 − x ˉ 2 \bar x_1-\bar x_2 x ˉ 1 − x ˉ 2
例題 1.1 一次の傾向と無作為化 ★★
オリジナル 2水準 A 1 , A 2 A_1,A_2 A 1 , A 2 (1.2) の形で、傾向は u k = δ k u_k=\delta k u k = δ k k = 1 , … , 6 k=1,\dots,6 k = 1 , … , 6
(1) 順序 A 1 A 1 A 1 A 2 A 2 A 2 A_1A_1A_1A_2A_2A_2 A 1 A 1 A 1 A 2 A 2 A 2 E [ x ˉ 1 − x ˉ 2 ] E[\bar x_1-\bar x_2] E [ x ˉ 1 − x ˉ 2 ] (2) A 1 A_1 A 1 ( 6 3 ) = 20 \binom63=20 ( 3 6 ) = 20 E [ x ˉ 1 − x ˉ 2 ] E[\bar x_1-\bar x_2] E [ x ˉ 1 − x ˉ 2 ] V [ x ˉ 1 − x ˉ 2 ] V[\bar x_1-\bar x_2] V [ x ˉ 1 − x ˉ 2 ]
解答 (1) 2つの水準平均は次のようになる。
x ˉ 1 = μ 1 + δ ⋅ 1 + 2 + 3 3 + ε ˉ 1 = μ 1 + 2 δ + ε ˉ 1 , x ˉ 2 = μ 2 + δ ⋅ 4 + 5 + 6 3 + ε ˉ 2 = μ 2 + 5 δ + ε ˉ 2 . \begin{aligned}\bar x_1&=\mu_1+\delta\cdot\frac{1+2+3}{3}+\bar\varepsilon_1=\mu_1+2\delta+\bar\varepsilon_1,\\
\bar x_2&=\mu_2+\delta\cdot\frac{4+5+6}{3}+\bar\varepsilon_2=\mu_2+5\delta+\bar\varepsilon_2.\end{aligned} x ˉ 1 x ˉ 2 = μ 1 + δ ⋅ 3 1 + 2 + 3 + ε ˉ 1 = μ 1 + 2 δ + ε ˉ 1 , = μ 2 + δ ⋅ 3 4 + 5 + 6 + ε ˉ 2 = μ 2 + 5 δ + ε ˉ 2 .
よって E [ x ˉ 1 − x ˉ 2 ] = μ 1 − μ 2 − 3 δ E[\bar x_1-\bar x_2]=\mu_1-\mu_2-3\delta E [ x ˉ 1 − x ˉ 2 ] = μ 1 − μ 2 − 3 δ − 3 δ -3\delta − 3 δ
(2) u k = δ k u_k=\delta k u k = δ k
u ˉ = 3.5 δ , s u 2 = δ 2 ⋅ 1 6 ∑ k = 1 6 ( k − 3.5 ) 2 = δ 2 ⋅ 17.5 6 = 35 12 δ 2 . \bar u=3.5\delta,\qquad s_u^2=\delta^2\cdot\frac16\sum_{k=1}^6(k-3.5)^2=\delta^2\cdot\frac{17.5}{6}=\frac{35}{12}\delta^2. u ˉ = 3.5 δ , s u 2 = δ 2 ⋅ 6 1 k = 1 ∑ 6 ( k − 3.5 ) 2 = δ 2 ⋅ 6 17.5 = 12 35 δ 2 .
差を次のように3つに分ける。
x ˉ 1 − x ˉ 2 = ( μ 1 − μ 2 ) + ( u ˉ S − u ˉ S c ) + ( ε ˉ 1 − ε ˉ 2 ) \bar x_1-\bar x_2=(\mu_1-\mu_2)+(\bar u_S-\bar u_{S^c})+(\bar\varepsilon_1-\bar\varepsilon_2) x ˉ 1 − x ˉ 2 = ( μ 1 − μ 2 ) + ( u ˉ S − u ˉ S c ) + ( ε ˉ 1 − ε ˉ 2 )
(1.4) を N = 6 N=6 N = 6 n = 3 n=3 n = 3
E [ x ˉ 1 − x ˉ 2 ] = μ 1 − μ 2 , V [ u ˉ S − u ˉ S c ] = 4 ⋅ 3 5 ⋅ 35 δ 2 / 12 3 = 7 3 δ 2 . E[\bar x_1-\bar x_2]=\mu_1-\mu_2,\qquad V[\bar u_S-\bar u_{S^c}]=\frac{4\cdot3}{5}\cdot\frac{35\delta^2/12}{3}=\frac73\delta^2. E [ x ˉ 1 − x ˉ 2 ] = μ 1 − μ 2 , V [ u ˉ S − u ˉ S c ] = 5 4 ⋅ 3 ⋅ 3 35 δ 2 /12 = 3 7 δ 2 .
誤差の項 ε ˉ 1 − ε ˉ 2 \bar\varepsilon_1-\bar\varepsilon_2 ε ˉ 1 − ε ˉ 2 σ 2 / 3 + σ 2 / 3 = 2 σ 2 / 3 \sigma^2/3+\sigma^2/3=2\sigma^2/3 σ 2 /3 + σ 2 /3 = 2 σ 2 /3
V [ x ˉ 1 − x ˉ 2 ] = 2 σ 2 3 + 7 δ 2 3 . V[\bar x_1-\bar x_2]=\frac{2\sigma^2}{3}+\frac{7\delta^2}{3}. V [ x ˉ 1 − x ˉ 2 ] = 3 2 σ 2 + 3 7 δ 2 .
(検算:20 通りの選び方を全部書き出すと、u ˉ S − u ˉ S c \bar u_S-\bar u_{S^c} u ˉ S − u ˉ S c ± 3 δ \pm3\delta ± 3 δ 7 3 δ 2 \frac73\delta^2 3 7 δ 2 − 3 δ -3\delta − 3 δ 7 δ 2 / 3 7\delta^2/3 7 δ 2 /3
例題 1.1 の (2) で増えた分散 7 δ 2 / 3 7\delta^2/3 7 δ 2 /3 δ \delta δ
局所管理:ブロック間の変動を誤差から除く
実験の単位(試験片・区画・日)には、処理と無関係な個体差がある。j j j γ j \gamma_j γ j γ j \gamma_j γ j N ( 0 , σ R 2 ) \mathrm{N}(0,\sigma_R^2) N ( 0 , σ R 2 ) A 1 , A 2 A_1,A_2 A 1 , A 2 r r r
命題 1.3(ブロックを設けたときの差の分散)
(i) 完全無作為化 :2 r 2r 2 r r r r
x = μ i + γ ( 単位 ) + ε x=\mu_i+\gamma_{(\text{単位})}+\varepsilon x = μ i + γ ( 単位 ) + ε
このとき V [ x ˉ 1 − x ˉ 2 ] = 2 ( σ 2 + σ R 2 ) r V[\bar x_1-\bar x_2]=\dfrac{2(\sigma^2+\sigma_R^2)}{r} V [ x ˉ 1 − x ˉ 2 ] = r 2 ( σ 2 + σ R 2 )
(ii) ブロックを設ける :r r r A 1 , A 2 A_1,A_2 A 1 , A 2
x i j = μ i + γ j + ε i j x_{ij}=\mu_i+\gamma_j+\varepsilon_{ij} x ij = μ i + γ j + ε ij
このとき V [ x ˉ 1 − x ˉ 2 ] = 2 σ 2 r V[\bar x_1-\bar x_2]=\dfrac{2\sigma^2}{r} V [ x ˉ 1 − x ˉ 2 ] = r 2 σ 2
証明 (i) 各データは μ i \mu_i μ i γ + ε \gamma+\varepsilon γ + ε σ R 2 + σ 2 \sigma_R^2+\sigma^2 σ R 2 + σ 2 x ˉ 1 \bar x_1 x ˉ 1 x ˉ 2 \bar x_2 x ˉ 2 ( σ 2 + σ R 2 ) / r (\sigma^2+\sigma_R^2)/r ( σ 2 + σ R 2 ) / r
(ii) 2つの水準平均は次のようになる。
x ˉ 1 ⋅ = μ 1 + γ ˉ + ε ˉ 1 ⋅ , x ˉ 2 ⋅ = μ 2 + γ ˉ + ε ˉ 2 ⋅ \bar x_{1\cdot}=\mu_1+\bar\gamma+\bar\varepsilon_{1\cdot},\qquad \bar x_{2\cdot}=\mu_2+\bar\gamma+\bar\varepsilon_{2\cdot} x ˉ 1 ⋅ = μ 1 + γ ˉ + ε ˉ 1 ⋅ , x ˉ 2 ⋅ = μ 2 + γ ˉ + ε ˉ 2 ⋅
γ ˉ = 1 r ∑ j γ j \bar\gamma=\frac1r\sum_j\gamma_j γ ˉ = r 1 ∑ j γ j
x ˉ 1 ⋅ − x ˉ 2 ⋅ = μ 1 − μ 2 + ε ˉ 1 ⋅ − ε ˉ 2 ⋅ \bar x_{1\cdot}-\bar x_{2\cdot}=\mu_1-\mu_2+\bar\varepsilon_{1\cdot}-\bar\varepsilon_{2\cdot} x ˉ 1 ⋅ − x ˉ 2 ⋅ = μ 1 − μ 2 + ε ˉ 1 ⋅ − ε ˉ 2 ⋅
となって γ ˉ \bar\gamma γ ˉ 2 σ 2 / r 2\sigma^2/r 2 σ 2 / r
命題 1.3 は局所管理の効果を量で示している。ブロックの中で処理を比べると、ブロック間の個体差 σ R 2 \sigma_R^2 σ R 2 σ 2 \sigma^2 σ 2 ( σ 2 + σ R 2 ) / σ 2 (\sigma^2+\sigma_R^2)/\sigma^2 ( σ 2 + σ R 2 ) / σ 2
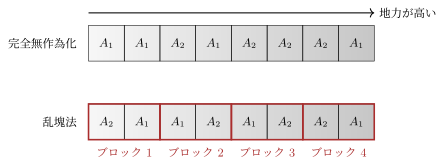
ブロックの中でどちらの処理を先に行うかは、ブロックごとに無作為に決める。これにより、ブロックの中に残る系統的な影響も偏りにならない。局所管理と無作為化を組み合わせたこの計画が乱塊法 で、第11章で扱う。
図 1.1 は、圃場試験での2つの計画を模式的に示している。畑の左から右へ地力が変わるとき、完全無作為化では地力の差が処理の比較に入るが、隣り合う区画をまとめたブロックの中で比べると、地力の差は比較に入らない。
図 1.1 8区画で2処理を比べる2つの計画。上は8区画に A 1 , A 2 A_1,A_2 A 1 , A 2 A 1 , A 2 A_1,A_2 A 1 , A 2
3原則の役割の分担
反復は誤差分散 σ 2 \sigma^2 σ 2 σ 2 / r \sigma^2/r σ 2 / r
確認テスト
オリジナル
1.1-1 Fisher の3原則を挙げ、それぞれが誤差に関して何を可能にするかを1文ずつで述べよ。1.1-2 2水準 A 1 , A 2 A_1,A_2 A 1 , A 2 k k k u k = δ k u_k=\delta k u k = δ k A 1 A 1 A 2 A 2 A_1A_1A_2A_2 A 1 A 1 A 2 A 2 A 1 A 2 A 2 A 1 A_1A_2A_2A_1 A 1 A 2 A 2 A 1 E [ x ˉ 1 − x ˉ 2 ] − ( μ 1 − μ 2 ) E[\bar x_1-\bar x_2]-(\mu_1-\mu_2) E [ x ˉ 1 − x ˉ 2 ] − ( μ 1 − μ 2 ) A 1 A_1 A 1 u ˉ S − u ˉ S c \bar u_S-\bar u_{S^c} u ˉ S − u ˉ S c 1.2 の両方で求めよ。1.1-3 ブロック間の個体差の分散が σ R 2 = 12 \sigma_R^2=12 σ R 2 = 12 σ 2 = 4 \sigma^2=4 σ 2 = 4 r = 5 r=5 r = 5 V [ x ˉ 1 − x ˉ 2 ] V[\bar x_1-\bar x_2] V [ x ˉ 1 − x ˉ 2 ] 1.1-4 誤差分散 σ 2 = 4 \sigma^2=4 σ 2 = 4 r r r μ 1 − μ 2 \mu_1-\mu_2 μ 1 − μ 2
x ˉ 1 − x ˉ 2 ± z 0.025 2 σ 2 / r \bar x_1-\bar x_2\pm z_{0.025}\sqrt{2\sigma^2/r} x ˉ 1 − x ˉ 2 ± z 0.025 2 σ 2 / r
の半幅を1以下にしたい。r r r z 0.025 = 1.960 z_{0.025}=1.960 z 0.025 = 1.960 1.1-5 確認テスト 1.1-2 の順序 A 1 A 2 A 2 A 1 A_1A_2A_2A_1 A 1 A 2 A 2 A 1 u k = δ k 2 u_k=\delta k^2 u k = δ k 2 E [ x ˉ 1 − x ˉ 2 ] − ( μ 1 − μ 2 ) E[\bar x_1-\bar x_2]-(\mu_1-\mu_2) E [ x ˉ 1 − x ˉ 2 ] − ( μ 1 − μ 2 )
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com