統計学の復習 第5章 §5.2 ★★★ 二項分布で n p = λ np=\lambda n p = λ n → ∞ n\to\infty n → ∞ λ \lambda λ λ \lambda λ
二項分布の極限としての導出
一定の時間内に起こる事故・問い合わせ・放射線の検出のように、「起こる機会は非常に多いが、1回1回の機会で起こる確率は非常に小さい」事象の回数を考える。時間を n n n p p p B i n ( n , p ) \mathrm{Bin}(n,p) Bin ( n , p ) n n n p p p n p np n p n p = λ np=\lambda n p = λ n → ∞ n\to\infty n → ∞
定理 5.3(ポアソンの少数の法則)
λ > 0 \lambda>0 λ > 0 k k k p = λ / n p=\lambda/n p = λ / n n → ∞ n\to\infty n → ∞
( n k ) ( λ n ) k ( 1 − λ n ) n − k ⟶ e − λ λ k k ! . \binom nk\Bigl(\frac\lambda n\Bigr)^k\Bigl(1-\frac\lambda n\Bigr)^{n-k}\ \longrightarrow\ \mathrm{e}^{-\lambda}\frac{\lambda^k}{k!}. ( k n ) ( n λ ) k ( 1 − n λ ) n − k ⟶ e − λ k ! λ k .
証明 n > λ n>\lambda n > λ n ≥ k n\ge k n ≥ k n ( n − 1 ) ⋯ ( n − k + 1 ) n(n-1)\cdots(n-k+1) n ( n − 1 ) ⋯ ( n − k + 1 ) n k n^k n k
( n k ) ( λ n ) k ( 1 − λ n ) n − k = ∏ j = 0 k − 1 ( 1 − j n ) ⏟ (a) ⋅ λ k k ! ⏟ (b) ⋅ ( 1 − λ n ) n ⏟ (c) ⋅ ( 1 − λ n ) − k ⏟ (d) . (5.6) \binom nk\Bigl(\frac\lambda n\Bigr)^k\Bigl(1-\frac\lambda n\Bigr)^{n-k}
=\underbrace{\prod_{j=0}^{k-1}\Bigl(1-\frac jn\Bigr)}_{\text{(a)}}\cdot\underbrace{\frac{\lambda^k}{k!}}_{\text{(b)}}\cdot\underbrace{\Bigl(1-\frac\lambda n\Bigr)^{n}}_{\text{(c)}}\cdot\underbrace{\Bigl(1-\frac\lambda n\Bigr)^{-k}}_{\text{(d)}}.\tag{5.6} ( k n ) ( n λ ) k ( 1 − n λ ) n − k = (a) j = 0 ∏ k − 1 ( 1 − n j ) ⋅ (b) k ! λ k ⋅ (c) ( 1 − n λ ) n ⋅ (d) ( 1 − n λ ) − k . ( 5.6 )
実際、( n k ) λ k n k = n ( n − 1 ) ⋯ ( n − k + 1 ) n k ⋅ λ k k ! \binom nk\dfrac{\lambda^k}{n^k}=\dfrac{n(n-1)\cdots(n-k+1)}{n^k}\cdot\dfrac{\lambda^k}{k!} ( k n ) n k λ k = n k n ( n − 1 ) ⋯ ( n − k + 1 ) ⋅ k ! λ k n n ⋅ n − 1 n ⋯ n − k + 1 n = ∏ j = 0 k − 1 ( 1 − j / n ) \dfrac nn\cdot\dfrac{n-1}n\cdots\dfrac{n-k+1}n=\prod_{j=0}^{k-1}(1-j/n) n n ⋅ n n − 1 ⋯ n n − k + 1 = ∏ j = 0 k − 1 ( 1 − j / n )
(a) は k k k k k k n n n 1 − j / n 1-j/n 1 − j / n n → ∞ n\to\infty n → ∞ 1 1 1 1 1 1 n n n
(b) は n n n
(c) は底が 1 1 1 ∞ \infty ∞ 1 ∞ 1^\infty 1 ∞ n log ( 1 − λ / n ) n\log(1-\lambda/n) n log ( 1 − λ / n ) x = λ / n x=\lambda/n x = λ / n
n log ( 1 − λ n ) = − λ ⋅ log ( 1 − x ) − x . n\log\Bigl(1-\frac\lambda n\Bigr)=-\lambda\cdot\frac{\log(1-x)}{-x}. n log ( 1 − n λ ) = − λ ⋅ − x log ( 1 − x ) .
log ( 1 − x ) \log(1-x) log ( 1 − x ) x = 0 x=0 x = 0 − 1 -1 − 1 log ( 1 − x ) − log 1 x → − 1 \dfrac{\log(1-x)-\log1}{x}\to-1 x log ( 1 − x ) − log 1 → − 1 log ( 1 − x ) − x → 1 \dfrac{\log(1-x)}{-x}\to1 − x log ( 1 − x ) → 1 x → 0 x\to0 x → 0 n log ( 1 − λ / n ) → − λ n\log(1-\lambda/n)\to-\lambda n log ( 1 − λ / n ) → − λ e − λ \mathrm{e}^{-\lambda} e − λ
(d) は指数 − k -k − k 1 1 1 1 1 1
4つの極限を掛けて 1 ⋅ λ k k ! ⋅ e − λ ⋅ 1 1\cdot\dfrac{\lambda^k}{k!}\cdot\mathrm{e}^{-\lambda}\cdot1 1 ⋅ k ! λ k ⋅ e − λ ⋅ 1
極限で現れた e − λ λ k / k ! \mathrm{e}^{-\lambda}\lambda^k/k! e − λ λ k / k ! e λ = ∑ k = 0 ∞ λ k / k ! \mathrm{e}^\lambda=\sum_{k=0}^\infty\lambda^k/k! e λ = ∑ k = 0 ∞ λ k / k ! ∑ k e − λ λ k / k ! = e − λ e λ = 1 \sum_k\mathrm{e}^{-\lambda}\lambda^k/k!=\mathrm{e}^{-\lambda}\mathrm{e}^{\lambda}=1 ∑ k e − λ λ k / k ! = e − λ e λ = 1
定義 5.4(ポアソン分布)
λ > 0 \lambda>0 λ > 0
P ( X = k ) = e − λ λ k k ! ( k = 0 , 1 , 2 , … ) (5.7) P(X=k)=\mathrm{e}^{-\lambda}\frac{\lambda^k}{k!}\qquad(k=0,1,2,\dots)\tag{5.7} P ( X = k ) = e − λ k ! λ k ( k = 0 , 1 , 2 , … ) ( 5.7 )
で与えられる分布をポアソン分布 と呼び、X ∼ P o ( λ ) X\sim\mathrm{Po}(\lambda) X ∼ Po ( λ )
定理 5.3 は、二項分布の計算をポアソン分布で近似してよい理由であると同時に、ポアソン分布が「独立に、一定の割合で、まれに起こる事象の回数」を表す理由でもある。時間を細かく切っていく上の議論は、待ち時間の分布(指数分布)とあわせてポアソン過程と呼ばれる。指数分布は第6章で、ポアソン過程は数理統計の解説 第12章 §12.1 で扱う。
期待値と分散、λ \lambda λ
定理 5.5(ポアソン分布の期待値と分散)
X ∼ P o ( λ ) X\sim\mathrm{Po}(\lambda) X ∼ Po ( λ ) E [ X ] = V [ X ] = λ E[X]=V[X]=\lambda E [ X ] = V [ X ] = λ G X ( s ) = e λ ( s − 1 ) G_X(s)=\mathrm{e}^{\lambda(s-1)} G X ( s ) = e λ ( s − 1 )
証明 k = 0 k=0 k = 0 0 0 0 k ≥ 1 k\ge1 k ≥ 1 k / k ! = 1 / ( k − 1 ) ! k/k!=1/(k-1)! k / k ! = 1/ ( k − 1 )! j = k − 1 j=k-1 j = k − 1
E [ X ] = ∑ k = 1 ∞ k e − λ λ k k ! = λ e − λ ∑ k = 1 ∞ λ k − 1 ( k − 1 ) ! = λ e − λ ∑ j = 0 ∞ λ j j ! = λ . E[X]=\sum_{k=1}^\infty k\,\mathrm{e}^{-\lambda}\frac{\lambda^k}{k!}=\lambda\mathrm{e}^{-\lambda}\sum_{k=1}^\infty\frac{\lambda^{k-1}}{(k-1)!}=\lambda\mathrm{e}^{-\lambda}\sum_{j=0}^\infty\frac{\lambda^j}{j!}=\lambda. E [ X ] = k = 1 ∑ ∞ k e − λ k ! λ k = λ e − λ k = 1 ∑ ∞ ( k − 1 )! λ k − 1 = λ e − λ j = 0 ∑ ∞ j ! λ j = λ .
同じ手順で k ( k − 1 ) / k ! = 1 / ( k − 2 ) ! k(k-1)/k!=1/(k-2)! k ( k − 1 ) / k ! = 1/ ( k − 2 )! k ≥ 2 k\ge2 k ≥ 2 E [ X ( X − 1 ) ] = λ 2 E[X(X-1)]=\lambda^2 E [ X ( X − 1 )] = λ 2 V [ X ] = λ 2 + λ − λ 2 = λ V[X]=\lambda^2+\lambda-\lambda^2=\lambda V [ X ] = λ 2 + λ − λ 2 = λ G X ( s ) = ∑ k e − λ ( λ s ) k / k ! = e − λ e λ s = e λ ( s − 1 ) G_X(s)=\sum_k\mathrm{e}^{-\lambda}(\lambda s)^k/k!=\mathrm{e}^{-\lambda}\mathrm{e}^{\lambda s}=\mathrm{e}^{\lambda(s-1)} G X ( s ) = ∑ k e − λ ( λ s ) k / k ! = e − λ e λ s = e λ ( s − 1 ) G X ′ ( 1 ) = λ G_X'(1)=\lambda G X ′ ( 1 ) = λ G X ′ ′ ( 1 ) = λ 2 G_X''(1)=\lambda^2 G X ′′ ( 1 ) = λ 2
平均と分散が等しいことは、二項分布の極限として見ると自然である。B i n ( n , p ) \mathrm{Bin}(n,p) Bin ( n , p ) n p ( 1 − p ) = λ ( 1 − p ) np(1-p)=\lambda(1-p) n p ( 1 − p ) = λ ( 1 − p ) p → 0 p\to0 p → 0 1 − p 1-p 1 − p 1 1 1 λ \lambda λ 過分散 と呼ぶ。
λ \lambda λ 3 3 3 λ = 1.5 \lambda=1.5 λ = 1.5 λ = 9 \lambda=9 λ = 9 λ \lambda λ
再生性と、和を条件にしたときの分布
定理 5.6(ポアソン分布の再生性)
X ∼ P o ( λ ) X\sim\mathrm{Po}(\lambda) X ∼ Po ( λ ) Y ∼ P o ( μ ) Y\sim\mathrm{Po}(\mu) Y ∼ Po ( μ ) X + Y ∼ P o ( λ + μ ) X+Y\sim\mathrm{Po}(\lambda+\mu) X + Y ∼ Po ( λ + μ ) X + Y = n X+Y=n X + Y = n X X X B i n ( n , λ / ( λ + μ ) ) \mathrm{Bin}\bigl(n,\lambda/(\lambda+\mu)\bigr) Bin ( n , λ / ( λ + μ ) )
証明 X + Y = n X+Y=n X + Y = n X = j X=j X = j Y = n − j Y=n-j Y = n − j j = 0 , … , n j=0,\dots,n j = 0 , … , n
P ( X + Y = n ) = ∑ j = 0 n e − λ λ j j ! e − μ μ n − j ( n − j ) ! = e − ( λ + μ ) n ! ∑ j = 0 n n ! j ! ( n − j ) ! λ j μ n − j = e − ( λ + μ ) ( λ + μ ) n n ! . P(X+Y=n)=\sum_{j=0}^n\mathrm{e}^{-\lambda}\frac{\lambda^j}{j!}\,\mathrm{e}^{-\mu}\frac{\mu^{n-j}}{(n-j)!}
=\frac{\mathrm{e}^{-(\lambda+\mu)}}{n!}\sum_{j=0}^n\frac{n!}{j!\,(n-j)!}\lambda^j\mu^{n-j}=\mathrm{e}^{-(\lambda+\mu)}\frac{(\lambda+\mu)^n}{n!}. P ( X + Y = n ) = j = 0 ∑ n e − λ j ! λ j e − μ ( n − j )! μ n − j = n ! e − ( λ + μ ) j = 0 ∑ n j ! ( n − j )! n ! λ j μ n − j = e − ( λ + μ ) n ! ( λ + μ ) n .
最後の等号は二項定理である。これは P o ( λ + μ ) \mathrm{Po}(\lambda+\mu) Po ( λ + μ ) e λ ( s − 1 ) e μ ( s − 1 ) = e ( λ + μ ) ( s − 1 ) \mathrm{e}^{\lambda(s-1)}\mathrm{e}^{\mu(s-1)}=\mathrm{e}^{(\lambda+\mu)(s-1)} e λ ( s − 1 ) e μ ( s − 1 ) = e ( λ + μ ) ( s − 1 ) { X = j } ∩ { X + Y = n } = { X = j } ∩ { Y = n − j } \{X=j\}\cap\{X+Y=n\}=\{X=j\}\cap\{Y=n-j\} { X = j } ∩ { X + Y = n } = { X = j } ∩ { Y = n − j }
P ( X = j ∣ X + Y = n ) = e − λ λ j / j ! ⋅ e − μ μ n − j / ( n − j ) ! e − ( λ + μ ) ( λ + μ ) n / n ! = ( n j ) ( λ λ + μ ) j ( μ λ + μ ) n − j . □ P(X=j\mid X+Y=n)=\frac{\mathrm{e}^{-\lambda}\lambda^j/j!\cdot\mathrm{e}^{-\mu}\mu^{n-j}/(n-j)!}{\mathrm{e}^{-(\lambda+\mu)}(\lambda+\mu)^n/n!}
=\binom nj\Bigl(\frac{\lambda}{\lambda+\mu}\Bigr)^j\Bigl(\frac{\mu}{\lambda+\mu}\Bigr)^{n-j}.\quad\square P ( X = j ∣ X + Y = n ) = e − ( λ + μ ) ( λ + μ ) n / n ! e − λ λ j / j ! ⋅ e − μ μ n − j / ( n − j )! = ( j n ) ( λ + μ λ ) j ( λ + μ μ ) n − j . □
再生性から、1時間の件数が P o ( λ ) \mathrm{Po}(\lambda) Po ( λ ) P o ( 2 λ ) \mathrm{Po}(2\lambda) Po ( 2 λ ) m m m P o ( m λ ) \mathrm{Po}(m\lambda) Po ( mλ ) λ \lambda λ n n n X X X λ / ( λ + μ ) \lambda/(\lambda+\mu) λ / ( λ + μ ) X X X
例題 5.3 窓口の件数:範囲の換算・余事象・和の条件付き分布 ★★★
オリジナル ある窓口には問い合わせが1時間あたり平均 1.8 1.8 1.8 0.8 0.8 0.8 1.2 1.2 1.2
最初の窓口に、ある40分間で2件以上来る確率を求めよ。
窓口 A・B の合計で、ある1時間にちょうど3件来る確率を求めよ。
ある1時間に A・B の合計がちょうど3件だったと分かったとき、そのうち A に来たのが1件である条件付き確率を求めよ。
解答 (1) 40分は 2 / 3 2/3 2/3 λ = 1.8 × 2 3 = 1.2 \lambda=1.8\times\frac23=1.2 λ = 1.8 × 3 2 = 1.2 X X X X ∼ P o ( 1.2 ) X\sim\mathrm{Po}(1.2) X ∼ Po ( 1.2 )
P ( X ≥ 2 ) = 1 − e − 1.2 ( 1 + 1.2 ) = 1 − 0.30119 × 2.2 = 1 − 0.66263 = 0.3374. P(X\ge2)=1-\mathrm{e}^{-1.2}(1+1.2)=1-0.30119\times2.2=1-0.66263=0.3374. P ( X ≥ 2 ) = 1 − e − 1.2 ( 1 + 1.2 ) = 1 − 0.30119 × 2.2 = 1 − 0.66263 = 0.3374.
(2) 定理 5.6 から合計は P o ( 0.8 + 1.2 ) = P o ( 2 ) \mathrm{Po}(0.8+1.2)=\mathrm{Po}(2) Po ( 0.8 + 1.2 ) = Po ( 2 )
P ( 合計 = 3 ) = e − 2 2 3 3 ! = 0.135335 × 8 6 = 0.1804. P(\text{合計}=3)=\mathrm{e}^{-2}\frac{2^3}{3!}=0.135335\times\frac86=0.1804. P ( 合計 = 3 ) = e − 2 3 ! 2 3 = 0.135335 × 6 8 = 0.1804.
(3) 定理 5.6 の後半から、合計が3件という条件の下で A の件数は B i n ( 3 , 0.8 / 2.0 ) = B i n ( 3 , 0.4 ) \mathrm{Bin}(3,\,0.8/2.0)=\mathrm{Bin}(3,0.4) Bin ( 3 , 0.8/2.0 ) = Bin ( 3 , 0.4 )
P ( A = 1 ∣ 合計 = 3 ) = ( 3 1 ) 0.4 × 0.6 2 = 3 × 0.4 × 0.36 = 0.432. P(A=1\mid\text{合計}=3)=\binom31\,0.4\times0.6^2=3\times0.4\times0.36=0.432. P ( A = 1 ∣ 合計 = 3 ) = ( 1 3 ) 0.4 × 0. 6 2 = 3 × 0.4 × 0.36 = 0.432.
これは1時間あたりの平均 0.8 0.8 0.8 1.2 1.2 1.2
近似の精度と使い分け
定理 5.3 は極限の主張なので、有限の n n n n = 100 n=100 n = 100 p = 0.03 p=0.03 p = 0.03 P o ( 3 ) \mathrm{Po}(3) Po ( 3 )
例題 5.4 二項分布とポアソン近似の比較 ★★
オリジナル ある大量生産品の不良率は 0.03 0.03 0.03 X X X
P ( X ≤ 2 ) P(X\le2) P ( X ≤ 2 ) 同じ確率をポアソン分布で近似して計算し、相対誤差を求めよ。
解答 (1) X ∼ B i n ( 100 , 0.03 ) X\sim\mathrm{Bin}(100,0.03) X ∼ Bin ( 100 , 0.03 ) 0.97 98 = 0.0505394 0.97^{98}=0.0505394 0.9 7 98 = 0.0505394 0.97 99 = 0.0490232 0.97^{99}=0.0490232 0.9 7 99 = 0.0490232 0.97 100 = 0.0475525 0.97^{100}=0.0475525 0.9 7 100 = 0.0475525
P ( X = 0 ) = 0.97 100 = 0.047553 , P ( X = 1 ) = 100 × 0.03 × 0.97 99 = 3 × 0.0490232 = 0.147070 , P ( X = 2 ) = ( 100 2 ) 0.03 2 0.97 98 = 4950 × 0.0009 × 0.0505394 = 0.225153. \begin{aligned}
P(X=0)&=0.97^{100}=0.047553,\\
P(X=1)&=100\times0.03\times0.97^{99}=3\times0.0490232=0.147070,\\
P(X=2)&=\binom{100}2\,0.03^2\,0.97^{98}=4950\times0.0009\times0.0505394=0.225153.
\end{aligned} P ( X = 0 ) P ( X = 1 ) P ( X = 2 ) = 0.9 7 100 = 0.047553 , = 100 × 0.03 × 0.9 7 99 = 3 × 0.0490232 = 0.147070 , = ( 2 100 ) 0.0 3 2 0.9 7 98 = 4950 × 0.0009 × 0.0505394 = 0.225153.
足して P ( X ≤ 2 ) = 0.41978 P(X\le2)=0.41978 P ( X ≤ 2 ) = 0.41978
(2) λ = n p = 3 \lambda=np=3 λ = n p = 3
P ( X ≤ 2 ) ≈ e − 3 ( 1 + 3 + 3 2 2 ) = 0.049787 × 8.5 = 0.42319. P(X\le2)\approx\mathrm{e}^{-3}\Bigl(1+3+\frac{3^2}{2}\Bigr)=0.049787\times8.5=0.42319. P ( X ≤ 2 ) ≈ e − 3 ( 1 + 3 + 2 3 2 ) = 0.049787 × 8.5 = 0.42319.
相対誤差は ( 0.42319 − 0.41978 ) / 0.41978 = 0.0081 (0.42319-0.41978)/0.41978=0.0081 ( 0.42319 − 0.41978 ) /0.41978 = 0.0081 0.8 % 0.8\% 0.8% P ( X = 0 ) P(X=0) P ( X = 0 ) 0.0476 0.0476 0.0476 0.0498 0.0498 0.0498 3 3 3 100 × 0.03 × 0.97 = 2.91 100\times0.03\times0.97=2.91 100 × 0.03 × 0.97 = 2.91 0 0 0
近似の誤差について、Le Cam の不等式と呼ばれる次の評価が知られている。B i n ( n , p ) \mathrm{Bin}(n,p) Bin ( n , p ) P o ( n p ) \mathrm{Po}(np) Po ( n p ) k k k 2 n p 2 2np^2 2 n p 2 5.4 では上界が 2 × 100 × 0.03 2 = 0.18 2\times100\times0.03^2=0.18 2 × 100 × 0.0 3 2 = 0.18 0.015 0.015 0.015 n p = λ np=\lambda n p = λ 2 n p 2 = 2 λ p 2np^2=2\lambda p 2 n p 2 = 2 λ p p p p n ≥ 50 n\ge50 n ≥ 50 n p ≤ 5 np\le5 n p ≤ 5 n p np n p n ( 1 − p ) n(1-p) n ( 1 − p )
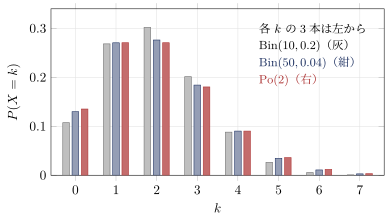
図 5.1 平均を 2 2 2 B i n ( 10 , 0.2 ) \mathrm{Bin}(10,0.2) Bin ( 10 , 0.2 ) B i n ( 50 , 0.04 ) \mathrm{Bin}(50,0.04) Bin ( 50 , 0.04 ) P o ( 2 ) \mathrm{Po}(2) Po ( 2 ) n n n p p p n = 10 n=10 n = 10 k = 2 k=2 k = 2 0.03 0.03 0.03 1.6 1.6 1.6 2 2 2
確認テスト
オリジナル
5.2-1 X ∼ P o ( λ ) X\sim\mathrm{Po}(\lambda) X ∼ Po ( λ ) P ( X = k ) / P ( X = k − 1 ) P(X=k)/P(X=k-1) P ( X = k ) / P ( X = k − 1 ) λ = 3.5 \lambda=3.5 λ = 3.5 λ = 3 \lambda=3 λ = 3 5.2-2 ある本では誤植が1頁あたり平均 0.5 0.5 0.5 5.2-3 X ∼ P o ( λ ) X\sim\mathrm{Po}(\lambda) X ∼ Po ( λ ) E [ X ( X − 1 ) ] = λ 2 E[X(X-1)]=\lambda^2 E [ X ( X − 1 )] = λ 2 5.2-4 ある店の1日の来客数 N N N P o ( λ ) \mathrm{Po}(\lambda) Po ( λ ) p p p Y Y Y P ( Y = y ) = ∑ n ≥ y P ( N = n ) ( n y ) p y ( 1 − p ) n − y P(Y=y)=\sum_{n\ge y}P(N=n)\binom nyp^y(1-p)^{n-y} P ( Y = y ) = ∑ n ≥ y P ( N = n ) ( y n ) p y ( 1 − p ) n − y Y ∼ P o ( λ p ) Y\sim\mathrm{Po}(\lambda p) Y ∼ Po ( λ p )
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com