確率論入門 第12章 §12.4 ★★★ 期待値・積分を乱数の平均で近似する Monte Carlo 法と、標本から分布関数全体を一様に推定する Glivenko–Cantelli の定理
Monte Carlo 積分
d 次元の立方体の上の可積分な関数 g について、次の積分を数値的に求めたいとする。
I=∫[0,1]dgdLeb
U1,U2,… を、立方体の上の一様分布に従う独立同分布の確率ベクトルとする。第5章 §5.3 の変数変換公式から、E[g(U1)]=I である。そこで
I^n=n1k=1∑ng(Uk)(12.12)
を積分の推定値とする。これが Monte Carlo 積分である。各項 g(Uk) は独立同分布で、E[∣g(U1)∣]=∫∣g∣<∞ である。よって Kolmogorov の強法則(定理 12.6)から、I^n→I a.s. となる。
誤差の大きさは分散で測る。次の分散が有限であるとする。
σg2=V[g(U1)]=∫g2−I2<∞
このとき推定値の平均は I、分散は σg2/n であり、
E[(I^n−I)2]=nσg,P(I^n−I≥ncσg)≤c21(12.13)
となる(2つ目は Chebyshev の不等式)。誤差が n−1/2 に比例し、その係数が次元によらないことが Monte Carlo 法の特徴である。
格子点で関数値をとる台形公式と比べる。格子点を d 次元に並べると、1辺あたりの点の数は n1/d になる。よって台形公式の誤差は n−2/d の程度になり、5次元以上では Monte Carlo の n−1/2 より遅くなる。
実際の計算では σg も未知である。そこで同じ乱数から、次の量で推定する。
σ^n2=n1k∑(g(Uk)−I^n)2
確認テスト 12.1-4 と同じ議論(強法則版)から、σ^n2→σg2 a.s. である。(12.13) の確率の評価は、第13章の中心極限定理で精密になる。
P(I^n−I≥n1.96σg)→0.05
一様分布でない分布 f に関する期待値 E[h(X)] も、同じ分布の乱数を作れれば同じ方法で求まる。乱数の作り方には、第3章 §3.5 の逆変換法 F−1(U) や、第7章 §7.2 の Box–Muller 法がある。
重点抽出
- f を密度とし、∫gfdx を求める。別の密度 q を用意する(gf=0 の所で正とする)。そこから独立に Y1,Y2,… を作り、
I~n=n1k=1∑nq(Yk)g(Yk)f(Yk)
と置く。各項の期待値は E[g(Y)f(Y)/q(Y)]=∫gfdx である。よって強法則から、I~n は確率 1 で求める積分に収束する(確認テスト 12.4-4)。これを重点抽出と呼ぶ。
- 第5章 §5.3 の測度の作り替え Q(A)=E[Z;A] を、密度の比 f/q を重みとして使う形である。q を ∣g∣f に近い形に選ぶと、分散が小さくなる。
例題 12.7 円周率の Monte Carlo 推定 ★★
オリジナルU=(U,V) を [0,1]2 上の一様分布に従う確率ベクトルとする。
- 次の推定値について、ほとんど確実な極限と分散 V[π^n] を求めよ。
g1(u,v)=4⋅1{u2+v2≤1},π^n=n1k∑g1(Uk)
P(∣π^n−π∣≥0.01)≤0.05 を Chebyshev の不等式で保証するのに必要な、最小の n を求めよ。2. 1変数の関数による次の推定値の分散を求めよ。
g2(u)=41−u2,π~n=n1k∑g2(Uk)
(1) と比べて、同じ精度に必要な試行回数が何分の1になるかを答えよ。
解答
- 期待値は次のとおりである。
E[g1(U)]=4Leb({u2+v2≤1, u,v≥0})=4⋅4π=π
よって強法則から、π^n→π a.s. である。g1(U)/4 は Ber(π/4) に従うので、分散は次のとおりである。
V[g1(U)]=16⋅4π(1−4π)=π(4−π)≈2.6968,V[π^n]=nπ(4−π)
Chebyshev の不等式から
P(∣π^n−π∣≥0.01)≤n⋅10−4π(4−π)≤0.05⟺n≥5×10⁻⁶π(4−π)≈539353.5
なので、最小の n は 539354 である。2. 期待値と2乗の期待値は次のとおりである(前者は4分の1円の面積の4倍)。
E[g2(U)]=4∫011−u2du=π,E[g2(U)2]=16∫01(1−u2)du=332
よって
V[g2(U)]=332−π2≈0.7971
である。必要な n は分散に比例するので、比は 0.7971/2.6968≈0.296、つまり約 3.4 分の1で済む。g1 は「円の内か外か」という0か4の値しかとらない粗い関数で、v の方向の積分を乱数に任せている。その方向について先に正確に積分した g2 の方が、揺れが小さい。
経験分布関数と Glivenko–Cantelli の定理
X1,X2,… を分布関数 F の独立同分布の列とする。最初の n 個の観測値から作る
Fn(x)=n1k=1∑n1{Xk≤x}=n#{k≤n:Xk≤x}(x∈R)(12.14)
を経験分布関数と呼ぶ。これは観測値の各点で高さ 1/n ずつ跳ぶ階段関数である。それ自体が1つの分布関数(観測値に等しい重みを置いた離散分布の分布関数)でもある。
点 x を固定すると、1{Xk≤x} は独立同分布で、期待値がその点の分布関数の値に等しい有界な確率変数である。よって強法則から、Fn(x)→F(x) a.s. である。同じく 1{Xk<x} に強法則を使うと、左極限についても次が成り立つ。
Fn(x−)=n1#{k≤n:Xk<x}→F(x−)=P(X1<x)a.s.
しかし確率 1 の事象は点ごとに違い、点は非可算個ある。よってこのままでは「すべての点で同時に」収束すると結論することはできない。分布関数の単調性を使うと、有限個の点での収束から一様収束が得られる。
定理 12.12(Glivenko–Cantelli の定理)
X1,X2,… が、分布関数 F の独立同分布の列とする。このとき
Dn=x∈Rsup∣Fn(x)−F(x)∣→0a.s.
証明
自然数 m を固定する。第3章 §3.5 の一般化逆関数 F−1(u)=inf{x:F(x)≥u} を使い、分点を次のように置く。
tj=F−1(j/m)(j=1,…,m−1)
さらに t0=−∞、tm=+∞ とする。端点では次のように約束する。
F(−∞)=Fn(−∞)=0,F(+∞−)=Fn(+∞−)=1
0<j/m<1 だから、分点 t1≤⋯≤tm−1 は有限の実数である。第3章の補題 F−1(u)≤x⟺u≤F(x) から、次の2つが成り立つ。
- x=tj とすると、j/m≤F(tj) である。
- x<tj なら、F−1(j/m)>x である。よって F(x)<j/m である。左から近づけて、F(tj−)≤j/m を得る。
2つを合わせると、j=1,…,m で次が成り立つ(両端では約束した値で確かめられる)。
F(tj−)−F(tj−1)≤mj−mj−1=m1
有限個の点での最大のずれを
Δn=0≤j≤mmax(∣Fn(tj)−F(tj)∣+∣Fn(tj−)−F(tj−)∣)
と置く(両端の項は約束により 0)。各項は強法則によって 0 に近づく。よって 2(m−1) 個の確率 1 の事象の共通部分の上で、Δn→0 である。
任意の実数は、ある j について tj−1≤x<tj を満たす(空の区間は飛ばす)。2つの分布関数は単調非減少だから
Fn(x)≤Fn(tj−)≤F(tj−)+Δn≤F(tj−1)+m1+Δn≤F(x)+m1+Δn,
Fn(x)≥Fn(tj−1)≥F(tj−1)−Δn≥F(tj−)−m1−Δn≥F(x)−m1−Δn
である。したがって Dn≤m1+Δn で、limsupnDn≤m1 a.s. となる。m=1,2,… に対する可算個の確率 1 の事象の共通部分の上で、上極限は 0 である。
分布関数が連続なら、Dn は観測値を小さい順に並べた X(1)≤⋯≤X(n) を使って、有限回の計算で求まる。経験分布関数は区間 [X(i),X(i+1)) の上で一定値 i/n をとる。真の分布関数は単調なので、ずれの上限は跳びの直前か直後で達成される。
Dn=1≤i≤nmaxmax(ni−F(X(i)), F(X(i))−ni−1)(12.15)
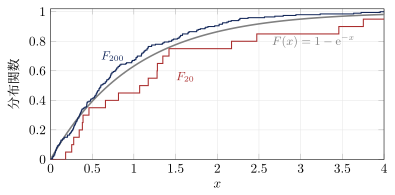
図 12.3 Ex(1) からの標本の経験分布関数 F20(赤)と F200(青)、および真の分布関数 F(灰色の太線)。この見本では D20≈0.207、D200≈0.075 で、n を増やすと階段が F に一様に近づく。
収束の速さ
- 各点のずれ。固定した点では nFn(x)∼Bin(n,F(x)) である(確認テスト 12.4-1)。よって経験分布関数の値の標準偏差は次のとおりである。
nF(x)(1−F(x))≤2n1
- 一様なずれ。Dn についても、Dvoretzky–Kiefer–Wolfowitz の不等式が成り立つ(定数 2 は P. Massart による)。
P(Dn>ε)≤2e−2nε2
よって一様なずれも、およそ n−1/2 の大きさである。
- 極限分布。分布関数が連続なら、nDn の分布は F によらない極限分布(Kolmogorov 分布)に近づく。これは分布の当てはまりを調べる Kolmogorov–Smirnov 検定の基礎になる。
例題 12.8 小さな標本の Dn ★
オリジナル指数分布に従うと考えられる5個の観測値 0.2, 0.5, 0.9, 1.4, 2.3 がある。F(x)=1−e−x との一様なずれ D5 を求め、上限が達成される位置を答えよ。
解答
観測値はすでに小さい順に並んでいる。F(X(i))=1−e−X(i) を計算し、(12.15) の2つの量を並べると次の表になる(小数第4位まで)。
| i | X(i) | F(X(i)) | ni−F(X(i)) | F(X(i))−ni−1 |
| 1 | 0.2 | 0.1813 | 0.0187 | 0.1813 |
| 2 | 0.5 | 0.3935 | 0.0065 | 0.1935 |
| 3 | 0.9 | 0.5934 | 0.0066 | 0.1934 |
| 4 | 1.4 | 0.7534 | 0.0466 | 0.1534 |
| 5 | 2.3 | 0.8997 | 0.1003 | 0.0997 |
最大値は i=2 の右の列の 0.1935 で、D5=1−e−0.5−0.2≈0.1935 である。これは点 0.5 の直前で、F5(0.5−)=0.2 と F(0.5)=0.3935 のあいだの差として達成される。真の分布関数は連続で、経験分布関数はそこで左極限をとる。よって上限は点 0.5 に左から近づく極限で達成され、最大値としてはとられない。
確認テスト
オリジナル
- 12.4-1 点 x を固定すると、nFn(x)∼Bin(n,F(x)) であることを説明せよ。また E[Fn(x)] と V[Fn(x)] を求めよ。
- 12.4-2 積分 I=∫01exdx を、次の推定値で推定する(Uk は独立な一様乱数)。
I^n=n1k∑eUk
分散 σ2=V[eU1] を求めよ。E[(I^n−I)2]≤0.001 となる最小の n を求めよ。3. 12.4-3 12.4-2 で、U と 1−U の組を使う次の推定値を考える(対称変量法)。
Iˇn=n1k=1∑n21(eUk+e1−Uk)
分散 V[21(eU+e1−U)] を求めよ。この推定値は関数の値を 2n 回計算する。同じ回数を使う I^2n と分散を比べよ。4. 12.4-4 密度 f と q をとる。q は集合 {x:g(x)f(x)=0} の上で正とする。また ∫∣g∣fdx<∞ とする。密度 q から独立に作った列による重点抽出の推定値を、I~n とする。これが確率 1 で ∫gfdx に収束することを示せ。
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com
