相対エントロピーから情報と物理を組み立てる 第1部 第2章 §1.2.2 ★★★ 驚きを分布で平均したものが H(X)。一様分布と比べた D で書くと、0≤H≤ln∣X∣ が出る
定義と基本の性質
定義 1.2.2(Shannon エントロピー ★★★)
アルファベット X が有限集合で、分布が p の確率変数 X について、驚き −lnp(X) の期待値
H(X)=⟨−lnp(X)⟩p=−x∈X∑p(x)lnp(x)(1.2.3)
を X の Shannon エントロピーと呼ぶ。分布だけで決まるので H(p) とも書く。p(x)=0 の項は 0ln0=0 と約束する(tlnt→0(t→+0)なので、起こらない値を足しても値は変わらない)。
驚きは値 x ごとに違う確率変数で、H はその平均である。Shannon は、場合分けに関する整合性(後の式 (1.2.8) の特別な場合)・連続性・等確率のときに場合の数について増加すること、の3条件から式 (1.2.3) の形が定数倍を除いて決まることを示した(C. E. Shannon (1948), Bell System Technical Journal 27, 379–423 と 623–656 の定理 2)。命題 1.2.1 は、個々の驚きに条件を課して同じ結論に達する別の道である。
2つの値をとる場合は特に使うので名前を付ける。
hb(p)=−plnp−(1−p)ln(1−p)(0≤p≤1)(1.2.4)
を二値エントロピーと呼ぶ(Planck 定数 h と区別するため添字 b を付ける)。図 1.2.1 のように p=1/2 で最大値 ln2(1 ビット)をとり、p=0,1 で 0 になる。dpdhb=lnp1−p は p→0 で発散するので、p が 0 から少し離れるだけでエントロピーは急に増える。たとえば p=0.1 で hb=0.325 nat =0.469 ビットあり、最大値の半分近くに達している。
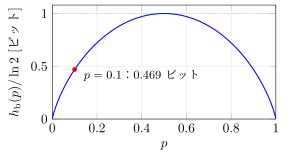
図 1.2.1 二値エントロピー hb(p) をビットで表したもの。p=1/2 で最大値 1 ビットをとる。赤い点は第3節以降で使う p=0.1 の値。
H の基本の性質を3つ挙げる。
命題 1.2.3(エントロピーの範囲 ★★★)
アルファベットの大きさを ∣X∣ とすると
0≤H(X)≤ln∣X∣(1.2.5)
が成り立つ。左の等号は X が確率 1 で1つの値をとるとき、右の等号は p が一様分布 u(x)=1/∣X∣ のときに限り成り立つ。
左の不等式は、各項 −p(x)lnp(x) が 0≤p(x)≤1 で 0 以上であることから出る。等号はすべての項が 0、つまりどの p(x) も 0 か 1 のときに限る。右の不等式を示すために、エントロピーを一様分布と比べた形に書き直す。
一様分布と比べる:H=ln∣X∣−D(p∥u)
2つの分布 p,q について、次の章で相対エントロピー
D(p∥q)=x∑p(x)lnq(x)p(x)
を定義する。ここでは q が一様分布 u の場合だけを使う。ln(p(x)/u(x))=lnp(x)+ln∣X∣ なので
D(p∥u)=x∑p(x)lnp(x)+ln∣X∣=ln∣X∣−H(p)(1.2.6)
となる。エントロピーは、最大値 ln∣X∣ から「p が一様分布からどれだけ離れているか」を測る D(p∥u) を引いたものである。したがって、右の不等式 H≤ln∣X∣ は D(p∥u)≥0 と同じことになる。
命題 1.2.3 の右の不等式の証明
t>0 について lnt≤t−1 が成り立ち、等号は t=1 のときに限る(t−1−lnt は t=1 で最小値 0 をとる)。p(x)>0 となる x の集合を suppp と書くと
−D(p∥u)=x∈suppp∑p(x)ln∣X∣p(x)1≤x∈suppp∑p(x)(∣X∣p(x)1−1)=∣X∣∣suppp∣−1≤0.
等号には、suppp のすべての x で ∣X∣p(x)=1 となり、しかも suppp=X となることが要る。これは p=u のときに限る。
一般の q について D(p∥q)≥0 を示すのは次の章の仕事で、そこでは Jensen の不等式から示す。上の証明は q=u の場合に lnt≤t−1 を使っただけで、同じ1行の議論が一般の q でも使える。
2つの変数:結合エントロピーと条件付きエントロピー
2つの確率変数 X,Y の組 (X,Y) も1つの確率変数なので、同時分布 p(x,y) のエントロピーH(X,Y)=−∑x,yp(x,y)lnp(x,y) が定まる。これを結合エントロピーと呼ぶ。また、X=x と知ったときの Y の条件付き分布 p(y∣x) のエントロピーをx について平均した
H(Y∣X)=x∑p(x)(−y∑p(y∣x)lnp(y∣x))=⟨−lnp(Y∣X)⟩p(1.2.7)
を条件付きエントロピーと呼ぶ。驚きの分解 (1.2.2) の両辺を同時分布で平均すると、連鎖律
H(X,Y)=H(X)+H(Y∣X)(1.2.8)
を得る。X と Y が独立なら H(Y∣X)=H(Y) なので H(X,Y)=H(X)+H(Y) である。Y が X の関数 Y=g(X) なら、X を知れば Y は確定するので H(Y∣X)=0 となり、連鎖律を2通りに使うと
H(X)=H(X,g(X))=H(g(X))+H(X∣g(X))≥H(g(X))(1.2.9)
が出る。関数を通すと(値をまとめると)エントロピーは増えない。この不等式は、第1部第4章のデータ処理不等式のいちばん簡単な場合である。
例題 1.2.2 2つのさいころの和のエントロピー ★★
オリジナル公平なさいころを2つ独立に振り、出た目を X1,X2、和を S=X1+X2 とする。
- (1) H(X1,X2) を nat で求めよ。
- (2) S の分布を書き、H(S) を nat とビットで求めよ。
- (3) H(X1,X2∣S) を求め、その意味を述べよ。
解答
(1) X1,X2 は独立でそれぞれ一様なので、H(X1,X2)=2ln6=ln36≈3.584 nat である。
(2) S=s(s=2,…,12)となる目の組は 6−∣s−7∣ 通りなので p(s)=(6−∣s−7∣)/36 である。
H(S)=−s=2∑12366−∣s−7∣ln366−∣s−7∣≈2.270 nat≈3.274 ビット.
S は11通りの値をとるので上限は ln11≈2.398 nat だが、7 の付近に確率が偏っている分だけ小さい。
(3) S は (X1,X2) の関数なので、式 (1.2.9) から H(X1,X2∣S)=H(X1,X2)−H(S)≈3.584−2.270=1.314 nat(1.896 ビット)である。和を知らされた後に「どちらのさいころがいくつだったか」について残っている不確かさを平均したもので、S=2 や 12 なら残りは 0、S=7 なら ln6 になる。∑sp(s)ln(6−∣s−7∣) を直接計算しても同じ値が出る。
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com
