相対エントロピーから情報と物理を組み立てる 第1部 第2章 §1.2.3 ★★★ 独立同分布の系列では、1文字あたりの驚きが大数の法則で H に集まる。これが漸近等分配性
1文字あたりの驚き
分布 p から独立に n 個取った系列 Xn=(X1,…,Xn) を考える。値の系列を xn=(x1,…,xn)∈Xn と書く(右肩の n は冪でなく系列の長さを表す)。独立なので系列の確率は積
pn(xn)=i=1∏np(xi)
になり、系列の驚きは各文字の驚きの和 −lnpn(xn)=∑i(−lnp(xi)) になる。和を n で割った1文字あたりの驚き
−n1lnpn(Xn)=n1i=1∑n(−lnp(Xi))(1.2.10)
は、独立同分布の確率変数 −lnp(Xi) の標本平均である。その期待値は H(X)、分散は
σs2=Var(−lnp(X))=x∑p(x)(lnp(x))2−H(X)2(1.2.11)
で、X が有限なので有限である。標本平均の分散は σs2/n になる。
定理 1.2.4(漸近等分配性(AEP) ★★★)
X1,X2,… が分布 p に従う独立同分布の確率変数なら、任意の ϵ>0 について
Pr(−n1lnpn(Xn)−H(X)>ϵ)≤nϵ2σs2 n→∞ 0.(1.2.12)
証明
式 (1.2.10) は平均 H(X)、分散 σs2/n の確率変数なので、Chebyshev の不等式 Pr(∣Z−⟨Z⟩∣>ϵ)≤Var(Z)/ϵ2 をそのまま当てはめればよい。
定理の中身は大数の弱法則そのものである。新しいのは、標本平均を取る量が「各文字の驚き」という分布自身から作った量であることで、そのため結論が系列の確率についての主張になる。式 (1.2.12) の括弧の中を書き直すと、確率が 1 に近い系列 xn について
e−n(H+ϵ)≤pn(xn)≤e−n(H−ϵ)(1.2.13)
が成り立つ。実際に出てくる長い系列は、1文字あたり ϵ の幅の範囲で、どれもほぼ同じ確率 e−nH を持つ。確率がほぼ等しく分配されるので、この性質を漸近等分配性(asymptotic equipartition property、AEP)と呼ぶ。
歴史を述べておく。Shannon (1948) は独立な情報源と Markov 情報源についてこの性質を示し(前掲論文の定理 3)、McMillan は定常でエルゴード的な情報源へ広げて「漸近等分配性」の名を与えた(B. McMillan (1953), Annals of Mathematical Statistics 24, 196–219)。Breiman は収束を確率収束からほとんど確実な収束へ強めた(L. Breiman (1957), Annals of Mathematical Statistics 28, 809–811)。この章では独立同分布の場合だけを扱う。
典型集合
定義 1.2.5(典型集合 ★★★)
ϵ>0 と長さ n について、式 (1.2.13) を満たす系列 xn の集合
Aϵ(n)={xn∈Xn: −n1lnpn(xn)−H(X)≤ϵ}
を典型集合、その元を典型系列と呼ぶ。
2値の場合に具体的に書く。X={0,1}、p(1)=p とし、系列に含まれる 1 の個数を k とすると pn(xn)=pk(1−p)n−k なので
−n1lnpn(xn)−hb(p)=(nk−p)lnp1−p(1.2.14)
となる。典型系列とは、1 の割合 k/n が p から ϵ/∣ln((1−p)/p)∣ 以内にある系列のことである。p=0.1、ϵ=0.05 nat ではln9≈2.197 で割って ∣k/n−0.1∣≤0.0228 になる。
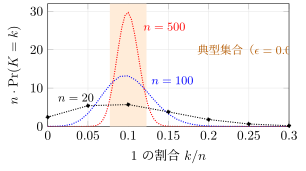
図 1.2.2 p=0.1 の2値の系列で、1 の個数 K の分布(二項分布の厳密な値。縦軸は n 倍して面積を 1 にそろえた)。n が大きくなるほど k/n=0.1 の近くに集まり、橙の帯(典型集合 ∣k/n−0.1∣≤0.0228)に入る確率が 1 に近づく。
例題 1.2.3 何文字あれば典型と言えるか ★★
オリジナルp(1)=0.1、p(0)=0.9 の2値の情報源について次を求めよ。
- (1) 驚きの分散 σs2。
- (2) ϵ=0.05 nat として、Chebyshev の評価 (1.2.12) で「典型集合から外れる確率が 0.1 以下」を保証できる最小の n。
- (3) 図 1.2.3 の厳密な値と比べて、(2) の評価がどの程度ゆるいかを述べよ。
解答
(1) 驚きは x=1 で ln10、x=0 で ln(10/9) をとり、その差は ln9 である。2つの値をとる確率変数の分散は「確率の積 × 値の差の2乗」なのでσs2=0.1×0.9×(ln9)2≈0.4345 nat2 である。
(2) σs2/(nϵ2)≤0.1 から n≥0.4345/(0.1×0.0025)≈1738.0 となり、最小の n は 1739 である。
(3) 厳密には n=500 で典型集合の確率がすでに 0.914 あり、0.9 を超えている。Chebyshev の不等式は分散だけしか使わないので、二項分布の裾が実際には指数関数的に速く減ることを反映せず、必要な長さを3倍以上多く見積もる。裾の指数的な減り方は第1部第8章の大偏差の話題である。
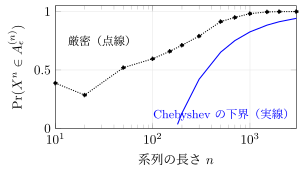
図 1.2.3 p=0.1、ϵ=0.05 nat での典型集合の確率。点線(黒丸)が二項分布から計算した厳密な値、実線が Chebyshev の不等式による下界。n が小さいところで厳密な値が増減するのは、帯に入る整数 k の個数が n とともに飛び飛びに変わるためである。
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com
