相対エントロピーから情報と物理を組み立てる 第1部 第8章 §1.8.1 ★★★ 系列を経験分布(型)でまとめると、確率は e−n(H+D) と書ける。章全体の計算はこの式から出る
大数の法則は、硬貨を n 回投げれば表の割合が 1/2 に近づくと言う。中心極限定理は、そのずれが 1/n の大きさで Gauss 分布に従うと言う。どちらも「よく起きること」の記述である。この章では逆に、表の割合が 0.7 を超えるような「めったに起きないこと」の確率を問う。その確率は n とともに指数関数的に小さくなり、指数の係数(減り方の速さ)が相対エントロピー D(p∥q) になる。これがこの章の結論で、大偏差(large deviation)の理論と呼ばれる。
この巻の章の型に沿って言えば、この章で比べる2つの分布は、観測した系列の経験分布 p と、系列が従うと仮定する真の分布 q である。当てる性質は D の非負性・凸性と、指数型の分布族に対する Pythagoras の恒等式の3つである。出てくるものは次の4つになる。第一に、経験分布が p になる確率は e−nD(p∥q) で、これを集合に広げたものが Sanov の定理である(1.8.1節・1.8.2節)。第二に、標本平均の大偏差の指数は対数積率母関数の Legendre 変換で、これが Cramér の定理である(1.8.3節)。第三に、めったに起きないことが起きたと知ったとき、1個の標本の分布は指数型に傾いた分布(統計力学の Gibbs 分布と同じ形)になる。これが条件付き極限定理で、微視的カノニカル分布からカノニカル分布が出る理由はこの定理で説明できる(1.8.4節)。第四に、2つの仮説を見分ける検定の第2種の誤りは e−nD(p0∥p1) で減り、これが Stein の補題である(1.8.5節)。
前の章までの結果を次の形で使う。相対エントロピーの定義・非負性・凸性は 第1部第3章、データ処理不等式は 第1部第4章、典型系列は 第1部第2章、Fisher 情報 J(θ) と D(pθ∥pθ+δ)≈21J(θ)δ2 は 第1部第7章 で示した。この章でも対数は自然対数で、情報量の単位は nat である。
記号を1つ決めておく。2つの正の数列 an, bn について、n1lnbnan→0(n→∞)のとき an≐bn と書き、「指数の係数で一致する」と読む。an≐e−nc は「an はおおよそ e−nc の速さで 0 に近づく」を意味し、n10 のような多項式の因子の違いは無視される。
経験分布と型のクラス
有限の集合 X(大きさ ∣X∣)に値をとる確率変数 X1,…,Xn が、互いに独立に同じ分布 q に従うとする。観測した系列を xn=(x1,…,xn) と書くと、その確率は qn(xn)=∏i=1nq(xi) である。
定義 1.8.1(経験分布と型)
系列 xn の中で記号 a∈X が現れた回数を N(a∣xn) と書き、
pxn(a)=nN(a∣xn)(a∈X)(1.8.1)
を xn の経験分布または型(type)と呼ぶ。長さ n の系列の型になりうる分布(各成分が 1/n の整数倍の分布)の全体を Pn と書く。型 p∈Pn を持つ系列の全体 Tn(p)={xn:pxn=p} を p の型のクラスと呼ぶ。
たとえば X={表,裏}、n=10 で表が3回出た系列の型は p=(0.3,0.7) で、T10(p) はそういう系列 (310)=120 本の集まりである。型は系列の「順番を忘れて回数だけを残したもの」で、独立同分布の系列の確率は回数だけで決まるので、型だけで計算が済む。型の個数は少ない。各記号の回数は 0 から n までの n+1 通りなので、
∣Pn∣≤(n+1)∣X∣(1.8.2)
が成り立つ。系列の本数 ∣X∣n が n について指数関数的に増えるのに対して、型の個数は多項式でしか増えない。この差が以下の議論のすべての出発点になる。
型で書いた系列の確率
定理 1.8.2(型のクラスの確率 ★★★)
系列 xn の型が p なら
qn(xn)=e−n(H(p)+D(p∥q)).(1.8.3)
さらに、型のクラスの大きさと確率について
(n+1)−∣X∣enH(p)(n+1)−∣X∣e−nD(p∥q)≤∣Tn(p)∣≤enH(p),≤qn(Tn(p))≤e−nD(p∥q)(1.8.4)(1.8.5)
が成り立つ。つまり qn(Tn(p))≐e−nD(p∥q) である。
証明
式 (1.8.3):記号 a は np(a) 回現れるので、lnqn(xn)=∑anp(a)lnq(a)=−n∑ap(a)(lnp(a)1+lnq(a)p(a))=−n(H(p)+D(p∥q))。
式 (1.8.4) の上界:式 (1.8.3) を q=p で使うと、Tn(p) の各系列の pn での確率は e−nH(p) である。確率の和は 1 を超えないので ∣Tn(p)∣e−nH(p)=pn(Tn(p))≤1。
下界:まず、分布 pn のもとでは自分の型のクラス Tn(p) が最も確率の大きい型のクラスであることを示す。別の型 p′∈Pn についてpn(Tn(p))/pn(Tn(p′))=∏a(np(a))!(np′(a))!p(a)n(p(a)−p′(a)) である。m!/l!≥lm−l(m,l は非負の整数)を使うと、この比は ∏a(np(a))n(p′(a)−p(a))p(a)n(p(a)−p′(a))=nn∑a(p′(a)−p(a))=1 以上になる。したがって 1=∑p′∈Pnpn(Tn(p′))≤∣Pn∣pn(Tn(p))≤(n+1)∣X∣∣Tn(p)∣e−nH(p)。
式 (1.8.5):qn(Tn(p))=∣Tn(p)∣e−n(H(p)+D(p∥q)) に式 (1.8.4) を入れる。
式 (1.8.3) の2つの項は別々の意味を持つ。H(p) は型 p の系列が何本あるか(enH(p) 本)を数え、D(p∥q) は真の分布 q から見てその型がどれだけ「ありそうにないか」を測る。型のクラス全体の確率では本数の因子 enH(p) と1本の確率の因子 e−nH(p) が打ち消し合い、D だけが残る。D(p∥q)=0 となる型は p=q だけなので、q から離れた型のクラスの確率は指数関数的に小さくなる。これが大数の法則の「指数関数的に強い」版で、第1部第2章 の典型系列の議論を、型ごとに細かく分けたものになっている。
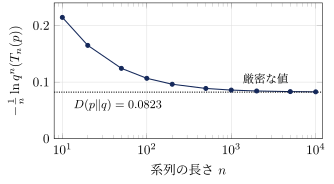
図 1.8.1 公平な硬貨(q=(0.5,0.5))で表の割合が 0.7 の型のクラスの確率の指数。丸印は (0.7nn)2−n から計算した厳密な値で、点線の D(p∥q) に O(lnn/n) の差で近づく。
例題 1.8.1 硬貨10回の型のクラス ★★
オリジナル公平な硬貨(q=(21,21))を 10 回投げる。
- 表がちょうど3回出る確率 q10(T10(p))(p=(0.3,0.7))を正確に求めよ。
- D(p∥q) を求め、式 (1.8.5) の上界と下界の値を出して、(1) の値がその間にあることを確かめよ。
- 上界と下界の比はいくらか。この比が n を大きくしたとき指数の係数に影響しない理由を述べよ。
解答
(1) 表が3回の系列は (310)=120 本で、どれも確率 2−10 だから、q10(T10(p))=120/1024=0.117。
(2) D(p∥q)=0.3ln0.50.3+0.7ln0.50.7=ln2−hb(0.3)=0.6931−0.6109=0.0823。上界は e−10×0.0823=0.439、下界は (10+1)−2×0.439=0.00363 で、0.00363≤0.117≤0.439 が成り立つ。
(3) 比は (n+1)∣X∣=121 である。この比の対数を n で割ると n2ln(n+1)→0 なので、−n1lnqn(Tn(p)) は上界と下界のどちらを使っても同じ極限 D(p∥q) に近づく。n=10 では比が 121 倍もあって評価として粗いが、図 1.8.1 のとおり n を大きくすると指数は D に近づく。
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com
