相対エントロピーから情報と物理を組み立てる 第1部 第7章 §1.7.1 ★★★ D ( p θ ∥ p θ + δ ) ≈ 1 2 J ( θ ) δ 2 D(p_\theta\,\|\,p_{\theta+\delta})\approx\frac12J(\theta)\delta^2 D ( p θ ∥ p θ + δ ) ≈ 2 1 J ( θ ) δ 2
この章で比べる2つの分布は、同じ形の分布の族の中で、パラメータの値だけをわずかに変えた p θ p_\theta p θ p θ + δ p_{\theta+\delta} p θ + δ 第1部第3章 )で定めた相対エントロピー D ( p ∥ q ) D(p\,\|\,q) D ( p ∥ q ) δ \delta δ D ( p θ ∥ p θ + δ ) D(p_\theta\,\|\,p_{\theta+\delta}) D ( p θ ∥ p θ + δ ) δ 2 \delta^2 δ 2 J ( θ ) J(\theta) J ( θ )
D D D J ( θ ) ≥ 0 J(\theta)\ge0 J ( θ ) ≥ 0 D D D n n n n n n 第1部第4章 )からは、データを加工するとFisher 情報が減り、十分統計量なら減らないことが従う。そのうえで、パラメータを推定する人がどれだけ精度よく推定できるかに下限があること(Cramér–Rao の不等式)、観測の回数が多いとき最尤推定がその下限に達すること、統計力学のカノニカル分布では Fisher 情報がエネルギーの揺らぎ、したがって熱容量そのものになることを示す。最後に、統計学の教科書や実験データの解析で習う形と、この章の形を並べる。
パラメータの付いた分布の族
コインの表が出る確率 θ \theta θ θ \theta θ θ \theta θ θ \theta θ { p θ } \{p_\theta\} { p θ } X X X x x x
p θ ( x ) ≡ p ( x ; θ ) (1.7.1) p_\theta(x)\equiv p(x;\theta)\tag{1.7.1} p θ ( x ) ≡ p ( x ; θ ) ( 1.7.1 )
と書き、p θ p_\theta p θ ⟨ f ⟩ θ = ∑ x p ( x ; θ ) f ( x ) \langle f \rangle _\theta=\sum_xp(x;\theta)f(x) ⟨ f ⟩ θ = ∑ x p ( x ; θ ) f ( x ) V a r θ ( f ) \mathrm{Var}_\theta(f) Var θ ( f ) X X X ∫ d x \int\mathrm{d} x ∫ d x θ \theta θ X X X θ \theta θ 推定 と呼ぶ。
この章を通して次の正則条件 を仮定する。第一に、p ( x ; θ ) > 0 p(x;\theta)>0 p ( x ; θ ) > 0 x x x θ \theta θ p ( x ; θ ) p(x;\theta) p ( x ; θ ) θ \theta θ θ \theta θ x x x J ( θ ) J(\theta) J ( θ ) [ 0 , θ ] [0,\theta] [ 0 , θ ] 1.7.3 節で扱う。
スコア
対数をとった確率の θ \theta θ
s θ ( x ) ≔ ∂ ∂ θ ln p ( x ; θ ) = ∂ θ p ( x ; θ ) p ( x ; θ ) (1.7.2) s_\theta(x)\coloneqq\frac{\partial }{\partial \theta}\ln p(x;\theta)=\frac{\partial_\theta p(x;\theta)}{p(x;\theta)}\tag{1.7.2} s θ ( x ) : = ∂ θ ∂ ln p ( x ; θ ) = p ( x ; θ ) ∂ θ p ( x ; θ ) ( 1.7.2 )
をスコア と呼ぶ。x x x θ \theta θ x x x ∑ x p ( x ; θ ) = 1 \sum_xp(x;\theta)=1 ∑ x p ( x ; θ ) = 1 θ \theta θ
0 = ∑ x ∂ θ p ( x ; θ ) = ∑ x p ( x ; θ ) s θ ( x ) = ⟨ s θ ⟩ θ (1.7.3) 0=\sum_x\partial_\theta p(x;\theta)=\sum_xp(x;\theta)\,s_\theta(x)=\langle s_\theta \rangle _\theta\tag{1.7.3} 0 = x ∑ ∂ θ p ( x ; θ ) = x ∑ p ( x ; θ ) s θ ( x ) = ⟨ s θ ⟩ θ ( 1.7.3 )
となる。ここで正則条件の第二(微分と和の交換)と第一(和の範囲が θ \theta θ
D D D D ( p θ ∥ p θ + δ ) = ∑ x p ( x ; θ ) [ ln p ( x ; θ ) − ln p ( x ; θ + δ ) ] D(p_\theta\,\|\,p_{\theta+\delta})=\sum_xp(x;\theta)\bigl[\ln p(x;\theta)-\ln p(x;\theta+\delta)\bigr] D ( p θ ∥ p θ + δ ) = ∑ x p ( x ; θ ) [ ln p ( x ; θ ) − ln p ( x ; θ + δ ) ] ln p ( x ; θ + δ ) \ln p(x;\theta+\delta) ln p ( x ; θ + δ ) δ \delta δ
ln p ( x ; θ + δ ) = ln p ( x ; θ ) + δ s θ ( x ) + δ 2 2 ∂ θ s θ ( x ) + O ( δ 3 ) \ln p(x;\theta+\delta)=\ln p(x;\theta)+\delta\,s_\theta(x)+\frac{\delta^2}{2}\,\partial_\theta s_\theta(x)+\mathcal{O}(\delta^3) ln p ( x ; θ + δ ) = ln p ( x ; θ ) + δ s θ ( x ) + 2 δ 2 ∂ θ s θ ( x ) + O ( δ 3 )
である。これを代入し、式 (1.7.3) で1次の項を消すと
D ( p θ ∥ p θ + δ ) = − δ 2 2 ⟨ ∂ θ s θ ⟩ θ + O ( δ 3 ) (1.7.4) D(p_\theta\,\|\,p_{\theta+\delta})=-\frac{\delta^2}{2}\langle \partial_\theta s_\theta \rangle _\theta+\mathcal{O}(\delta^3)\tag{1.7.4} D ( p θ ∥ p θ + δ ) = − 2 δ 2 ⟨ ∂ θ s θ ⟩ θ + O ( δ 3 ) ( 1.7.4 )
を得る。0次の項は D ( p θ ∥ p θ ) = 0 D(p_\theta\,\|\,p_\theta)=0 D ( p θ ∥ p θ ) = 0 D D D δ = 0 \delta=0 δ = 0 − ⟨ ∂ θ s θ ⟩ θ -\langle \partial_\theta s_\theta \rangle _\theta − ⟨ ∂ θ s θ ⟩ θ (1.7.3) をもう一度 θ \theta θ
0 = ∂ θ ∑ x p s θ = ∑ x ( ∂ θ p ) s θ + ∑ x p ∂ θ s θ = ⟨ s θ 2 ⟩ θ + ⟨ ∂ θ s θ ⟩ θ 0=\partial_\theta\sum_xp\,s_\theta=\sum_x\bigl(\partial_\theta p\bigr)s_\theta+\sum_xp\,\partial_\theta s_\theta=\langle s_\theta^2 \rangle _\theta+\langle \partial_\theta s_\theta \rangle _\theta 0 = ∂ θ x ∑ p s θ = x ∑ ( ∂ θ p ) s θ + x ∑ p ∂ θ s θ = ⟨ s θ 2 ⟩ θ + ⟨ ∂ θ s θ ⟩ θ
となるからである(∂ θ p = p s θ \partial_\theta p=p\,s_\theta ∂ θ p = p s θ
定義 1.7.1(Fisher 情報)
正則な族 { p θ } \{p_\theta\} { p θ } Fisher 情報 を
J ( θ ) ≔ ⟨ s θ 2 ⟩ θ = ⟨ ( ∂ ∂ θ ln p ( X ; θ ) ) 2 ⟩ θ = − ⟨ ∂ 2 ∂ θ 2 ln p ( X ; θ ) ⟩ θ (1.7.5) J(\theta)\coloneqq\langle s_\theta^2 \rangle _\theta=\langle \Bigl(\frac{\partial }{\partial \theta}\ln p(X;\theta)\Bigr)^2 \rangle _\theta=-\langle \frac{\partial^2}{\partial\theta^2}\ln p(X;\theta) \rangle _\theta\tag{1.7.5} J ( θ ) : = ⟨ s θ 2 ⟩ θ = ⟨ ( ∂ θ ∂ ln p ( X ; θ ) ) 2 ⟩ θ = − ⟨ ∂ θ 2 ∂ 2 ln p ( X ; θ ) ⟩ θ ( 1.7.5 )
で定める。スコアの平均が 0 なので、J ( θ ) = V a r θ ( s θ ) J(\theta)=\mathrm{Var}_\theta(s_\theta) J ( θ ) = Var θ ( s θ )
Fisher 情報は D D D
式 (1.7.4) と定義 1.7.1 を合わせると
D ( p θ ∥ p θ + δ ) = 1 2 J ( θ ) δ 2 + O ( δ 3 ) (1.7.6) D(p_\theta\,\|\,p_{\theta+\delta})=\frac12J(\theta)\,\delta^2+\mathcal{O}(\delta^3)\tag{1.7.6} D ( p θ ∥ p θ + δ ) = 2 1 J ( θ ) δ 2 + O ( δ 3 ) ( 1.7.6 )
である。逆向きの D ( p θ + δ ∥ p θ ) D(p_{\theta+\delta}\,\|\,p_\theta) D ( p θ + δ ∥ p θ ) 1 2 J ( θ ) δ 2 \frac12J(\theta)\delta^2 2 1 J ( θ ) δ 2 δ 3 \delta^3 δ 3 1.7.1 )。D D D
名前は R. A. Fisher に由来する。Fisher はスコアの2乗の平均を推定の精度を測る量として導入した(R. A. Fisher (1925), Proc. Cambridge Philos. Soc. 22 , 700–725)。D D D 22 , 79–86)。統計学の教科書では Fisher 情報を I ( θ ) I(\theta) I ( θ ) I I I J ( θ ) J(\theta) J ( θ )
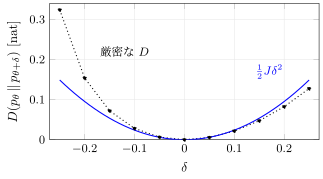
図 1.7.1 Bernoulli 分布(表の確率 θ = 0.3 \theta=0.3 θ = 0.3 θ + δ \theta+\delta θ + δ 1 2 J δ 2 \frac12J\delta^2 2 1 J δ 2 J = 1 / ( 0.3 × 0.7 ) J=1/(0.3\times0.7) J = 1/ ( 0.3 × 0.7 ) ∣ δ ∣ ≲ 0.1 \lvert \delta\rvert \lesssim0.1 ∣ δ ∣ ≲ 0.1
近似の裏付け
型 B(極限) | 小さいもの δ J ( θ ) → 0 \delta\sqrt{J(\theta)}\to0 δ J ( θ ) → 0 証明 条件付き(p p p θ \theta θ O ( δ 3 ) \mathcal{O}(\delta^3) O ( δ 3 ) 行き先 近似の数理 第1章
例題 1.7.1 Bernoulli 分布の Fisher 情報と D D D
オリジナル 序章の例題 1.1.3 で J = 1 / ( θ ( 1 − θ ) ) J=1/(\theta(1-\theta)) J = 1/ ( θ ( 1 − θ )) 1 2 J δ 2 \frac12J\delta^2 2 1 J δ 2 θ \theta θ x = 1 x=1 x = 1 x = 0 x=0 x = 0
スコア s θ ( x ) s_\theta(x) s θ ( x ) J ( θ ) J(\theta) J ( θ )
D ( p θ ∥ p θ + δ ) D(p_\theta\,\|\,p_{\theta+\delta}) D ( p θ ∥ p θ + δ ) D ( p θ + δ ∥ p θ ) D(p_{\theta+\delta}\,\|\,p_\theta) D ( p θ + δ ∥ p θ ) δ \delta δ θ = 0.3 \theta=0.3 θ = 0.3 δ = 0.05 \delta=0.05 δ = 0.05 D D D 1 2 J δ 2 \frac12J\delta^2 2 1 J δ 2
解答 (1) ln p ( x ; θ ) = x ln θ + ( 1 − x ) ln ( 1 − θ ) \ln p(x;\theta)=x\ln\theta+(1-x)\ln(1-\theta) ln p ( x ; θ ) = x ln θ + ( 1 − x ) ln ( 1 − θ ) s θ ( x ) = x θ − 1 − x 1 − θ = x − θ θ ( 1 − θ ) s_\theta(x)=\dfrac{x}{\theta}-\dfrac{1-x}{1-\theta}=\dfrac{x-\theta}{\theta(1-\theta)} s θ ( x ) = θ x − 1 − θ 1 − x = θ ( 1 − θ ) x − θ ⟨ ( X − θ ) 2 ⟩ θ = θ ( 1 − θ ) \langle (X-\theta)^2 \rangle _\theta=\theta(1-\theta) ⟨( X − θ ) 2 ⟩ θ = θ ( 1 − θ )
J ( θ ) = θ ( 1 − θ ) θ 2 ( 1 − θ ) 2 = 1 θ ( 1 − θ ) J(\theta)=\frac{\theta(1-\theta)}{\theta^2(1-\theta)^2}=\frac{1}{\theta(1-\theta)} J ( θ ) = θ 2 ( 1 − θ ) 2 θ ( 1 − θ ) = θ ( 1 − θ ) 1
となる。θ \theta θ J J J
(2) D ( p θ ∥ p θ + δ ) = θ ln θ θ + δ + ( 1 − θ ) ln 1 − θ 1 − θ − δ D(p_\theta\,\|\,p_{\theta+\delta})=\theta\ln\frac{\theta}{\theta+\delta}+(1-\theta)\ln\frac{1-\theta}{1-\theta-\delta} D ( p θ ∥ p θ + δ ) = θ ln θ + δ θ + ( 1 − θ ) ln 1 − θ − δ 1 − θ
D ( p θ ∥ p θ + δ ) = δ 2 2 θ ( 1 − θ ) − ( 1 − 2 θ ) δ 3 3 θ 2 ( 1 − θ ) 2 + O ( δ 4 ) D(p_\theta\,\|\,p_{\theta+\delta})=\frac{\delta^2}{2\theta(1-\theta)}-\frac{(1-2\theta)\,\delta^3}{3\theta^2(1-\theta)^2}+\mathcal{O}(\delta^4) D ( p θ ∥ p θ + δ ) = 2 θ ( 1 − θ ) δ 2 − 3 θ 2 ( 1 − θ ) 2 ( 1 − 2 θ ) δ 3 + O ( δ 4 )
となり、逆向きは
D ( p θ + δ ∥ p θ ) = δ 2 2 θ ( 1 − θ ) − ( 1 − 2 θ ) δ 3 6 θ 2 ( 1 − θ ) 2 + O ( δ 4 ) D(p_{\theta+\delta}\,\|\,p_\theta)=\frac{\delta^2}{2\theta(1-\theta)}-\frac{(1-2\theta)\,\delta^3}{6\theta^2(1-\theta)^2}+\mathcal{O}(\delta^4) D ( p θ + δ ∥ p θ ) = 2 θ ( 1 − θ ) δ 2 − 6 θ 2 ( 1 − θ ) 2 ( 1 − 2 θ ) δ 3 + O ( δ 4 )
となる。2次の係数はどちらも 1 2 J ( θ ) \frac12J(\theta) 2 1 J ( θ ) θ = 1 2 \theta=\frac12 θ = 2 1
(3) J = 1 / 0.21 = 4.762 J=1/0.21=4.762 J = 1/0.21 = 4.762 1 2 J δ 2 = 5.95 × 10 − 3 \frac12J\delta^2=5.95\times10^{-3} 2 1 J δ 2 = 5.95 × 1 0 − 3 D ( p 0.3 ∥ p 0.35 ) = 5.63 × 10 − 3 D(p_{0.3}\,\|\,p_{0.35})=5.63\times10^{-3} D ( p 0.3 ∥ p 0.35 ) = 5.63 × 1 0 − 3 D ( p 0.35 ∥ p 0.3 ) = 5.78 × 10 − 3 D(p_{0.35}\,\|\,p_{0.3})=5.78\times10^{-3} D ( p 0.35 ∥ p 0.3 ) = 5.78 × 1 0 − 3 5.95 × 10 − 3 − 3.02 × 0.05 3 = 5.57 × 10 − 3 5.95\times10^{-3}-3.02\times0.05^3=5.57\times10^{-3} 5.95 × 1 0 − 3 − 3.02 × 0.0 5 3 = 5.57 × 1 0 − 3
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com