比べる2つの分布:情報源の と符号の
AI 生成・木下が未勉強
相対エントロピーから情報と物理を組み立てる 第1部 第5章 §1.5.1 ★★★ 符号を定義し、符号語の長さから分布 を作る。符号が「どの記号が出やすいか」の見込みを持っていることを式にする
手元に記号の列があり、それを と の列に直して保存したい。記号ごとに と の列(符号語)を1つずつ割り当てるとき、よく出る記号に短い符号語を、まれな記号に長い符号語を割り当てれば、列全体は短くなる。どこまで短くできるか、というのがこの章の問いである。答えは「1記号あたり平均で ビットまで、それより短くはできない」で、Shannon がこれを示した1C. E. Shannon (1948), Bell System Technical Journal 27, 379–423, 623–656.下の脚注へ。この章では、この答えを相対エントロピーの非負性からそのまま出す。
鍵になるのは、符号語の長さ の並びを確率分布 に読み替えることである。長さ の符号語を記号 に割り当てることは、「 の確率はおよそ だ」と見込むことと同じになる。そう読み替えると、平均の符号長は
と3つの項に分かれる( は後で定義する Kraft 和)。第1項は情報源だけで決まり、第2項と第3項はどちらも 以上なので、平均の符号長は ビットを下回ることはない。第2項は、符号が見込んだ分布 と本当の分布 のずれの代価である。この分解によって、相対エントロピー は「分布を取り違えて符号を作ると、1記号あたり ビット余分にかかる」という操作的な意味を持つ。
この章の型は第1部の他の章と同じで、比べる2つの分布(情報源の と符号の 。1.5.1節)、 が確率分布になる理由(Kraft–McMillan の不等式。1.5.2節)、当てる性質( の非負性。1.5.3節)、出てくるもの(最適な符号を作る Huffman の方法と、ブロックにして限界 に近づく情報源符号化定理。1.5.4節・1.5.5節)の順に進み、最後に情報理論の授業での書き方と並べる(1.5.6節)。
この章では、符号の長さを数える都合で符号長をビットで測る。エントロピー と相対エントロピー はこの巻の流儀どおり自然対数(nat)で書くので、ビットに直した値は 、 の形で現れる。 は2を底とする対数である。
情報源と符号
情報源とは、有限集合 に値をとる確率変数 のことで、その分布を と書く。 の元を記号と呼ぶ。同じ分布に従う独立な記号が次々に出てくる情報源を無記憶情報源と呼び、この章ではこれだけを扱う。 と を有限個並べた列(空の列も含む)の全体を と書く。
定義 1.5.1(符号と符号長)
写像 を(2元の)符号、 を記号 の符号語、その長さを と書く。記号の列 は、符号語をつないだ に直す(これを符号の拡大と呼ぶ)。分布 のもとでの平均符号長を
と定める。単位はビットである。
符号が使い物になるためには、受け取った と の列から元の記号の列がただ1通りに戻らなければならない。この要求には強さの違う2つの段階がある。
定義 1.5.2(一意に復号できる符号・語頭符号)
拡大した写像 が、あらゆる長さ の記号列の全体の上で単射になるとき、 は一意に復号できるという。どの符号語も、ほかの符号語の頭の部分(語頭)になっていないとき、 を語頭符号(prefix code)と呼ぶ。
語頭符号は一意に復号することができる。受け取った列を頭から読み、符号語の1つと一致した時点で、その記号だと決めてよい。一致した符号語より長い符号語がその頭から始まることはないので、この判断は後の記号を見ても覆らない。この性質から、語頭符号は瞬時符号とも呼ばれる。たとえば に
を割り当てると語頭符号になり、 は頭から と区切れて に戻る。
語頭符号は、根から と の枝が出る2分木の葉と1対1に対応する(図 1.5.1)。根から葉までの枝のラベルを読んだものが符号語で、符号語の長さは葉の深さである。どの符号語もほかの符号語の語頭にならないことは、符号語に当てた節点がすべて葉で、どの符号語の節点もほかの符号語の節点の祖先にならないことと同じである。
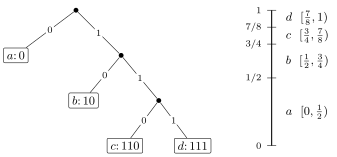
図 1.5.1 語頭符号 (1.5.2) の符号の木(左)。符号語は根から葉までの枝のラベルで、長さは葉の深さ。右は各符号語 を2進小数 から始まる長さ の区間に対応させた図。語頭符号ではこれらの区間が重ならない(1.5.2節)。
符号が見込んでいる分布
符号語の長さの並び から、次の量を作る。
は和が の正の数の並びなので、それだけで確率分布である。1.5.2節では、一意に復号できる符号なら必ず となることを示す。したがって そのものが、和が 以下の「確率の割り振り」になっている。
この読み替えには次の中身がある。語頭符号の符号の木の根から、各分かれ道で と を確率 ずつで選んで降りていくと、深さ の葉に着く確率は である。完全な符号の木では、どの分かれ道の先にも葉があるので、この降り方は必ずどこかの葉に着き、着く確率がちょうど になる。逆に言えば、符号の受け手が受け取る と が公平な硬貨の列のように見えるのは、記号が どおりに出てくるときである。符号を設計する人は、短い符号語を当てた記号ほど出やすいと見込んでいて、その見込みを確率分布の形で書いたものが である。こうして、この章で比べる2つの分布がそろう。1つは情報源が実際に従う分布 、もう1つは符号が見込んでいる分布 である。
長さ の符号語は確率 の見込み
符号語の長さを1ビット延ばすと、見込みの確率は半分になる。長さ の符号語を当てた記号は「半分の確率で出る」と見込まれ、長さ の符号語を当てた記号は「約千回に1回」と見込まれている。符号語の長さを決めることと、確率を見積もることは、 という換算で同じ作業になる。
例題 1.5.1 語頭符号でないが一意に復号できる符号 ★
オリジナル に 、、 を割り当てる。
- この符号が語頭符号でないことを確かめよ。
- 受け取った列が「 の後に が 個続く」形 のとき、最初の記号は の偶奇で決まることを示せ。
- この符号が一意に復号できることを示せ。また、瞬時に(その時点までの列だけで)最初の記号を決められないことを説明せよ。
解答
(1) は の語頭になっているので、語頭符号ではない。
(2) で始まる符号語は だけなので、 の後に続く の連なりは、最初の記号が なら の繰り返しで偶数個、 なら の が1個と の繰り返しで奇数個になる。したがって が偶数なら 、奇数なら と、どちらもただ1通りに読める。
(3) すべての符号語を逆さに読むと になり、これは語頭符号である。受け取った列を後ろから読めば、逆さの語頭符号として瞬時に区切れるので、記号列はただ1通りに戻る。したがって一意に復号することができる。一方、頭から読む場合は、(2) のとおり、 の後に続く を最後まで数えないと最初の記号が か か決まらない。 の連なりはいくらでも長くなりうるので、待つべき長さに上限がない。このため、一意に復号できても瞬時符号ではない。
1 C. E. Shannon (1948), Bell System Technical Journal 27, 379–423, 623–656.
木下の勉強ステータス
木下はまだこの記事を勉強していません。
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com
← AI生成教科書『虎の巻』の記事一覧へ