相対エントロピーから情報と物理を組み立てる 第1部 第6章 §1.6.1 ★★★ 通信路は確率行列 W W W D D D
雑音のある線を通して文字を送ると、受け手の手元には送った文字と少し違う文字が届くことがある。それでも、同じ内容を工夫して何回かに分けて送れば、誤りの確率をいくらでも小さくできるだろうか。できるとすれば、1回の使用あたり何ビットまでなら送れるだろうか。この章はこの問いに答える。答えの数が通信路容量 C C C 1 1 C. E. Shannon (1948), Bell System Technical Journal 27 , 379–423, 623–656.通信路符号化定理 として示した。
この章で比べる2つの分布は、通信路の入力 X X X Y Y Y p X Y p_{XY} p X Y p X p Y p_Xp_Y p X p Y D D D I ( X ; Y ) = D ( p X Y ∥ p X p Y ) I(X;Y)=D(p_{XY}\,\|\,p_Xp_Y) I ( X ; Y ) = D ( p X Y ∥ p X p Y ) 相対エントロピーから情報と物理を組み立てる 第1部第3章 )で、入力の分布を選んでこれを最大にした値が通信路容量 C C C C C C D D D C C C C C C 相対エントロピーから情報と物理を組み立てる 第1部第4章 )から出る。第三に、容量を数値で求める Blahut–Arimoto の反復法である。この反復の各段は D ≥ 0 D\ge0 D ≥ 0 C = 1 2 ln ( 1 + P / N ) C=\frac12\ln(1+P/N) C = 2 1 ln ( 1 + P / N ) k B T ln 2 k_{\mathrm B} T\ln2 k B T ln 2
この章では対数は自然対数で、情報量の単位は nat である。ビットで述べる所だけ log 2 \log_2 log 2 ln 2 \ln2 ln 2 = ln 2 =\ln2 = ln 2
離散無記憶通信路
定義 1.6.1(離散無記憶通信路)
有限集合 X \mathcal X X Y \mathcal Y Y x ∈ X x\in\mathcal X x ∈ X Y \mathcal Y Y W ( ⋅ ∣ x ) W(\cdot\,|\,x) W ( ⋅ ∣ x ) 通信路 と呼ぶ。W ( y ∣ x ) ≥ 0 W(y\,|\,x)\ge0 W ( y ∣ x ) ≥ 0 ∑ y W ( y ∣ x ) = 1 \sum_yW(y\,|\,x)=1 ∑ y W ( y ∣ x ) = 1 W ( y ∣ x ) W(y\,|\,x) W ( y ∣ x ) x x x y y y x x x y y y W W W 1 1 1 n n n x n = ( x 1 , … , x n ) x^n=(x_1,\dots,x_n) x n = ( x 1 , … , x n )
W n ( y n ∣ x n ) = ∏ i = 1 n W ( y i ∣ x i ) (1.6.1) W^n(y^n\,|\,x^n)=\prod_{i=1}^nW(y_i\,|\,x_i)\tag{1.6.1} W n ( y n ∣ x n ) = i = 1 ∏ n W ( y i ∣ x i ) ( 1.6.1 )
が成り立つものを無記憶 であるという。各回の雑音が独立で、前の回の入力や出力に左右されないことを表す。
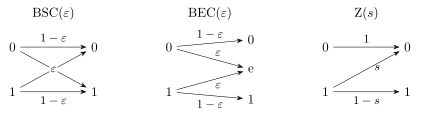
この章では x x x W ( ⋅ ∣ x ) W(\cdot\,|\,x) W ( ⋅ ∣ x ) W x W_x W x W x W_x W x Y \mathcal Y Y W W W x x x 1.6.1 )。
2元対称通信路 BSC(ε \varepsilon ε X = Y = { 0 , 1 } \mathcal X=\mathcal Y=\{0,1\} X = Y = { 0 , 1 } ε \varepsilon ε 2元消失通信路 BEC(ε \varepsilon ε X = { 0 , 1 } \mathcal X=\{0,1\} X = { 0 , 1 } Y = { 0 , e , 1 } \mathcal Y=\{0,\mathrm e,1\} Y = { 0 , e , 1 } ε \varepsilon ε e \mathrm e e Z 通信路 Z(s s s 0 0 0 0 0 0 1 1 1 s s s 0 0 0 0 0 0 1 1 1
図 1.6.1 代表的な3つの通信路。左が入力、右が出力で、矢印の数字が遷移の確率 W ( y ∣ x ) W(y\,|\,x) W ( y ∣ x ) 1 1 1
相互情報量を行ごとの D D D
送り手が入力の文字を分布 p ( x ) p(x) p ( x )
p X Y ( x , y ) = p ( x ) W ( y ∣ x ) , q ( y ) = ∑ x p ( x ) W ( y ∣ x ) (1.6.2) p_{XY}(x,y)=p(x)\,W(y\,|\,x),\qquad q(y)=\sum_{x}p(x)\,W(y\,|\,x)\tag{1.6.2} p X Y ( x , y ) = p ( x ) W ( y ∣ x ) , q ( y ) = x ∑ p ( x ) W ( y ∣ x ) ( 1.6.2 )
になる。行列で書けば出力の分布は q = p W q=pW q = p W p p p W W W p ( x ) q ( y ) p(x)q(y) p ( x ) q ( y ) D D D 相対エントロピーから情報と物理を組み立てる 第1部第3章 )。定義に式 (1.6.2) を入れ、p ( x ) p(x) p ( x )
I ( X ; Y ) = D ( p X Y ∥ p X p Y ) = ∑ x , y p ( x ) W ( y ∣ x ) ln p ( x ) W ( y ∣ x ) p ( x ) q ( y ) = ∑ x p ( x ) D ( W x ∥ q ) (1.6.3) I(X;Y)=D(p_{XY}\,\|\,p_Xp_Y)=\sum_{x,y}p(x)W(y\,|\,x)\ln\frac{p(x)W(y\,|\,x)}{p(x)q(y)}=\sum_{x}p(x)\,D(W_x\,\|\,q)\tag{1.6.3} I ( X ; Y ) = D ( p X Y ∥ p X p Y ) = x , y ∑ p ( x ) W ( y ∣ x ) ln p ( x ) q ( y ) p ( x ) W ( y ∣ x ) = x ∑ p ( x ) D ( W x ∥ q ) ( 1.6.3 )
となる。W W W I ( X ; Y ) I(X;Y) I ( X ; Y ) p p p I ( p , W ) I(p,W) I ( p , W )
式 (1.6.3) の右辺は、入力 x x x W x W_x W x q q q D D D p ( x ) p(x) p ( x ) y y y x x x q q q y y y x x x W x = q W_x=q W x = q I = 0 I=0 I = 0
式 (1.6.3) を ln W ( y ∣ x ) q ( y ) = − ln q ( y ) + ln W ( y ∣ x ) \ln\frac{W(y|x)}{q(y)}=-\ln q(y)+\ln W(y\,|\,x) ln q ( y ) W ( y ∣ x ) = − ln q ( y ) + ln W ( y ∣ x )
I ( p , W ) = H ( Y ) − H ( Y ∣ X ) = H ( q ) − ∑ x p ( x ) H ( W x ) (1.6.4) I(p,W)=H(Y)-H(Y\,|\,X)=H(q)-\sum_xp(x)H(W_x)\tag{1.6.4} I ( p , W ) = H ( Y ) − H ( Y ∣ X ) = H ( q ) − x ∑ p ( x ) H ( W x ) ( 1.6.4 )
も出る。H ( Y ) H(Y) H ( Y ) H ( Y ∣ X ) H(Y\,|\,X) H ( Y ∣ X ) 0.1 0.1 0.1 p = ( 0.7 , 0.3 ) p=(0.7,0.3) p = ( 0.7 , 0.3 ) q ( 1 ) = 0.7 ⋅ 0.1 + 0.3 ⋅ 0.9 = 0.34 q(1)=0.7\cdot0.1+0.3\cdot0.9=0.34 q ( 1 ) = 0.7 ⋅ 0.1 + 0.3 ⋅ 0.9 = 0.34 I = h b ( 0.34 ) − h b ( 0.1 ) ≈ 0.316 I=h_{\mathrm b}(0.34)-h_{\mathrm b}(0.1)\approx0.316 I = h b ( 0.34 ) − h b ( 0.1 ) ≈ 0.316 ≈ 0.456 \approx0.456 ≈ 0.456
例題 1.6.1 消失通信路の相互情報量を行ごとの D D D
オリジナル BEC(ε \varepsilon ε 1 1 1 π \pi π 0 0 0 1 − π 1-\pi 1 − π
出力の分布 q q q
D ( W 0 ∥ q ) D(W_0\,\|\,q) D ( W 0 ∥ q ) D ( W 1 ∥ q ) D(W_1\,\|\,q) D ( W 1 ∥ q ) 式 (1.6.3) から I ( p , W ) = ( 1 − ε ) h b ( π ) I(p,W)=(1-\varepsilon )\,h_{\mathrm b}(\pi) I ( p , W ) = ( 1 − ε ) h b ( π ) ε = 0.25 \varepsilon =0.25 ε = 0.25 π = 1 2 \pi=\frac12 π = 2 1
解答 (1) q ( 0 ) = ( 1 − ε ) ( 1 − π ) q(0)=(1-\varepsilon )(1-\pi) q ( 0 ) = ( 1 − ε ) ( 1 − π ) q ( e ) = ε ( 1 − π ) + ε π = ε q(\mathrm e)=\varepsilon (1-\pi)+\varepsilon \pi=\varepsilon q ( e ) = ε ( 1 − π ) + ε π = ε q ( 1 ) = ( 1 − ε ) π q(1)=(1-\varepsilon )\pi q ( 1 ) = ( 1 − ε ) π
(2) W 0 = ( 1 − ε , ε , 0 ) W_0=(1-\varepsilon ,\varepsilon ,0) W 0 = ( 1 − ε , ε , 0 ) q ( 1 ) q(1) q ( 1 ) 0 ⋅ ln 0 = 0 0\cdot\ln0=0 0 ⋅ ln 0 = 0
D ( W 0 ∥ q ) = ( 1 − ε ) ln 1 − ε ( 1 − ε ) ( 1 − π ) + ε ln ε ε = − ( 1 − ε ) ln ( 1 − π ) . D(W_0\,\|\,q)=(1-\varepsilon )\ln\frac{1-\varepsilon }{(1-\varepsilon )(1-\pi)}+\varepsilon \ln\frac{\varepsilon }{\varepsilon }=-(1-\varepsilon )\ln(1-\pi). D ( W 0 ∥ q ) = ( 1 − ε ) ln ( 1 − ε ) ( 1 − π ) 1 − ε + ε ln ε ε = − ( 1 − ε ) ln ( 1 − π ) .
同じく W 1 = ( 0 , ε , 1 − ε ) W_1=(0,\varepsilon ,1-\varepsilon ) W 1 = ( 0 , ε , 1 − ε ) D ( W 1 ∥ q ) = − ( 1 − ε ) ln π D(W_1\,\|\,q)=-(1-\varepsilon )\ln\pi D ( W 1 ∥ q ) = − ( 1 − ε ) ln π e \mathrm e e q ( e ) q(\mathrm e) q ( e ) D D D
(3) 式 (1.6.3) に入れると
I = ( 1 − π ) [ − ( 1 − ε ) ln ( 1 − π ) ] + π [ − ( 1 − ε ) ln π ] = ( 1 − ε ) [ − π ln π − ( 1 − π ) ln ( 1 − π ) ] = ( 1 − ε ) h b ( π ) . I=(1-\pi)\bigl[-(1-\varepsilon )\ln(1-\pi)\bigr]+\pi\bigl[-(1-\varepsilon )\ln\pi\bigr]=(1-\varepsilon )\bigl[-\pi\ln\pi-(1-\pi)\ln(1-\pi)\bigr]=(1-\varepsilon )\,h_{\mathrm b}(\pi). I = ( 1 − π ) [ − ( 1 − ε ) ln ( 1 − π ) ] + π [ − ( 1 − ε ) ln π ] = ( 1 − ε ) [ − π ln π − ( 1 − π ) ln ( 1 − π ) ] = ( 1 − ε ) h b ( π ) .
受け手は確率 1 − ε 1-\varepsilon 1 − ε ε \varepsilon ε h b ( π ) h_{\mathrm b}(\pi) h b ( π ) ( 1 − ε ) h b ( π ) (1-\varepsilon )h_{\mathrm b}(\pi) ( 1 − ε ) h b ( π ) ε = 0.25 \varepsilon =0.25 ε = 0.25 π = 1 2 \pi=\frac12 π = 2 1 I = 0.75 ln 2 ≈ 0.520 I=0.75\ln2\approx0.520 I = 0.75 ln 2 ≈ 0.520 0.75 0.75 0.75
1 C. E. Shannon (1948), Bell System Technical Journal 27 , 379–423, 623–656.
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com