実験計画法 第2章 §2.1 ★★★ 構造式 xij=μ+ai+εij とその4つの仮定が、以後のすべての計算の前提になる
実験計画法の問題は、どの配置(1元配置・2元配置・直交配列表・乱塊法)であっても、同じ順序の手続きで解く。まずデータがどういう仕組みで生まれたかをデータの構造式として書く。
次に、データの総変動を要因ごとの平方和に分け、それぞれの自由度を数えて分散分析表を作り、F 検定で要因の効果があるかを判定する。最後に、有意となった要因について、最も良い条件での母平均を点推定・区間推定し、新しく1回測ったときの値を予測する。この章では、最も簡単な1元配置(因子が1つ、各水準で同じ回数だけ繰り返す)を題材にして、この手続きを最初から最後まで通す。
資格試験の応用(理工学)の科目では、実験計画法の問いは「構造式を書く」「平方和を計算する」「分散分析表を完成させる」「期待平均平方から検定の意味を説明する」「母平均の信頼区間を求める」という順に並ぶ小問の連鎖で出る。どの小問も、この章で作る道具を配置に合わせて少し変えるだけで解ける。そのため、この章では計算の公式を覚えるのでなく、平方和の分解がなぜ成り立つのか、自由度がなぜその値になるのか、期待平均平方がなぜその形になるのかを、すべて導出の形で書く。第3章以降の配置では、この章の導出をそのまま繰り返すことになる。
章を通して、次の例を使う。
通し例:添加剤と樹脂の強度
ある樹脂に混ぜる添加剤の種類を因子 A とし、4種類 A1,A2,A3,A4 を比べる。各添加剤で試験片を4本ずつ作り、16回の実験の順序を無作為に決めて引張強度(単位 MPa から一定値を引いて整数にしたもの)を測った。結果を表 2.1 に示す。
表 2.1 通し例のデータ(因子 A の4水準、繰返し r=4)| 水準 | データ xij | 水準合計 Ti⋅ | 水準平均 xˉi⋅ |
| A1 | 12 | 15 | 14 | 11 | 52 | 13 |
| A2 | 18 | 16 | 19 | 15 | 68 | 17 |
| A3 | 14 | 17 | 12 | 17 | 60 | 15 |
| A4 | 20 | 22 | 19 | 23 | 84 | 21 |
| | T=264 | xˉˉ=16.5 |
実験の言葉
実験で結果として測る量を特性値と呼ぶ。通し例では引張強度が特性値である。
特性値に影響しそうな原因のうち、実験で意図的に変えるものを因子と呼び、因子をどの値に設定するかの各段階を水準と呼ぶ。通し例では添加剤の種類が因子 A で、A1,…,A4 が4つの水準である。温度や圧力のように連続な値をとる因子を計量因子、添加剤の種類や機械の号機のように値の大小が無い因子を計数因子(質的因子)と呼ぶ。
同じ水準で実験を何回か行うことを繰返しと呼ぶ。繰返しがあると、同じ条件でも結果がどれだけばらつくか、すなわち誤差の大きさを、データから推定することができる。誤差の大きさが分からなければ、水準間の差が偶然の範囲か否かを判定できない。繰返しが実験計画法で欠かせない理由はここにある。
因子を1つだけ取り上げ、その a 個の水準それぞれで r 回ずつ実験する計画を1元配置と呼ぶ。実験の総数は N=ar である。1元配置そのものの手順と適用例は第3章、その理論は第4章で詳しく扱う。この章では、1元配置を使って解析の骨組みを作る。
データの取り方:無作為化
1元配置の16回の実験を、A1 を4回、次に A2 を4回、という順に行ったとする。もし実験の途中で室温が少しずつ上がり、室温が高いほど強度が上がるとすれば、後に実験した A4 の強度は添加剤と無関係に高く出る。このとき、添加剤の効果と室温の効果はデータの上で区別できない。この状態を、2つの効果が交絡しているという。
これを避けるため、N 回の実験の順序を乱数で無作為に決める。これを無作為化(ランダマイズ)と呼ぶ。
無作為化しておけば、室温のように実験者が把握していない原因の影響は、どの水準にも偏りなく散らばり、各データに独立に加わる誤差の一部とみなすことができる。Fisher が実験の原則として挙げた反復・無作為化・局所管理のうちの1つで、3原則の全体は第1章 §1.1 で扱う。無作為化は、次に書く構造式の「誤差は互いに独立」という仮定を実験の手続きの側から保証する操作である。
水準数と水準の取り方
因子の水準をいくつ取るか、どの値に置くかは、データを取る前に決める必要がある。判断の材料は次の3つである。
第一に、計量因子では、水準を2つしか取らないと特性値が因子に対して直線的に変わるか曲がって変わるかを区別できない。たとえば温度 u に対する強度の真の平均が次の形で、u=2 で最大になるとする。
η(u)=10+4u−u2
両端の2点 u=0,4 だけで実験すると、どちらも η=10 となり、温度の効果は無いと結論してしまう。3水準 u=0,2,4 を取れば、中央の η(2)=14 が両端より大きいことが分かる。曲がりを見たいなら3水準以上を取る。
第二に、水準の幅は、実際に使う可能性のある範囲を覆う程度に広く取る。幅が狭すぎると、効果があっても誤差に埋もれて検出できない。逆に、技術的に意味の無い極端な値まで広げると、そこでの挙動に結果が引きずられる。
第三に、水準数を増やすと実験回数 N=ar が増える。総回数を固定すると、水準数 a を増やすほど繰返し r が減る。その分だけ誤差の自由度 a(r−1) が小さくなり、検定の精度が落ちる(自由度の意味は §2.2 で述べる)。計量因子では3〜4水準、計数因子では比べたい種類の数をそのまま水準数にするのが通例である。
データの集計
データ xij の添字は、前が水準の番号、後が繰返しの番号を表す。添字の範囲は i=1,…,a、j=1,…,r である。集計に使う量を次のように定める。
Ti⋅=j=1∑rxij,T=i=1∑aTi⋅=i=1∑aj=1∑rxij,xˉi⋅=rTi⋅,xˉˉ=NT.(2.1)
左から順に、水準合計・総合計・水準平均・総平均と呼ぶ。添字の「⋅」は、その添字について和をとったことを表す。表 2.1 の右の2列が通し例の集計である。総平均は水準平均の単純平均 xˉˉ=a1∑ixˉi⋅ にも等しい(各水準の繰返し数がそろっているため)。
図 2.1 に通し例のデータを打点した。水準平均(短い横線)は水準ごとに異なり、A4 が最も高い。一方、同じ水準の中でもデータは ±2 程度ばらついている。水準平均の違いが、このばらつきに比べて大きいかどうかを判定する手続きが分散分析である。
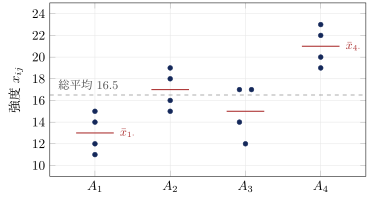
図 2.1 通し例のデータ。点が各データ、赤の短い横線が水準平均 xˉi⋅、破線が総平均 xˉˉ。A3 の17は2個あるので左右にずらした
データの構造式
各データがどういう仕組みで生まれたかを、次の式で表す。
定義 2.1(1元配置のデータの構造式)
xij=μ+ai+εij,i=1∑aai=0,εij∼N(0,σ2) (互いに独立).(2.2)
- μ を一般平均と呼ぶ。
- ai を水準 Ai の主効果と呼ぶ。
- εij を誤差と呼ぶ。
水準 Ai での特性値の母平均を μ(Ai)=μi=μ+ai と書く。
μi は「水準 Ai で無限回実験したときの平均」である。一般平均と主効果は、μi から次のように定まる。
μ=a1i=1∑aμi,ai=μi−μ.
ai は水準 Ai の母平均が全体の平均からどれだけずれているかを表す。この定め方から ∑iai=∑iμi−aμ=0 が自動的に成り立つ。
条件 ∑ai=0 が要る理由を確かめておく。条件を外すと、任意の定数 c について次のように置き換えても、母平均 μ+ai は変わらない。
μ′=μ+c,ai′=ai−c,μ′+ai′=μ+ai.
そのため、データから μ と ai を一通りに決めることができない。a 個の母平均を、それより1個多いパラメータ μ,a1,…,aa で表しているので、1本の制約を課して数を合わせる必要がある。∑ai=0 はその制約の1つの選び方で、μ が「全体の平均」という分かりやすい意味を持つように選んである。
誤差 εij には次の4つを仮定する。
誤差に課す4つの仮定
- 不偏性:E[εij]=0。測定に系統的なずれが無い。
- 等分散性:V[εij]=σ2 がすべての水準で同じ。
- 独立性:異なるデータの誤差は互いに独立。無作為化で保証する。
- 正規性:εij は正規分布に従う。F 検定や t 分布による区間推定の根拠になる。
等分散性と正規性をデータで確かめる手順(範囲 R による等分散の確認、正規確率プロット)は第3章で扱う。
構造式から、水準平均と総平均の分布がすぐに求まる。xˉi⋅=r1∑j(μ+ai+εij)=μ+ai+εˉi⋅ なので
xˉi⋅∼N(μ+ai, rσ2),xˉˉ=μ+a1i∑ai+εˉˉ=μ+εˉˉ∼N(μ, Nσ2).(2.3)
ここで εˉi⋅ は誤差の水準平均、εˉˉ は誤差の総平均である。2つ目の式では ∑ai=0 を使った。異なる水準の xˉi⋅ どうしは、含む誤差が重ならないので独立である。
最小二乗法によるパラメータの推定
構造式のパラメータは、データとの差の2乗和を最小にする値として推定する。
定理 2.2(1元配置の最小二乗推定量)
制約 ∑iai=0 のもとで Q(μ,a1,…,aa)=∑i=1a∑j=1r(xij−μ−ai)2 を最小にする値は
μ^=xˉˉ,a^i=xˉi⋅−xˉˉ,μ^i=μ^+a^i=xˉi⋅(2.4)
である。
証明
mi=μ+ai とおく。すると Q=∑i∑j(xij−mi)2 は、水準ごとに分かれた和になる。水準 i の部分は、xij−mi=(xij−xˉi⋅)+(xˉi⋅−mi) と分けて展開すると
j=1∑r(xij−mi)2=j=1∑r(xij−xˉi⋅)2+2(xˉi⋅−mi)j=1∑r(xij−xˉi⋅)+r(xˉi⋅−mi)2
となる。中央の和は ∑jxij−rxˉi⋅=0 なので消え、残りは mi=xˉi⋅ のときに最小となる。よって m^i=xˉi⋅。制約 ∑ai=0 のもとで、2組のパラメータは次の式で1対1に対応する。
μ=a1i=1∑ami,ai=mi−μ.
したがって μ^=a1∑ixˉi⋅=xˉˉ、a^i=xˉi⋅−xˉˉ を得る。
データと推定値の差 eij=xij−μ^i=xij−xˉi⋅ を残差と呼ぶ。残差は誤差 εij の推定値に当たる。
証明の中で見たとおり、残差は水準ごとに和が0になる:∑jeij=0(i=1,…,a)。この a 本の制約が、次節で誤差の自由度を数えるときの根拠になる。また推定値も ∑ia^i=∑ixˉi⋅−axˉˉ=0 を満たし、構造式の制約と矛盾しない。
例題 2.1 通し例の集計と構造式のパラメータの推定 ★★★
オリジナル表 2.1 のデータについて、次の問いに答えよ。
- (1) 一般平均 μ と主効果 a1,…,a4 の推定値を求めよ。また推定値の和 ∑ia^i が0になることを確かめよ。
- (2) 各データの残差 eij を求め、水準ごとの残差の和が0になることを確かめよ。さらに水準ごとの残差の2乗和を求めよ。
- (3) 構造式のもとで xˉ4⋅−xˉ2⋅ の期待値と分散を μ,ai,σ2 で表せ。
解答
(1) 定理 2.2 より μ^=xˉˉ=264/16=16.5。主効果は a^i=xˉi⋅−16.5 なので
a^1=13−16.5=−3.5,a^2=17−16.5=0.5,a^3=15−16.5=−1.5,a^4=21−16.5=4.5.
和は −3.5+0.5−1.5+4.5=0 である。
(2) 残差 eij=xij−xˉi⋅ は
A1: (−1,2,1,−2),A2: (1,−1,2,−2),A3: (−1,2,−3,2),A4: (−1,1,−2,2)
で、どの水準でも和は0になる(たとえば A3 は −1+2−3+2=0)。水準ごとの2乗和は次のとおりで、合計は48である。
A1: 1+4+1+4=10,A2: 1+1+4+4=10,A3: 1+4+9+4=18,A4: 1+1+4+4=10.
この48が次節の誤差平方和 Se になる。
(3) (2.3) より E[xˉ4⋅−xˉ2⋅]=(μ+a4)−(μ+a2)=a4−a2。2つの水準平均は独立なので、分散は和になる。
V[xˉ4⋅−xˉ2⋅]=4σ2+4σ2=2σ2.一般平均 μ は差をとると消える。
確認テスト
オリジナル
- 2.1-1 構造式 (2.2) の制約 ∑iai=0 を外すと、パラメータが一通りに定まらないことを、具体的な変換を1つ挙げて示せ。
- 2.1-2 因子 A の3水準で各3回実験し、次のデータを得た。
A1: 5, 7, 6,A2: 9, 8, 10,A3: 3, 4, 2.
推定値 μ^ と a^1,a^2,a^3 を求めよ。また、すべての残差 eij を求めよ。3. 2.1-3 構造式 (2.2) のもとで、a 水準・繰返し r の1元配置を考える。次の2つを求めよ。
Cov(xˉ1⋅,xˉˉ),V[xˉ1⋅−xˉˉ]
さらに E[a^1]=a1 を示せ。4. 2.1-4 計量因子 u に対する特性値の母平均が η(u)=10+4u−u2 であるとする。2水準 u=0,4 で実験した場合と、3水準 u=0,2,4 で実験した場合について、主効果をそれぞれ求めよ(主効果は和が0になる定め方による)。また、2水準では因子の効果を検出できない理由を述べよ。
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com
