実験計画法 第2章 §2.2 ★★★ ST=SA+Se の分解・自由度・期待平均平方・F 検定。1級で毎回問われる中心の手続き
平方和の分解
データの総平均からのずれを、水準平均を経由して2つに分ける。
xij−xˉˉ=(xˉi⋅−xˉˉ)+(xij−xˉi⋅).(2.5)
右辺の第1項は「どの水準でとったか」によるずれ(主効果の推定値 a^i)、第2項は「同じ水準の中でのばらつき」(残差 eij)である。両辺を2乗して i,j について和をとる。
定義 2.3(平方和)
ST=i=1∑aj=1∑r(xij−xˉˉ)2,SA=i=1∑aj=1∑r(xˉi⋅−xˉˉ)2=ri=1∑a(xˉi⋅−xˉˉ)2,Se=i=1∑aj=1∑r(xij−xˉi⋅)2(2.6)
をそれぞれ総平方和、因子 A の平方和(級間平方和)、誤差平方和(級内平方和)と呼ぶ。
定理 2.4(平方和の分解)
ST=SA+Se が成り立つ。
証明
(2.5) を2乗して和をとると
ST=SA+Se+2i=1∑aj=1∑r(xˉi⋅−xˉˉ)(xij−xˉi⋅).
交差項では、因子 xˉi⋅−xˉˉ が j によらないので、内側の和の外に出せる。
2i=1∑a(xˉi⋅−xˉˉ)j=1∑r(xij−xˉi⋅)
内側の和は残差の水準内の和で、§2.1 で見たとおり0である。よって交差項は消える。
分解の意味は幾何で見ると分かりやすい。データ N 個を並べたベクトルを x とする。
この分解は、総平均を引いた x−xˉˉ1 を、「水準ごとに一定の値をとるベクトル」の成分と「水準ごとに和が0のベクトル」の成分に分けている。前者と後者は内積が0(直交)なので、Pythagoras の定理によって長さの2乗が足し算になる。ST=SA+Se はこの直交分解の式である。
計算式と修正項
定義式 (2.6) のまま計算すると、平均が割り切れないときに端数の2乗を何度も扱うことになる。手計算では次の形を使う。
命題 2.5(平方和の計算式)
修正項を CT=T2/N とおくと
ST=i=1∑aj=1∑rxij2−CT,SA=i=1∑arTi⋅2−CT,Se=ST−SA.(2.7)
証明
ST=∑∑(xij2−2xijxˉˉ+xˉˉ2)=∑∑xij2−2xˉˉT+Nxˉˉ2。xˉˉ=T/N を代入すると −2T2/N+T2/N=−T2/N=−CT となる。SA も同様に展開する。
SA=ri∑(xˉi⋅2−2xˉi⋅xˉˉ+xˉˉ2)=ri∑xˉi⋅2−2xˉˉ⋅ri∑xˉi⋅+raxˉˉ2=i∑rTi⋅2−CT.
最後の行では rxˉi⋅2=Ti⋅2/r と r∑ixˉi⋅=T を使った。総数は ra=N である。Se は定理 2.4 から従う。
「修正項」の名前は、原点のまわりの2乗和 ∑∑xij2 を、総平均のまわりの2乗和へ直すために引く量であることに由来する。覚え方の要点は「合計を2乗して、その合計に含まれるデータの個数で割る」ことで、CT=T2/N も Ti⋅2/r もこの形をしている。後の章の2元配置や直交配列表でも、平方和はすべて「(合計)2/(個数)の和 −CT」の形で書ける。
自由度
平方和は足し合わせる項の数が多いほど大きくなるので、平方和の大小をそのまま比べても意味が無い。平方和を「独立に動ける成分の数」で割って比べる。この数が自由度である。
定義 2.6(自由度)
平方和を構成する偏差のうち、独立に値をとることのできるものの個数を、その平方和の自由度と呼ぶ。1元配置では
ϕT=N−1,ϕA=a−1,ϕe=a(r−1)=N−a,ϕT=ϕA+ϕe.(2.8)
各値の根拠を数える。
- 総平方和:偏差 xij−xˉˉ は N 個ある。偏差の総和は0なので、N−1 個を決めれば残り1個は決まる。よって ϕT=N−1。
- 級間平方和:偏差 xˉi⋅−xˉˉ は a 個ある。その和は ∑ixˉi⋅−axˉˉ=0 なので、ϕA=a−1。
- 誤差平方和:残差 eij は N 個ある。制約は水準ごとに1本ずつ(∑jeij=0)あるので、ϕe=N−a。
自由度は幾何の言葉では部分空間の次元である。平方和の分解のところで述べた「水準ごとに一定のベクトルで、成分の総和が0のもの」の全体はa−1 次元、「水準ごとに和が0のベクトル」の全体は a(r−1) 次元である。SA と Se は、データをそれぞれの部分空間へ直交射影したベクトルの長さの2乗であり、自由度はその部分空間の次元に等しい。この見方は第4章で検定の理論を述べるとき、また数理統計の線形モデルの章とつなげるときに使う。
なぜ n−1 で割るのか
自由度で割る操作は、不偏分散
S2=n−11i=1∑n(Xi−Xˉ)2
が n でなく n−1 で割る理由と同じである。
命題 2.7(偏差平方和の期待値)
X1,…,Xn は独立で、期待値と分散が共通の μ,σ2 であるとする。このとき次が成り立つ。
E[k=1∑n(Xk−Xˉ)2]=(n−1)σ2.
証明
∑k(Xk−Xˉ)2=∑kXk2−nXˉ2 と書ける(命題 2.5 の ST と同じ展開)。E[Xk2]=V[Xk]+(E[Xk])2=σ2+μ2、E[Xˉ2]=V[Xˉ]+μ2=σ2/n+μ2 を代入すると
E[k∑(Xk−Xˉ)2]=n(σ2+μ2)−n(nσ2+μ2)=(n−1)σ2.□
偏差 Xk−Xˉ の基準は、真の平均でなく、データから計算した Xˉ である。2乗和 ∑(Xk−c)2 を最小にする定数は c=Xˉ である。そのため次の不等式が成り立ち、左辺の期待値は右辺の期待値 nσ2 より小さくなる。
k∑(Xk−Xˉ)2≤k∑(Xk−μ)2
減る量の期待値はちょうど σ2 の1個分(nV[Xˉ])である。平均を1つ推定するごとに自由度が1つ減るという言い方は、このことを指す。2乗和を自由度で割れば、平均の推定で失われた分を補正した σ2 の不偏推定量になる。
期待平均平方
平方和を自由度で割ったものを平均平方と呼ぶ。
VA=ϕASA,Ve=ϕeSe.(2.9)
平均平方の期待値(期待平均平方 E(V))を求めると、F 検定が何をしているかが分かる。
定理 2.8(1元配置の期待平均平方)
構造式 (2.2) のもとで
E(Se)=a(r−1)σ2,E(SA)=(a−1)σ2+ri=1∑aai2,E(Ve)=σ2,E(VA)=σ2+rσA2,σA2=a−1∑i=1aai2.(2.10)(2.11)
証明
μ+ai は引き算で消えるので、残差は誤差だけで書ける。
xij−xˉi⋅=εij−εˉi⋅
よって水準ごとの部分は、独立な誤差 r 個の偏差平方和である。各誤差は期待値0・分散 σ2 をもつ。命題 2.7 でその期待値は (r−1)σ2。a 水準分を足して E(Se)=a(r−1)σ2。
SA については、(2.3) と ∑ai=0 から次のように書ける。
xˉi⋅−xˉˉ=ai+(εˉi⋅−εˉˉ)
2乗して和をとると
SA=ri∑ai2+2ri∑ai(εˉi⋅−εˉˉ)+ri∑(εˉi⋅−εˉˉ)2.
第2項の期待値は0である。第3項について考える。εˉ1⋅,…,εˉa⋅ は独立で、期待値0・分散 σ2/r をもつ。その平均が εˉˉ なので、命題 2.7 を n=a として使えば次を得る。
E[i∑(εˉi⋅−εˉˉ)2]=r(a−1)σ2
r 倍して (a−1)σ2 を得る。自由度で割れば E(Ve)、E(VA) の式になる。
σA2 は主効果の大きさを分散の形で表した量で、母数模型(水準を固定して選んだ模型)では確率変数でなく定数である。
定理 2.8 から、2つの平均平方は次の量の不偏推定量である。
- Ve は誤差分散 σ2 を推定する。
- VA は、誤差の分に主効果の分を足した σ2+rσA2 を推定する。
帰無仮説は次のとおりである。
H0: a1=⋯=aa=0(すなわち σA2=0)
H0 のもとでは2つの平均平方がどちらも誤差分散を推定するので、比 VA/Ve は1の近くに来る。主効果があれば VA の期待値は rσA2 だけ大きくなり、比は1より大きくなる。これが分散比で検定する理由である。また、この式から σA2 の不偏推定量 σ^A2=(VA−Ve)/r も得られる。
分散比の分布と F 検定
検定に使うには、比の分布が要る。正規母集団の標本分布の結果(数理統計の第5章 §5.2)として、X1,…,Xn が独立に N(μ,σ2) に従うとき
σ21k=1∑n(Xk−Xˉ)2∼χn−12,Xˉ と k=1∑n(Xk−Xˉ)2 は独立(2.12)
が成り立つ。これを借りると次が言える。
定理 2.9(分散比の分布)
構造式 (2.2) のもとで、次の (i)(ii) が成り立つ。
- (i) Se/σ2∼χϕe2 である。また Se は水準平均の組 (xˉ1⋅,…,xˉa⋅) と独立である。
- (ii) H0:a1=⋯=aa=0 のもとで SA/σ2∼χϕA2 であり、次が成り立つ。
F0=VeVA∼FϕA,ϕe.(2.13)
証明
水準 i のデータは、独立に N(μ+ai,σ2) に従う。(2.12) より、次の量は χr−12 に従い、xˉi⋅ と独立である。
σ21j=1∑r(xij−xˉi⋅)2
異なる水準のデータは独立である。そのため Se/σ2 は、独立な χr−12 を水準の数だけ足したものである。カイ二乗分布の再生性により、これは χa(r−1)2 に従う。また Se は、水準平均の組全体と独立である。
帰無仮説のもとでは、水準平均 xˉ1⋅,…,xˉa⋅ は独立に同じ分布 N(μ,σ2/r) に従う。再び (2.12) を n=a として使うと次を得る。
σ2/r∑i(xˉi⋅−xˉˉ)2=σ2SA∼χa−12
SA は水準平均だけの関数なので Se と独立である。独立なカイ二乗変数をそれぞれの自由度で割った比は F 分布に従うので、F0=(Se/σ2)/ϕe(SA/σ2)/ϕA∼FϕA,ϕe。σ2 は約分で消える。
F0 が大きいほど主効果がある証拠になるので、棄却域は上側にとる。有意水準 α の検定は
F0≥FϕA,ϕe(α) ならば H0 を棄却する(2.14)
である。実験計画法の慣習では、有意水準5%で有意なら F0 の右に「∗」を付ける。1%で有意なら「∗∗」を付ける。検出力や非心 F 分布を使った検定の意味づけは第4章 §4.1 で扱う。
分散分析表
ここまでの量を1つの表にまとめたものが分散分析表である(表 2.2)。
表 2.2 1元配置の分散分析表の形| 要因 | 平方和 S | 自由度 ϕ | 平均平方 V | 分散比 F0 | E(V) |
| A | SA | a−1 | VA=SA/ϕA | VA/Ve | σ2+rσA2 |
| e | Se | a(r−1) | Ve=Se/ϕe | | σ2 |
| 計 T | ST | N−1 | | | |
表の作り方の手順をまとめておく。
- (i) 水準合計 Ti⋅、総合計 T、データの2乗和を計算する。
- (ii) CT=T2/N を求める。
- (iii) (2.7) で ST と SA を求める。残りを Se=ST−SA とする。
- (iv) 自由度を (2.8) で数え、ϕT=ϕA+ϕe を確かめる。
- (v) 平均平方と F0 を計算し、F 表の値と比べて判定する。
図 2.2 は、通し例で使う F3,12 分布の密度と棄却域である。
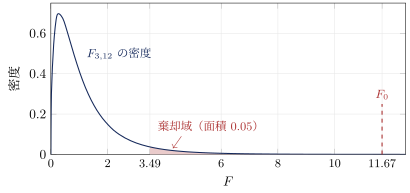
図 2.2 F3,12 分布の密度。上側5%点 F3,12(0.05)=3.49 より右が有意水準5%の棄却域で、通し例の F0=11.67 はその中に入る
数値変換
測定値の桁が大きいときや小数点以下が長いときは、平方和の計算の前にデータを一次変換して扱いやすい数にする。定数 x0 と h>0 を選び、次のようにおく。
Xij=(xij−x0)h
命題 2.10(数値変換の影響)
変換後のデータで計算した平方和を S(X) と書くと、どの平方和についても S(x)=S(X)/h2 が成り立つ。自由度は変わらず、平均平方も h2 倍の関係にある。したがって分散比 F0 は変換によって変わらない。平均は xˉ=x0+Xˉ/h と戻す。
証明
平方和はすべて「データから何らかの平均を引いた偏差の2乗和」である。Xij=(xij−x0)h のとき、どの平均も同じ変換を受ける(たとえば Xˉi⋅=(xˉi⋅−x0)h)。
そのため偏差では x0 が引き算で消え、偏差は h 倍になる。2乗和は h2 倍になる。F0 は2つの平均平方の比なので、h2 が約分で消える。
平行移動 x0 は平方和に影響しないので、総平均に近い値を選んで数を小さくする。倍率 h は小数点を消すために10の累乗を選ぶことが多い。平方和を元の単位に戻すときは h でなく h2 で割る。一方、信頼区間の幅は Ve に比例するので、h で割って戻す。
寄与率
F 検定は「効果があるか無いか」を判定するが、効果が全体のばらつきのどれだけを占めるかは表さない。それを表すのが寄与率である。
単純に SA/ST をとると、効果が無くても0にならない。定理 2.8 のとおり、SA の期待値には誤差の分 ϕAσ2 が含まれるためである。そこで誤差の分を差し引く。
定義 2.11(純変動と寄与率)
SA′=SA−ϕAVe,Se′=Se+ϕAVe,ρA=STSA′,ρe=STSe′.(2.15)
SA′ を因子 A の純変動と呼ぶ。ρA を寄与率と呼ぶ。SA′+Se′=ST なので ρA+ρe=1 である。
E(SA−ϕAVe)=ϕAσ2+r∑ai2−ϕAσ2=r∑ai2 なので、純変動は主効果だけによる変動の不偏推定量である。差し引いた ϕAVe は誤差の側へ戻すので、Se′ は誤差平方和に同じ量を足したものになる。
例題 2.2 通し例の分散分析表 ★★★
オリジナル表 2.1 のデータについて、次の問いに答えよ。
- (1) 修正項 CT、平方和 ST,SA,Se を計算式 (2.7) で求め、定義式による値と一致することを確かめよ。
- (2) 分散分析表を作り、有意水準5%と1%で因子 A の効果を判定せよ。F3,12(0.05)=3.49、F3,12(0.01)=5.95 を用いてよい。
- (3) 寄与率 ρA,ρe と、σA2 の推定値を求めよ。
解答
(1) 総合計と総数は T=264、N=16 である。修正項は CT=2642/16=69696/16=4356。データの2乗和は
∑∑xij2=(144+225+196+121)+(324+256+361+225)+(196+289+144+289)+(400+484+361+529)=686+1166+918+1774=4544
なので ST=4544−4356=188。水準合計の2乗和は 522+682+602+842=2704+4624+3600+7056=17984 で、SA=17984/4−4356=4496−4356=140。Se=188−140=48。
定義式で確かめる。SA=4{(−3.5)2+0.52+(−1.5)2+4.52}=4(12.25+0.25+2.25+20.25)=4×35=140。Se は例題 2.1 (2) の残差2乗和の合計 10+10+18+10=48。どちらも一致する。
(2) 自由度・平均平方・分散比は次のとおりである。
ϕA=4−1=3,ϕe=4×3=12,ϕT=15,VA=140/3=46.67,Ve=48/12=4.00,F0=46.67/4.00=11.67.
| 要因 | S | ϕ | V | F0 | E(V) |
| A | 140 | 3 | 46.67 | 11.67∗∗ | σ2+4σA2 |
| e | 48 | 12 | 4.00 | | σ2 |
| T | 188 | 15 | | | |
F0=11.67≥F3,12(0.01)=5.95 なので、因子 A は有意水準1%で有意である。添加剤の種類によって強度の母平均は異なると判断する。
(3) SA′=140−3×4.00=128、Se′=48+12=60。ρA=128/188=0.681(68.1%)、ρe=60/188=0.319(31.9%)。強度のばらつきの約7割が添加剤の違いによって説明される。σA2 の推定値は (VA−Ve)/r=(46.67−4.00)/4=10.67 である。
例題 2.3 数値変換をして分散分析する ★★
オリジナル通し例の強度が、実は xij=2.0+Xij/10(単位 GPa)という元の測定値を Xij=(xij−2.0)×10 と変換したものだったとする。元の単位に戻した平方和 SA,Se と平均平方 Ve を求めよ。また分散比 F0 と水準 A4 の平均を求めよ。
解答
変換は x0=2.0、h=10 の形である。命題 2.10 より、元の単位の平方和は変換後の値を h2=100 で割ったものである。
SA=140/100=1.40,Se=48/100=0.48自由度は変わらないので Ve=0.48/12=0.04、VA=1.40/3=0.467。F0=0.467/0.04=11.67 で、変換後と同じ値になる。平均は逆の変換で戻し、xˉ4⋅=2.0+21/10=4.1 である。
確認テスト
オリジナル
- 2.2-1 1元配置で誤差平方和の自由度が a(r−1) になる理由を、残差が満たす制約を使って1〜2文で説明せよ。
- 2.2-2 確認テスト 2.1-2 のデータについて、CT と平方和 ST,SA,Se を計算式で求め、分散分析表を作って有意水準5%と1%で判定せよ。F2,6(0.05)=5.14、F2,6(0.01)=10.92 を用いてよい。
- 2.2-3 確認テスト 2.1-2 のデータが、元の測定値 x を X=(x−2.30)×100 と変換したものであったとする。元の単位での平方和 SA,Se と分散比 F0 を求めよ。
- 2.2-4 定義式 SA=r∑i(xˉi⋅−xˉˉ)2 から、計算式 SA=∑iTi⋅2/r−T2/N を導け。
- 2.2-5 確認テスト 2.2-2 の結果から、純変動 SA′ と寄与率 ρA,ρe を求めよ。また、SA/ST を寄与率として使ってはいけない理由を期待値を使って述べよ。
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com
