実験計画法 第3章 §3.2 ★★★ 計画 → グラフ → 等分散の確認 → 分散分析 → 残差の検討 → 推定、の順に1本のデータで手順を最後までたどる
この節では1つの実験を題材に、計画を立てる段階から結論を書く段階までを順に説明する。前節の公式を当てはめるだけでなく、分散分析の前に前提を確かめる手順(等分散性と正規性)と、分散分析のあとに残差を調べる手順を入れる。
試験では「分散分析表を完成させよ」の前後に「等分散性をどう確かめるか」「残差から何が分かるか」という小問が付くことがある。
実験の計画
鋼材の熱処理で、焼戻し温度 A が引張強さに与える影響を調べたい。現行条件を含めて温度を4水準(A1<A2<A3<A4)とり、各水準で5本の試験片を処理して引張強さを測る(単位は適当に変換した値とする)。
水準の数と間隔は、技術的に意味のある範囲を覆うように決める。範囲が狭すぎると水準間の差が誤差より小さくなって検出できず、広すぎると水準の間で特性値がどう変わるかが分からなくなる。
20回の処理の順序は乱数で決める。加熱炉の状態が日中に変化しても、その影響が特定の温度に偏らないようにするためである。試験片も、同じ素材ロットから無作為に割り当てる。
データとグラフ
得られたデータを表 3.2 に、水準ごとの打点図を図 3.1 に示す。
表 3.2 焼戻し温度と引張強さ(変換した値)| 水準 | データ | Ti⋅ | xˉi⋅ | Ri |
| A1 | 22 | 25 | 20 | 24 | 23 | 114 | 22.8 | 5 |
| A2 | 27 | 25 | 29 | 26 | 28 | 135 | 27.0 | 4 |
| A3 | 30 | 26 | 29 | 31 | 29 | 145 | 29.0 | 5 |
| A4 | 24 | 27 | 23 | 26 | 25 | 125 | 25.0 | 4 |
| 計 | | 519 | 25.95 | |
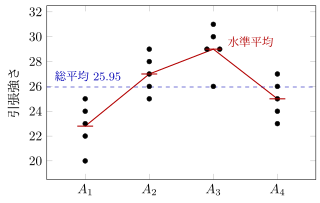
図 3.1 水準ごとの打点図。黒点がデータ(A3 の 29 は2個あるので横にずらした)、実線が水準平均を結んだ折れ線、破線が総平均。各点の総平均からのずれを、水準平均の総平均からのずれ(SA の成分)と、点の水準平均からのずれ(Se の成分)に分けたものが式 (3.4) である
分散分析の計算に入る前に、図で2点を見ておく。
- 水準平均の並び方。A3 で最大になり A4 で下がる山形をしている。温度を上げるほど強くなるという単調な関係ではないことが、ここで分かる。
- 各水準の中のばらつきの大きさ。4水準の幅(範囲)は 4〜5 とほぼ同じであり、等分散性を疑わせる様子はない。極端に離れた点(外れ値)も見当たらない。
等分散性の確認
構造式の前提のうち等分散性は、分散分析の結果を左右する。水準ごとの分散が等しいかどうかを数値で確かめる方法を2つ挙げる。
範囲 R による確認.
各水準の範囲 Ri=maxjxij−minjxij を、品質管理の範囲の管理図の考え方で比べる。繰返し数 r の正規標本について、範囲の期待値と標準偏差は次のように書ける。定数 d2,d3 は繰返し数だけで決まる。
E(R)=d2σ,D(R)=d3σ.
範囲の上側の管理限界は E(R)+3D(R)=(d2+3d3)σ である。範囲の平均を Rˉ=a1∑iRi と書く。誤差の標準偏差を Rˉ/d2 で推定すると
UCL=D4Rˉ,D4=1+d23d3(3.17)
となる。すべての Ri が D4Rˉ 以下なら、等分散性を否定する根拠はないと判断する。定数の値は次のとおりである。
- r=5 のとき:d2=2.326, d3=0.864, D4=2.114。
- r=4 のとき:d2=2.059, D4=2.282。
r≤6 では下側の管理限界は0未満になるので考えない。
表 3.2 では Rˉ=(5+4+5+4)/4=4.5 で、UCL=2.114×4.5=9.51 である。すべての Ri がこれ以下である。
あわせて σ の推定値を比べる。範囲からは Rˉ/d2=4.5/2.326=1.93 で、後で求める誤差分散からは 3.05=1.75 となる。近い値になっている。範囲による方法は計算が簡単で、繰返し数が小さい(r≤10 程度)ときに使う。
Bartlett 検定.
水準 Ai の不偏分散と、それを合わせた量を次のように置く。
Vi=ϕiSi (ϕi=ri−1),ϕe=i∑ϕi,Ve=ϕe∑iSi.
B=CM,M=ϕelogVe−i=1∑aϕilogVi,C=1+3(a−1)1(i=1∑aϕi1−ϕe1)(3.18)
とおく。H0:σ12=⋯=σa2 のもとで、この統計量は近似的に χa−12 に従う。B≥χa−12(α) なら等分散性を棄却する。
M が0以上になる理由は、対数関数が凹であることにある。Ve は、水準ごとの不偏分散を重み ϕi/ϕe で平均したものである。したがって Jensen の不等式から次が成り立つ。
logVe≥i∑ϕeϕilogVi.
両辺に ϕe を掛ければ M≥0 を得る。等号は全部の Vi が等しいときに限る。
つまり M は「算術平均と幾何平均の比の対数」で、Vi がばらつくほど大きくなる。M は尤度比検定の統計量 −2logλ を不偏分散で書き直したものである。C は χ2 近似の精度を上げるための補正係数である。
Bartlett 検定は正規性からのずれに敏感で、分布の裾が重いと等分散でも棄却しやすい。正規性に不安がある場合は、範囲による確認や打点図の目視と併用する。
もう1つの方法として、繰返し数が揃っているときに最大の Vi と最小の Vi の比を見る Hartley の検定もある。比の上側点は専用の表を使う。
表 3.2 では、水準ごとの平方和は 14.8, 10, 14, 10 で、自由度はどれも4である。したがって不偏分散は 3.7, 2.5, 3.5, 2.5 で、Ve=3.05 である。統計量は次のようになる。
MC=16log3.05−4(log3.7+log2.5+log3.5+log2.5)=0.268,=1+91(1−161)=1.104,B=0.242.
χ32(0.05)=7.815 よりはるかに小さいので、等分散性は否定されない。
例題 3.3 Bartlett 検定で水準ごとのばらつきの違いを調べる ★★
オリジナルある測定装置の4つのモード A1,…,A4 で、それぞれ5回ずつ同じ試料を測り、不偏分散を求めたところ次のようになった。
V1=1.2,V2=2.5,V3=6.8,V4=3.0.
V3 が V1 の5倍以上あるので、モードによってばらつきが違うのではないかと疑われる。有意水準5%の Bartlett 検定で調べよ(χ32(0.05)=7.815)。
解答
自由度は各水準4、合計16である。自由度が等しいので Ve は単純平均で、Ve=(1.2+2.5+6.8+3.0)/4=3.375 となる。自然対数は logVe=1.2164 で、4つの logVi は 0.1823, 0.9163, 1.9169, 1.0986(和 4.1141)である。
MCB=16×1.2164−4×4.1141=19.4623−16.4565=3.006,=1+3×31(4×41−161)=1+915/16=1.104,=3.006/1.104=2.72.
B<χ32(0.05)=7.815 なので、有意水準5%で等分散性は棄却されない。
分散の比が5倍以上あるのに棄却されない理由は、各 Vi の自由度が4しかないことにある。自由度4の不偏分散はVi/σ2∼χ42/4 と大きくばらつく。たとえば χ42 の下側5%点 0.711 と上側5%点 9.49 の比は約13倍になる。繰返し数が小さい実験では、等分散性を検定で否定することは難しく、「否定されなかった」ことは「等しいことが示された」ことと同じではない。
等分散性が崩れているときの対処
水準によってばらつきが違うと判断されたとき、まず調べるのは「ばらつきが平均の大きさとともに変わっていないか」である。計数データ(不良品の個数・欠点数)では平均が大きい水準ほど分散が大きく、測定値の相対誤差が一定の現象では平均に比例して標準偏差が大きくなる。こうした場合は、データを変換してから分散分析を行うと等分散に近づけることができる。
命題 3.6(分散安定化変換)
確率変数 X の平均を θ とする。分散を V[X]=g(θ)2 と書く。滑らかな関数 h で Y=h(X) と変換する。X が θ の近くに集中しているとき、次が成り立つ。
V[h(X)]≈h′(θ)2g(θ)2.(3.19)
したがって次のように変換を選べば、V[h(X)]≈c2 は θ によらない。
h′(θ)=g(θ)c,すなわちh(θ)=∫g(θ)cdθ.
証明
h(X) を平均のまわりで1次まで Taylor 展開すると h(X)≈h(θ)+h′(θ)(X−θ)。右辺の分散は h′(θ)2V[X]=h′(θ)2g(θ)2 である。2次以降の項は X−θ が小さいときに無視できる(これはデルタ法の近似で、数理統計の解説 第5章 §5.3 の確率収束の議論で正当化される)。h′(θ)=c/g(θ) を代入すれば c2 になる。
代表的な3つの場合を挙げる。
- 計数データ(ポアソン分布):g(θ)=θ である。h(x)=x とすると c=1/2 で、変換後の分散は約 1/4 となる。
- 変動係数 κ が一定(標準偏差が平均に比例):g(θ)=κθ である。h(x)=logx とすると V≈κ2。
- n 回中の成功の割合 p^:分散の平方根は次の形である。
g(p)=p(1−p)/n.
h(p)=arcsinp とすると V≈1/(4n)(例題 3.4)。
変換後の分散分析で得た区間は変換後の尺度の区間なので、母平均の区間を報告するときは端点を逆変換する。
変換で等分散にできない場合や、繰返し数が不揃いで分散の違いが大きい場合には、水準ごとの分散を別々に推定して自由度を近似するWelch 型の分散分析を使う方法もある。これは2標本の Welch の t 検定を多水準に広げたもので、試験では名前と考え方を問われる程度である。
例題 3.4 割合データの逆正弦変換 ★★
オリジナル4つの成形条件 A1,…,A4 で、それぞれ50個ずつ部品を作ることを1回の実験とし、不良品の割合 p^ を応答にして1元配置実験を行う。
- p^ の分散が条件によって変わる理由を、p^ の分散の式から説明せよ。
- 変換 h(p)=arcsinp の導関数を求め、V[h(p^)]≈1/(4n) を示せ。
- p=0.2、n=50 のとき近似値を答えよ。また変換しない場合の V[p^] と比べよ。
解答
(1) 不良品の個数は Bin(n,p) に従うので、V[p^]=p(1−p)/n である。この式は母不良率 p に依存する。p=0.5 で最大になり、0や1に近いほど小さい。条件によって p が違えば、それだけで分散も違ってしまい、等分散性の前提が崩れる。
(2) 合成関数の微分により
h′(p)=1−p1⋅2p1=2p(1−p)1.
(3.19) に g(p)2=p(1−p)/n を入れると
V[h(p^)]≈4p(1−p)1⋅np(1−p)=4n1
となり、p によらない。
(3) 1/(4n)=1/200=0.005。変換しない場合の分散は p によって次のように5倍以上変わる。
V[p^]=500.2×0.8=0.0032 (p=0.2),0.005 (p=0.5),0.00095 (p=0.05).
変換後の分散は、近似の範囲で p によらず 0.005 である。p^ の分布を使って V[arcsinp^] を厳密に計算すると、不良率 0.2 では約 0.0052 である。近似とよく合う。
分散分析
表 3.2 の値から計算する。N=20 で、総和は T=519 である。2乗和は ∑∑xij2=13623 である。
CT=205192=20269361=13468.05,ST=13623−13468.05=154.95,
SA=51142+1352+1452+1252−CT=512996+18225+21025+15625−13468.05=13574.2−13468.05=106.15,
Se=154.95−106.15=48.80。水準ごとの平方和 14.8, 10, 14, 10 の和 48.8 と一致する。
表 3.3 焼戻し温度の実験の分散分析表| 要因 | S | ϕ | V | F0 | F3,16(0.05)/F3,16(0.01) |
| A | 106.15 | 3 | 35.38 | 11.60∗∗ | 3.239/5.292 |
| e | 48.80 | 16 | 3.050 | | |
| 計 | 154.95 | 19 | | | |
分散比 F0=35.38/3.050=11.60 は1%点 5.292 以上なので、有意水準1%で焼戻し温度の効果は有意である。寄与率は ρA=(106.15−3×3.05)/154.95=97.00/154.95=0.626 で、引張強さの変動の約63%を温度の違いが説明している。
残差の検討と正規性の確認
分散分析のあと、残差 eij=xij−xˉi⋅ を調べる。残差は誤差 εij の推定値で、構造式の前提が成り立っていれば正規分布に近い形で0のまわりに散らばるはずである。調べる点は次の3つである。
- 正規性。残差を小さい順に並べ、k 番目の残差を横軸に、標準正規分布の (k−0.5)/N 分位点を縦軸にとって打点する(正規確率プロット)。正規分布に従っていれば点はほぼ直線上に並ぶ。裾の重い分布なら両端が直線から外へ反り、歪んだ分布なら片側だけが曲がる。N=20 程度では点の揺れが大きいので、直線から大きく外れた形があるかどうかだけを見る。
- 外れ値。残差を標準化した値を見る。1つの残差の分散は V[eij]=σ2(1−1/r) である(確認テスト 3.2-4)。標準化した値 eij/Ve(1−1/r) の絶対値が3を超えるものがあれば、記録の誤りや実験の失敗を疑って原因を調べる。
- 残差と実験順序の関係。順序に沿って残差を並べたときに傾向(時間とともに増えるなど)があれば、独立性が疑われる。
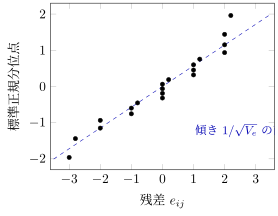
図 3.2 表 3.2 の残差 20 個の正規確率プロット。縦軸は (k−0.5)/20 の標準正規分位点。破線は残差が N(0,Ve) に従うときの目安の直線
図 3.2 では点がほぼ直線に沿って並び、裾が反る様子はない。絶対値の大きい残差は2つある。
A1 のデータ20に対する残差は −2.8 である。A3 のデータ26に対する残差は −3.0 である。これを標準化しても −3.0/3.05×0.8=−1.92 にとどまる。正規性と外れ値の点では、分散分析の結果を疑う理由はない。
残差は誤差そのものではないことに注意する。各水準の中で ∑jeij=0 という制約があるので、残差どうしは独立でない。同じ水準の2つの残差の共分散は −σ2/r になる(確認テスト 3.2-4)。r が小さいほどこの依存は強い。
正規確率プロットを厳密な検定として扱わず、目安として使う理由の1つはここにある。
分散分析後の推定
例題 3.5 最適水準の母平均・水準間の差・予測 ★★★
オリジナル表 3.2 と表 3.3 の結果を使う。引張強さは大きいほど良い。t16(0.025)=2.120 とする。
- 最適水準の母平均の点推定と95%信頼区間を求めよ。
- 最適水準と2番目に良い水準の母平均の差の95%信頼区間を求め、この実験から2つの水準の優劣を言えるかを述べよ。
- 最適水準で新たに1本処理したときの引張強さの95%予測区間を求めよ。
解答
(1) 水準平均が最大の A3 が最適水準で、μ^(A3)=xˉ3⋅=29.0 である。標準誤差は Ve/r=3.05/5=0.7810 なので
29.0±2.120×0.7810=29.0±1.66,すなわち [27.34, 30.66].
(2) 2番目は A2(水準平均 27.0)である。差の点推定は 29.0−27.0=2.0 で、標準誤差は 2Ve/r=2×3.05/5=1.1045 なので
2.0±2.120×1.1045=2.0±2.34,すなわち [−0.34, 4.34].
区間が0を含むので、有意水準5%では A3 が A2 より良いとは言えない。分散分析で A が1%で有意になったことは、「4水準のどこかに差がある」ことを意味するだけで、最良の水準が2番目の水準より良いことまでは保証しない。
A3 を採用する根拠を強めたいなら、この2水準の間で繰返しを増やした追加実験を行う。なお、最大の水準平均を選んでから区間を作ると、選んだという操作のために点推定は上に偏りやすい。このことは、ここでの区間を解釈するときに念頭に置く。
(3) (1+1/r)Ve=1.2×3.05=1.9131 なので
29.0±2.120×1.9131=29.0±4.06,すなわち [24.94, 33.06].
母平均の区間(幅 3.3)に比べて予測区間(幅 8.1)が広いのは、1本ごとの誤差 σ2 が加わるためである。
結論の書き方
この実験の結論は次のようにまとめられる。
「焼戻し温度は引張強さに有意水準1%で有意な影響を与え、寄与率は約63%である。水準平均は A3 で最大(29.0、95%信頼区間 [27.3, 30.7])で、温度に対して山形の関係にある。ただし A3 と A2 の差は5%で有意でない。範囲による確認・Bartlett 検定・残差の正規確率プロットのいずれにも、前提を疑わせる結果はなかった。」
試験の答案でも、検定の結論は「棄却する/しない」で止めず、「何の母平均が水準によって異なると言えるか」を言葉で書く。
落とし穴
分散分析の F 検定で有意にならなかったとき、「因子 A の効果はない」と書くのは誤りである。正しくは「この実験からは効果があるとは言えない」である。効果が小さいか、繰返し数が少なくて検出力が足りないかを区別するには、検出力の評価(第4章)が要る。
確認テスト
オリジナル
- 3.2-1 1元配置実験で実験順序を無作為化する理由を、無作為化しなかった場合に何が起こるかを含めて2文で述べよ。
- 3.2-2 a=4、r=4 の1元配置実験で、水準ごとの範囲が 3, 6, 2, 5 であった。範囲による等分散性の確認を行い、σ の推定値 Rˉ/d2 を求めよ。r=4 のとき d2=2.059, D4=2.282 である。
- 3.2-3 繰返し数が不揃いな1元配置で、3水準の不偏分散と自由度が次のとおりであった。
V1=2.0 (ϕ1=4),V2=8.0 (ϕ2=5),V3=3.0 (ϕ3=6).
有意水準5%の Bartlett 検定を行え(χ22(0.05)=5.991)。4. 3.2-4 繰返し数 r の1元配置で、残差 eij=xij−xˉi⋅ について次の3式を示せ。
V[eij]=σ2(1−1/r),Cov(eij,eij′)=−σ2/r (j=j′),Cov(eij,ei′j′)=0 (i=i′).
5. 3.2-5 a=3, r=4 の1元配置で SA=6, Se=36 であった。総平均は xˉˉ=20 である。A の検定を有意水準5%で行え(F2,9(0.05)=4.256)。有意でなければ A を誤差にプールして全体の母平均の95%信頼区間を求めよ(t11(0.025)=2.201)。
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com
