実験計画法 第4章 §4.1 ★★★ 平方和の分解・期待平均平方・F 分布の導出・尤度比検定との一致。記述式で「示せ」と問われる部分
第3章では、1元配置法のデータから平方和を計算し、分散分析表を作り、F0 を F 表の値と比べて判定する手順を、適用例を通して確かめた。この章では、その手順の一つ一つがなぜ正しいのかを、データの構造式と正規分布の性質から導く。
具体的には次の4つを示す。
- 平方和の分解と期待値:総平方和は、要因の平方和 SA と誤差平方和 Se にちょうど分かれる。それぞれの期待値は
E(Se)=ϕeσ2,E(SA)=ϕAσ2+r∑ai2
になる。2. F0 の分布:帰無仮説 H0:a1=⋯=aℓ=0 を考える。そのもとで、分散比は F0=VA/Ve∼FϕA,ϕe に従う。対立仮説のもとでは非心 F 分布に従う。これが「F0 が大きいときだけ棄却する」という上側片側の検定の根拠になる。3. 尤度比検定との一致:この F 検定は、構造式から効果を取り除いたモデルと元のモデルを比べる尤度比検定と同じものである。4. 区間推定:分散分析のあとで、水準ごとの母平均、2つの水準の母平均の差、新しいデータの値を、t 分布を使って区間で推定できる。2つの水準の差の検定を一度に書いた量が最小有意差(lsd)である。
資格試験の応用(理工学)の科目では、分散分析の問題は「構造式を書く → 平方和の期待値を求める → 分散分析表を作って検定する →母平均や差の信頼区間を求める」という小問の連鎖で出る。記述式なので、表の数値を埋めるだけでなく、期待値の計算や分布の導出を答案に書く必要がある。この章の導出はすべて、その答案にそのまま書ける形で書く。
この章を通して、次の記号を使う。
- 因子 A の水準数を ℓ と書く。水準数を a と書く本もあるが、効果 ai と紛れるのでこの解説では使わない。
- 各水準の繰返し数を r、データの総数を N=ℓr と書く。
データの構造式は
xij=μ+ai+εij,i=1∑ℓai=0,εij∼N(0,σ2) 独立(i=1,…,ℓ; j=1,…,r)(4.1)
である。水準 Ai の母平均を μi=μ(Ai)=μ+ai と書く。データの平均には
xˉi⋅=r1j=1∑rxij,xˉˉ=N1i=1∑ℓj=1∑rxij
を使う。誤差の平均も同じ記法で εˉi⋅, εˉˉ と書く。構造式を平均すると次のようになる。
xˉi⋅xˉˉ=μ+ai+εˉi⋅,=μ+εˉˉ(∑ai=0 を使った)
平方和の分解
各データの全平均からのずれを、水準平均を経由して2つに分ける。
xij−xˉˉ=(xˉi⋅−xˉˉ)+(xij−xˉi⋅).
右辺の第1項は「どの水準に属するか」で決まる部分、第2項は同じ水準の中でのばらつきである。両辺を2乗してすべての i,j について足すと、次が成り立つ。
定理 4.1(平方和の分解 ★★★)
STi=1∑ℓj=1∑r(xij−xˉˉ)2=SAri=1∑ℓ(xˉi⋅−xˉˉ)2+Sei=1∑ℓj=1∑r(xij−xˉi⋅)2.(4.2)
自由度も次のように分かれ、ϕT=ϕA+ϕe を満たす。
ϕT=N−1,ϕA=ℓ−1,ϕe=ℓ(r−1)=N−ℓ
証明
2乗を展開すると、交差項は
2i=1∑ℓj=1∑r(xˉi⋅−xˉˉ)(xij−xˉi⋅)=2i=1∑ℓ(xˉi⋅−xˉˉ)j=1∑r(xij−xˉi⋅)
である。内側の和は ∑jxij−rxˉi⋅=0 なので、交差項は 0 になる。第1項の2乗和は添字 j によらないので繰返し数倍になり、SA に一致する。
自由度は、2乗和に入る量の個数から制約の本数を引いて数える。
- SA:水準の数だけある量 xˉi⋅−xˉˉ の2乗和である。それらの和が 0 という制約が1本あるので、自由度は ℓ−1。
- Se:各水準でずれ xij−xˉi⋅ の和が 0 という制約が、水準の数だけある。よって自由度は N−ℓ。
計算には修正項 CT=(∑i,jxij)2/N と水準ごとの合計 Ti=∑jxij を使い、次のようにする(第2章 §2.2 の計算法)。
ST=i,j∑xij2−CT,SA=i∑rTi2−CT,Se=ST−SA
定義式 (4.2) と計算式が一致することは、次の2つから分かる。
i,j∑(xij−xˉˉ)2=i,j∑xij2−Nxˉˉ2,Nxˉˉ2=CT
平方和の期待値と期待平均平方
構造式 (4.1) を平方和に代入すると、μ はすべて消える。
xij−xˉi⋅xˉi⋅−xˉˉ=εij−εˉi⋅,=ai+(εˉi⋅−εˉˉ).(4.3)(4.4)
したがって誤差平方和は誤差だけで決まり、SA には効果と誤差の両方が入る。ここから期待値を計算する。
定理 4.2(期待平均平方 ★★★)
構造式 (4.1) のもとで
E(Se)=ℓ(r−1)σ2,E(SA)=(ℓ−1)σ2+ri=1∑ℓai2.(4.5)
したがって平均平方 Ve=Se/ϕe, VA=SA/ϕA の期待値は
E(Ve)=σ2,E(VA)=σ2+rσA2,σA2:=ℓ−11i=1∑ℓai2.(4.6)
証明
まず Se を扱う。水準 Ai の中の誤差 εi1,…,εir は、互いに独立に同じ正規分布に従う。よって偏差平方和の期待値は、不偏分散の性質から (r−1)σ2 である。直接確かめるには、次の3つの期待値を使う。
E(εij2)=σ2,E(εijεˉi⋅)=σ2/r,E(εˉi⋅2)=σ2/r
これらから
E[j=1∑r(εij−εˉi⋅)2]=j=1∑r(σ2−r2σ2+rσ2)=rσ2−σ2=(r−1)σ2.
これを ℓ 個の水準について足して E(Se)=ℓ(r−1)σ2 を得る。
次に SA を扱う。(4.4) を代入して展開すると
SA=ri∑ai2+2ri∑ai(εˉi⋅−εˉˉ)+ri∑(εˉi⋅−εˉˉ)2.
各項の期待値を順に調べる。
- 第1項は定数である。
- 第2項は誤差の1次式なので、期待値は 0 である。
- 第3項:εˉ1⋅,…,εˉℓ⋅ は N(0,σ2/r) に独立に従う。全体の誤差平均はその平均である。分散 σ2/r の独立な変数を水準の数だけ並べると、偏差平方和の期待値は (ℓ−1)σ2/r である。よって第3項の期待値は r⋅(ℓ−1)σ2/r=(ℓ−1)σ2 になる。
以上を足して (4.5) を得る。(4.6) は自由度で割っただけである。
期待平均平方 (4.6) から、検定の形が決まる。
- Ve は、帰無仮説が正しくても誤っていても σ2 の不偏推定量である。
- VA は、帰無仮説 H0:a1=⋯=aℓ=0 のもとでは同じく不偏推定量である。帰無仮説が誤っていれば、期待値が rσA2>0 だけ大きくなる。
したがって比 F0=VA/Ve は、帰無仮説のもとで 1 の近くに、対立仮説のもとで 1 より大きな値になりやすい。1 より小さくなる方向は対立仮説の証拠にならないので、棄却域は上側だけに置く。
繰返し数が水準ごとに違うとき
水準 Ai の繰返し数が水準ごとに違う値 ri のときは、効果の制約を重みつきにする。総数は N=∑ri である。制約を ∑iriai=0 と置くと xˉˉ=μ+εˉˉ が保たれ、次のようになる。
SA=i∑ri(xˉi⋅−xˉˉ)2,ϕA=ℓ−1,ϕe=N−ℓ
期待値は次のとおりで、導出は確認テスト 4.1-4 で行う。
E(Se)=(N−ℓ)σ2,E(SA)=(ℓ−1)σ2+i∑riai2
以下の検定と推定の議論は、r を ri に置き換えればそのまま成り立つ。
F0 の分布
期待値の比較だけでは、棄却域の境目を決められない。境目を決めるには F0 の分布が要る。正規母集団の標本分布について、次の事実を使う(数理統計の解説 第5章 §5.2「正規母集団からの代表的な標本分布」の内容)。
補題 4.3(正規標本の平均と偏差平方和 ★★)
次の3つが成り立つ。
- (i) Y1,…,Yn が N(m,τ2) に独立に従うとき、標本平均と偏差平方和は独立で、
τ2∑k(Yk−Yˉ)2∼χn−12.
2. (ii) 独立な U∼χm2, W∼χn2 について (U/m)/(W/n)∼Fm,n。3. (iii) 独立な Z∼N(0,1), W∼χn2 について Z/W/n∼tn。
定理 4.4(分散分析の F 検定 ★★★)
構造式 (4.1) のもとで、次が成り立つ。
- Se/σ2∼χϕe2 である。誤差平方和は水準平均の組 (xˉ1⋅,…,xˉℓ⋅) と独立で、とくに SA と独立である。
- 帰無仮説 H0:a1=⋯=aℓ=0 のもとで SA/σ2∼χϕA2 である。したがって
F0=VA/Ve∼FϕA,ϕe.
有意水準 α の検定は「F0≥FϕA,ϕe(α) なら帰無仮説を棄却する」となる。
証明
(1) 水準 Ai のデータ xi1,…,xir は、正規分布からの独立な標本である(平均は水準の母平均)。次のようにおく。
Qi:=j∑(xij−xˉi⋅)2
補題 4.3 より、水準平均と Qi は独立で、Qi/σ2∼χr−12 である。水準が違えばデータは独立なので、組 (xˉ1⋅,Q1),…,(xˉℓ⋅,Qℓ) は互いに独立になる。
したがって水準平均と Qi は、全部で 2ℓ 個がすべて互いに独立である。Se=∑iQi は独立なカイ二乗変数の和なので、カイ二乗分布の再生性から σ2χℓ(r−1)2 に従う。SA=r∑i(xˉi⋅−xˉˉ)2 は水準平均だけの関数なので(xˉˉ=ℓ1∑ixˉi⋅)、誤差平方和と独立である。
(2) 帰無仮説のもとで xˉ1⋅,…,xˉℓ⋅ は N(μ,σ2/r) に独立に従う。これに補題 4.3 を n=ℓ, τ2=σ2/r で使うと、次を得る。
σ2/r∑i(xˉi⋅−xˉˉ)2=σ2SA∼χℓ−12
(1) の独立性と補題の F 分布の定義から
F0=VeVA=(Se/σ2)/ϕe(SA/σ2)/ϕA∼FϕA,ϕe.
σ2 は分子と分母で消えるので、検定統計量は未知の誤差分散を含まずに計算できる。棄却域が上側だけになる理由は直前で述べた。
対立仮説のもとでの分布も同じ議論で求まる。xˉi⋅∼N(μ+ai,σ2/r) なので、rxˉi⋅/σ は独立な正規変数になる。その平均は r(μ+ai)/σ、分散は 1 である。平均がそろっていない正規変数の偏差平方和は非心カイ二乗分布に従う。
定義 4.5(非心カイ二乗分布と非心 F 分布)
互いに独立な確率変数 Zk∼N(mk,1) (k=1,…,n) を考える。
- ∑kZk2 の分布を非心カイ二乗分布と呼び、χn′2(λ) と書く。自由度は n、非心度は λ=∑kmk2 である。
- 独立な U∼χm′2(λ), W∼χn2 をとる。比 (U/m)/(W/n) の分布を非心 F 分布と呼ぶ。記号は Fm,n′(λ) である。
非心度が 0 のときは、それぞれ χn2 と Fm,n に戻る。また E[χn′2(λ)]=n+λ である。
偏差平方和 ∑k(Zk−Zˉ)2 は χn−1′2(λ) に従い、そのときの非心度は次になる。
λ=k∑(mk−mˉ)2
直交変換で平均の方向を1つ取り除くと、残りの n−1 成分の平均ベクトルの長さの2乗がこの値になるためである。これを Zi=rxˉi⋅/σ に使うと、mi−mˉ=rai/σ なので
σ2SA∼χϕA′2(λ),F0∼FϕA,ϕe′(λ),λ=σ2r∑iai2(4.7)
となる。E(SA/σ2)=ϕA+λ は定理 4.2 の E(SA)=ϕAσ2+r∑ai2 と一致する。検定の検出力は非心度 λ だけで決まり、
β(λ)=P(FϕA,ϕe′(λ)≥FϕA,ϕe(α))(4.8)
と書ける。非心度は次の3つで決まる。
- 繰返し数 r に比例する。
- 効果の大きさ ∑ai2 に比例する。
- 誤差分散 σ2 に反比例する。
繰返し数を2倍にすると非心度が2倍になる。さらに誤差の自由度も増えて棄却の境目 FϕA,ϕe(α) が下がるので、検出力は二重に上がる。
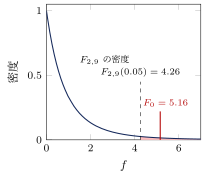
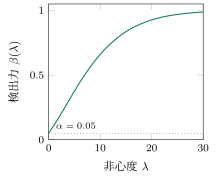
図 4.1 左:H0 のもとでの F0 の分布 F2,9 と有意水準 5% の棄却域(塗った部分)。縦の実線は例題 4.1 の F0。右:同じ自由度 (2,9)・有意水準 5% の検定の検出力 (4.8) を非心度 λ の関数として描いたもの。λ=0 で α に一致する。
構造式と検定の対応
構造式 (4.1) の各項と分散分析表の行は1対1に対応する。
- 一般平均 μ は修正項 CT に対応する(自由度 1)。
- 効果 ai は SA に対応する。自由度は ℓ−1。
- 誤差 εij は Se に対応する。自由度は N−ℓ。
2乗和全体は ∑i,jxij2=CT+SA+Se と分かれ、自由度も N=1+(ℓ−1)+(N−ℓ) と分かれる。期待平均平方の欄には、その行に対応する項の寄与と誤差の寄与 σ2 が並ぶ。
検定は「構造式からある項を取り除いてよいか」を問う手続きである。その項の行の平均平方を、その項を除いて残る成分(ここでは誤差)の平均平方で割って調べる。
この対応は、2つのモデルを比べる見方で書くとはっきりする。H0 は構造式を xij=μ+εij に縮めたモデルである。各モデルで最小二乗法によりパラメータを当てはめると、残差平方和は
- 元のモデル(水準ごとの母平均を自由に動かせる):μ^i=xˉi⋅ で、残差平方和は Se、
- 帰無仮説のモデル(共通の母平均だけ):μ^=xˉˉ で、残差平方和は ST
となる。項 ai を除いたことで残差平方和は ST−Se=SA だけ増える。SA は「ai を構造式に入れることで説明できた変動」である。F0 はこの増分を1自由度あたりに直し、誤差の1自由度あたりの大きさ Ve と比べた量である。
線形モデルとしての見方
データを N 次元ベクトル x に並べると、2つのモデルは平均ベクトルの置き場所で言い表せる。
- 元のモデル:平均が「水準ごとに一定のベクトル」の張る ℓ 次元部分空間 M1 にある。
- 帰無仮説のモデル:平均が全成分一定のベクトルの張る1次元部分空間 M0⊂M1 にある。
2つの部分空間への直交射影を H0, H1 と書く。全平均を並べたベクトルは H0x、水準平均を並べたベクトルは H1x で、
Se=∥(I−H1)x∥2,SA=∥(H1−H0)x∥2
である。射影 I−H1, H1−H0 は互いに直交する部分空間への射影で、階数はそれぞれ N−ℓ, ℓ−1 になる。2つの平方和が独立で自由度がこの階数になることは、数理統計の解説 第9章 §9.5「分散分析と変量効果モデル」の射影による議論でも導ける。
有意になった要因と有意にならなかった要因の読み方
F 検定で帰無仮説が棄却されたときに言えることは、「母平均 μ1,…,μℓ がすべて等しいとは言えない」ということだけである。どの水準とどの水準が違うのか、どれだけ違うのかは、検定の結論には含まれない。それを調べるのが §4.2 の推定である。
また F0 が大きいことは効果が大きいことと同じではない。(4.7) の非心度 λ=r∑ai2/σ2 は繰返し数に比例する。繰返しを増やせば小さな効果でも有意になる。効果の大きさは、推定値 a^i=xˉi⋅−xˉˉ や寄与率 ρA=(SA−ϕAVe)/ST で別に読む。
逆に帰無仮説が棄却されなかったときに、「水準間に差がない」と結論してはいけない。有意にならない原因は2つある。
- 効果が本当に 0 である場合。
- 効果はあるが、非心度が小さく検出力 (4.8) が低かった場合。図 4.1 の右のように、非心度が 10 程度でも検出力は 0.66 にとどまる。
実務では、有意でない要因は構造式から外して誤差に含める(プーリング)ことが多い。これは「差がない」と証明したのではなく、「差があるとは言えないので、以後の推定では区別しない」という判断である。プーリングの基準は第5章で扱う。
例題 4.1 分散分析表の作成と期待平均平方の欄 ★★★
オリジナルある部品の強度(単位は省略)を、熱処理温度 A の3水準で各4回、計12回をランダムな順序で測定し、次のデータを得た。
| 水準 | データ | 合計 Ti |
| A1 | 11 | 14 | 12 | 15 | 52 |
| A2 | 17 | 15 | 18 | 16 | 66 |
| A3 | 14 | 17 | 15 | 18 | 64 |
- 期待平均平方の欄を含む分散分析表を作り、有意水準 5% で H0:a1=a2=a3=0 を検定せよ。F2,9(0.05)=4.26, F2,9(0.01)=8.02 とする。
- σ2 と σA2=21∑ai2 の不偏推定値を求めよ。
解答
(1) 総計は T=52+66+64=182, N=12 なので CT=1822/12=2760.333 である。データの2乗和は水準ごとに次のとおりである。
A1A2A3: 121+196+144+225=686,: 289+225+324+256=1094,: 196+289+225+324=1034.
合計は 2814 である。よって
ST=2814−2760.333=53.667,SA=4522+662+642−CT=411156−2760.333=28.667,
Se=ST−SA=25.000 である(水準ごとの偏差平方和 10,5,10 の和とも一致する)。自由度は ϕA=2, ϕe=9 なので
| 要因 | 平方和 | 自由度 | 平均平方 | F0 | E(V) |
| A | 28.667 | 2 | 14.333 | 5.16∗ | σ2+4σA2 |
| e | 25.000 | 9 | 2.778 | | σ2 |
| 計 | 53.667 | 11 | | | |
となる。分散比は F0=14.333/2.778=5.16 で、次の2つの境目の間にある。
F2,9(0.05)=4.26 ≤ F0 < F2,9(0.01)=8.02
よって有意水準 5% で帰無仮説を棄却する(有意水準 1% では棄却されない)。熱処理温度によって強度の母平均は異なると言える。
(2) E(Ve)=σ2 より σ^2=Ve=2.778 である。E(VA)=σ2+4σA2 より E((VA−Ve)/4)=σA2 なので、不偏推定値は
σ^A2=(14.333−2.778)/4=2.889
である。参考に寄与率は ρA=(28.667−2×2.778)/53.667=0.431 である。
例題 4.2 F 検定と尤度比検定の一致 ★★
オリジナル構造式 (4.1) で σ2 も未知とする。
- 帰無仮説 H0:a1=⋯=aℓ=0 の尤度比 Λ=supLsupH0L を求めよ。それが (Se/ST)N/2 となることを示せ。
- 尤度比が F0 の単調減少関数であることを示せ。また、尤度比検定と F 検定が同じ棄却域を与えることを説明せよ。
- 例題 4.1 のデータで −2logΛ を計算し、漸近分布 χ22 の上側 5% 点 5.99 と比べよ。
解答
(1) パラメータ (μ1,…,μℓ,σ2) の尤度は
L=(2πσ2)−N/2exp(−2σ21i,j∑(xij−μi)2).
母平均を動かして最大にするには、∑i,j(xij−μi)2 を最小にすればよい。最小は μ^i=xˉi⋅ で、最小値は Se になる。次に対数尤度を σ2 で微分して 0 と置く。
ℓ(σ2)−2σ2N+2σ4Se=−2Nlog(2πσ2)−2σ2Se,=0⟹σ^2=Se/N.
代入すると supL=(2πSe/N)−N/2e−N/2 である。
帰無仮説のもとでは、共通の母平均について同じ計算をする。
μ^=xˉˉ,残差平方和=ST,σ^02=ST/N,H0supL=(2πST/N)−N/2e−N/2
比をとると共通の因子が消えて、Λ=(ST/Se)−N/2=(Se/ST)N/2 である。
(2) ST=SA+Se より SeST=1+SeSA=1+ϕeϕAF0 なので
Λ=(1+ϕeϕAF0)−N/2
は F0≥0 の狭義単調減少関数である。尤度比検定は「Λ≤c なら棄却」なので、「F0≥c′ なら棄却」と同じ形になる。サイズを α にそろえると c′=FϕA,ϕe(α) と決まり、二つの検定は棄却域が一致する。
F 検定は、帰無仮説のもとで分布が厳密に成り立つ。そのため、漸近近似を使う尤度比検定のカイ二乗近似より正確である。
(3) ST/Se=53.667/25=2.1467 で、これは 1+92×5.16 とも一致する。よって
−2logΛ=Nlog(ST/Se)=12log2.1467=9.17.
χ22(0.05)=5.99 を超えるので、漸近的な尤度比検定でも有意水準 5% で棄却される。
確認テスト
オリジナル
- 4.1-1 水準数 5、繰返し数 6 の1元配置法で、自由度 ϕA, ϕe, ϕT を求めよ。さらに E(VA) を誤差分散と効果で書け。F0 の棄却域を、有意水準 5% で F 分布の上側点の記号で書け。
- 4.1-2 水準数 4、繰返し数 3 の1元配置法で、次の値を得た。
xˉ1⋅=10,xˉ2⋅=12,xˉ3⋅=11,xˉ4⋅=15,Se=24分散分析表を作り、有意水準 5% と 1% で検定せよ。F3,8(0.05)=4.07, F3,8(0.01)=7.59 とする。3. 4.1-3 ℓ=3, r=5 で、効果が (a1,a2,a3)=(−2,0,2)、誤差の標準偏差が 2 とする。E(VA), E(Ve) と非心度 λ を求めよ。有意水準 5% の F 検定の検出力を、非心 F 分布の確率として書け。4. 4.1-4 繰返し数が水準ごとに ri で、効果に ∑iriai=0 を課したモデルを考える。次の期待値の式を示せ。
E[i∑ri(xˉi⋅−xˉˉ)2]=(ℓ−1)σ2+i∑riai2
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com
