実験計画法 第10章 §10.1 ★★ 2水準系では「2列とその交互作用の列」の3列を1本の4水準の列とみなす。平方和は3列の列平方和の和
第8章と第9章では、2水準の因子を2水準系の表に、3水準の因子を3水準系の表に置いた。実際の実験では、4水準の因子を2水準系の表に入れたい場合や、3水準の因子と2水準の因子が混在する場合がある。この章では、そのための2つの方法を道具として作る。
1つ目の多水準法 は、2水準系の表の3本の列をまとめて1本の4水準の列として使う方法である(§10.1)。最初に、どの3列をまとめればよいかを第8章の交互作用の規則から決め、その3列の列平方和の和が4水準の因子の平方和に一致することを証明する。続いて、4水準の因子とほかの因子の交互作用が現れる列、期待平均平方、有効反復数を導く。
2つ目の擬水準法 は、列の水準数より因子の水準数が少ないとき、因子のある水準を重複させて列の水準を埋める方法である(§10.2 )。3水準の因子を多水準法で作った4水準の列に置く場合と、2水準の因子を3水準系の表の列に置く場合を扱う。擬水準法では水準ごとのデータ数がそろわないので、平方和の計算と有効反復数の求め方が第8章とは変わる。とくに、有効反復数について田口の式は使えず、伊奈の式は使えることを、推定量の分散を直接計算して示す。
1級の統計応用(理工学)で直交配列表の問題が出る場合、この章の道具は「因子の水準数と表の列を見比べて割り付けを決める → 自由度を数えて誤差の自由度を確かめる → 水準ごとのデータ数に注意して平方和を計算する →推定式と有効反復数を書く」という形で使う。
3列をまとめると4水準の列になる
第8章の L 8 ( 2 7 ) L_8(2^7) L 8 ( 2 7 ) ( 1 , 1 ) , ( 1 , 1 ) , ( 1 , 2 ) , ( 1 , 2 ) , ( 2 , 1 ) , ( 2 , 1 ) , ( 2 , 2 ) , ( 2 , 2 ) (1,1),(1,1),(1,2),(1,2),(2,1),(2,1),(2,2),(2,2) ( 1 , 1 ) , ( 1 , 1 ) , ( 1 , 2 ) , ( 1 , 2 ) , ( 2 , 1 ) , ( 2 , 1 ) , ( 2 , 2 ) , ( 2 , 2 )
( 1 , 1 ) ↦ 1 , ( 1 , 2 ) ↦ 2 , ( 2 , 1 ) ↦ 3 , ( 2 , 2 ) ↦ 4 (10.1) (1,1)\mapsto 1,\qquad (1,2)\mapsto 2,\qquad (2,1)\mapsto 3,\qquad (2,2)\mapsto 4\tag{10.1} ( 1 , 1 ) ↦ 1 , ( 1 , 2 ) ↦ 2 , ( 2 , 1 ) ↦ 3 , ( 2 , 2 ) ↦ 4 ( 10.1 )
と対応させれば、4水準の因子 A A A 10.1 )。
このとき列[3]をほかの因子に使うことはできない。第8章の定理(交互作用の列)により、列[3]の水準は列[1]と列[2]の水準から決まる(成分記号で a b = a ⋅ b ab=a\cdot b ab = a ⋅ b A A A A A A
列[3]に別の因子 B B B A A A 1 + 1 + 1 1+1+1 1 + 1 + 1
表 10.1 L 8 ( 2 7 ) L_8(2^7) L 8 ( 2 7 ) A A A 実験 No. A A A [4] [5] [6] [7] 1 1 1 1 1 1 2 1 2 2 2 2 3 2 1 1 2 2 4 2 2 2 1 1 5 3 1 2 1 2 6 3 2 1 2 1 7 4 1 2 2 1 8 4 2 1 1 2
定義 10.1(多水準法)
2水準系の直交配列表で、次の手順で4水準の因子を割り付ける方法を多水準法 (多水準作成法)と呼ぶ。
列 [ j ] , [ k ] [j],[k] [ j ] , [ k ] j ⊕ k j\oplus k j ⊕ k
列 [ j ] , [ k ] [j],[k] [ j ] , [ k ]
同じ考え方で、互いに独立な p p p 2 p 2^p 2 p 2 p − 1 2^p-1 2 p − 1
ここで「互いに独立な列」とは、どの列も残りの列の成分記号の積として書けない列のことである。たとえば L 16 L_{16} L 16 3 = 1 ⊕ 2 3=1\oplus2 3 = 1 ⊕ 2
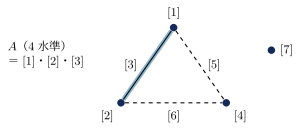
線点図で言えば、4水準の因子は1本の線とその両端の2点、合わせて3列を占める。図 10.1 は、L 8 L_8 L 8 A A A
図 10.1 L 8 L_8 L 8 A A A B B B A × B A\times B A × B
4水準の因子の平方和
データを x 1 , … , x N x_1,\dots,x_N x 1 , … , x N k k k u k \bm u_k u k + 1 +1 + 1 − 1 -1 − 1
S [ k ] = ( u k ⊤ x ) 2 N = ( T k 1 − T k 2 ) 2 N S_{[k]}=\frac{(\bm u_k^\top\bm x)^2}N=\frac{(T_{k1}-T_{k2})^2}N S [ k ] = N ( u k ⊤ x ) 2 = N ( T k 1 − T k 2 ) 2
と書く。4水準の因子の水準 i i i T A i T_{A_i} T A i N / 4 N/4 N /4
定理 10.2(多水準の因子の平方和 ★★)
4水準の因子 A A A [ j ] , [ k ] [j],[k] [ j ] , [ k ]
S A = ∑ i = 1 4 T A i 2 N / 4 − C T = S [ j ] + S [ k ] + S [ j ⊕ k ] , ϕ A = 3. (10.2) S_A=\sum_{i=1}^{4}\frac{T_{A_i}^2}{N/4}-CT=S_{[j]}+S_{[k]}+S_{[j\oplus k]},\qquad \phi_A=3 .\tag{10.2} S A = i = 1 ∑ 4 N /4 T A i 2 − C T = S [ j ] + S [ k ] + S [ j ⊕ k ] , ϕ A = 3. ( 10.2 )
証明 2本の列の符号の組 ( s , t ) ∈ { + 1 , − 1 } 2 (s,t)\in\{+1,-1\}^2 ( s , t ) ∈ { + 1 , − 1 } 2 A A A g ( s , t ) \bm g_{(s,t)} g ( s , t ) r r r
( 1 + s u r j ) ( 1 + t u r k ) 4 \frac{(1+s\,u_{rj})(1+t\,u_{rk})}4 4 ( 1 + s u r j ) ( 1 + t u r k )
に等しい。u r j = s u_{rj}=s u r j = s u r k = t u_{rk}=t u r k = t
g ( s , t ) = 1 4 ( 1 + s u j + t u k + s t u j ⊙ u k ) = 1 4 ( 1 + s u j + t u k + s t u j ⊕ k ) (10.3) \bm g_{(s,t)}=\frac14\bigl(\bm 1+s\,\bm u_j+t\,\bm u_k+st\,\bm u_j\odot\bm u_k\bigr)=\frac14\bigl(\bm 1+s\,\bm u_j+t\,\bm u_k+st\,\bm u_{j\oplus k}\bigr)\tag{10.3} g ( s , t ) = 4 1 ( 1 + s u j + t u k + s t u j ⊙ u k ) = 4 1 ( 1 + s u j + t u k + s t u j ⊕ k ) ( 10.3 )
である。ここで第8章の定理(交互作用の列)により、成分ごとの積 u j ⊙ u k \bm u_j\odot\bm u_k u j ⊙ u k j ⊕ k j\oplus k j ⊕ k (10.3) から、4本の指示ベクトルが張る空間 W W W
1 , u j , u k , u j ⊕ k \bm 1,\quad \bm u_j,\quad \bm u_k,\quad \bm u_{j\oplus k} 1 , u j , u k , u j ⊕ k
どちらの組も互いに直交する0でない4本のベクトルなので、両方とも4次元であり、2つの空間は一致する。
x \bm x x W W W N / 4 N/4 N /4
∥ P W x ∥ 2 = ∑ ( s , t ) ( g ( s , t ) ⊤ x ) 2 g ( s , t ) ⊤ g ( s , t ) = ∑ i = 1 4 T A i 2 N / 4 . \lVert P_W\bm x\rVert ^2=\sum_{(s,t)}\frac{(\bm g_{(s,t)}^\top\bm x)^2}{\bm g_{(s,t)}^\top\bm g_{(s,t)}}=\sum_{i=1}^4\frac{T_{A_i}^2}{N/4}. ∥ P W x ∥ 2 = ( s , t ) ∑ g ( s , t ) ⊤ g ( s , t ) ( g ( s , t ) ⊤ x ) 2 = i = 1 ∑ 4 N /4 T A i 2 .
一方、上の4本をそれぞれ N \sqrt N N
∥ P W x ∥ 2 = ( 1 ⊤ x ) 2 N + ( u j ⊤ x ) 2 N + ( u k ⊤ x ) 2 N + ( u j ⊕ k ⊤ x ) 2 N = C T + S [ j ] + S [ k ] + S [ j ⊕ k ] . \lVert P_W\bm x\rVert ^2=\frac{(\bm 1^\top\bm x)^2}{N}+\frac{(\bm u_j^\top\bm x)^2}{N}+\frac{(\bm u_k^\top\bm x)^2}{N}+\frac{(\bm u_{j\oplus k}^\top\bm x)^2}{N}
=CT+S_{[j]}+S_{[k]}+S_{[j\oplus k]} . ∥ P W x ∥ 2 = N ( 1 ⊤ x ) 2 + N ( u j ⊤ x ) 2 + N ( u k ⊤ x ) 2 + N ( u j ⊕ k ⊤ x ) 2 = C T + S [ j ] + S [ k ] + S [ j ⊕ k ] .
両者を等しいとおいて C T CT C T (10.2) を得る。
定理の左の式は、4水準・繰返し N / 4 N/4 N /4
表の上で3列の列平方和を足す。
A A A
試験の計算では後者の方が手早く、前者は検算に使う。
ほかの因子との直交性と交互作用の列
多水準の因子を置いた3列以外の列[m m m (10.3) から g ( s , t ) ⊤ u m = 0 \bm g_{(s,t)}^\top\bm u_m=0 g ( s , t ) ⊤ u m = 0 A A A N / 8 N/8 N /8
これが、4水準の因子とほかの列の因子が互いに釣り合っているということである。A A A
4水準の因子 A A A [ j ] , [ k ] , [ j ⊕ k ] [j],[k],[j\oplus k] [ j ] , [ k ] , [ j ⊕ k ] B B B l l l
[ j ⊕ l ] , [ k ⊕ l ] , [ j ⊕ k ⊕ l ] (10.4) [j\oplus l],\qquad [k\oplus l],\qquad [j\oplus k\oplus l]\tag{10.4} [ j ⊕ l ] , [ k ⊕ l ] , [ j ⊕ k ⊕ l ] ( 10.4 )
に現れ、自由度は 3 × 1 = 3 3\times1=3 3 × 1 = 3
理由は次のとおりである。A i B m A_iB_m A i B m (10.3) に ( 1 ± u l ) / 2 (1\pm\bm u_l)/2 ( 1 ± u l ) /2
1 , u j , u k , u j ⊕ k , u l と u j ⊕ l , u k ⊕ l , u j ⊕ k ⊕ l \bm 1,\ \bm u_j,\ \bm u_k,\ \bm u_{j\oplus k},\ \bm u_l\quad\text{と}\quad \bm u_{j\oplus l},\ \bm u_{k\oplus l},\ \bm u_{j\oplus k\oplus l} 1 , u j , u k , u j ⊕ k , u l と u j ⊕ l , u k ⊕ l , u j ⊕ k ⊕ l
このうち主効果に当たらない後ろの3本が、交互作用の自由度3を担う。したがって
S A × B = S [ j ⊕ l ] + S [ k ⊕ l ] + S [ j ⊕ k ⊕ l ] S_{A\times B}=S_{[j\oplus l]}+S_{[k\oplus l]}+S_{[j\oplus k\oplus l]} S A × B = S [ j ⊕ l ] + S [ k ⊕ l ] + S [ j ⊕ k ⊕ l ]
である。
L 8 L_8 L 8
4水準の因子を列[1]・[2]・[3]に置き、B B B 10.1 )。
1 ⊕ 4 = 5 , 2 ⊕ 4 = 6 , 3 ⊕ 4 = 7 1\oplus4=5,\qquad 2\oplus4=6,\qquad 3\oplus4=7 1 ⊕ 4 = 5 , 2 ⊕ 4 = 6 , 3 ⊕ 4 = 7
7列はこれで使い切るので、交互作用を求めるなら誤差の列が残らない。交互作用を無視できるなら、列[5]〜[7]に2水準の因子を置くか、誤差の列とする。
期待平均平方と推定
水準 i i i a i a_i a i A A A x ˉ A i = T A i / ( N / 4 ) \bar x_{A_i}=T_{A_i}/(N/4) x ˉ A i = T A i / ( N /4 ) μ + a i \mu+a_i μ + a i N / 4 N/4 N /4
E ( V A ) = σ 2 + N 4 ⋅ ∑ i = 1 4 a i 2 3 (10.5) E(V_A)=\sigma^2+\frac{N}{4}\cdot\frac{\sum_{i=1}^4a_i^2}{3}\tag{10.5} E ( V A ) = σ 2 + 4 N ⋅ 3 ∑ i = 1 4 a i 2 ( 10.5 )
を得る(確認テスト 10.1-4 で、列の符号から直接導く)。検定は F 0 = V A / V e F_0=V_A/V_e F 0 = V A / V e F 3 , ϕ e ( α ) F_{3,\phi_e}(\alpha) F 3 , ϕ e ( α )
母平均の点推定と有効反復数は第8章と同じ形である。たとえば A A A B B B
μ ^ ( A i B m ) = x ˉ A i + x ˉ B m − x ˉ , 1 n e = 1 N / 4 + 1 N / 2 − 1 N = 5 N \hat\mu(A_iB_m)=\bar x_{A_i}+\bar x_{B_m}-\bar x,\qquad
\frac{1}{n_e}=\frac{1}{N/4}+\frac{1}{N/2}-\frac1N=\frac{5}{N} μ ^ ( A i B m ) = x ˉ A i + x ˉ B m − x ˉ , n e 1 = N /4 1 + N /2 1 − N 1 = N 5
である(伊奈の式)。田口の式でも、推定に用いた要因の自由度の和は ϕ A + ϕ B = 3 + 1 = 4 \phi_A+\phi_B=3+1=4 ϕ A + ϕ B = 3 + 1 = 4 1 / n e = ( 1 + 4 ) / N = 5 / N 1/n_e=(1+4)/N=5/N 1/ n e = ( 1 + 4 ) / N = 5/ N
例題 10.1 L 8 L_8 L 8
オリジナル
4水準の因子 A A A B , C B,C B , C 10.1 のとおり、次のように割り付けた。
A : 列[1]・[2]・[3] , B : 列[4] , C : 列[7] A:\ \text{列[1]・[2]・[3]},\qquad B:\ \text{列[4]},\qquad C:\ \text{列[7]} A : 列 [1] ・ [2] ・ [3] , B : 列 [4] , C : 列 [7]
交互作用はすべて無視できるとし、列[5]・[6]を誤差とする。特性値は大きいほど望ましい。実験 No. 1〜8 の順に
20 , 17 , 25 , 24 , 30 , 27 , 26 , 21 20,\ 17,\ 25,\ 24,\ 30,\ 27,\ 26,\ 21 20 , 17 , 25 , 24 , 30 , 27 , 26 , 21
を得た。
S A S_A S A S [ 1 ] + S [ 2 ] + S [ 3 ] S_{[1]}+S_{[2]}+S_{[3]} S [ 1 ] + S [ 2 ] + S [ 3 ] 分散分析表を作れ。F 0 F_0 F 0
最適条件を決め、その母平均の点推定値、有効反復数、95%信頼区間を求めよ(t 3 ( 0.025 ) = 3.182 t_3(0.025)=3.182 t 3 ( 0.025 ) = 3.182
解答 (1) 総平方和までを求める。
T = 190 , C T = 190 2 8 = 4512.5 , ∑ x r 2 = 4636 , S T = 4636 − 4512.5 = 123.5. T=190,\qquad CT=\frac{190^2}8=4512.5,\qquad \sum x_r^2=4636,\qquad S_T=4636-4512.5=123.5 . T = 190 , C T = 8 19 0 2 = 4512.5 , ∑ x r 2 = 4636 , S T = 4636 − 4512.5 = 123.5.
A A A A 1 , A 2 , A 3 , A 4 A_1,A_2,A_3,A_4 A 1 , A 2 , A 3 , A 4
T A 1 = 37 , T A 2 = 49 , T A 3 = 57 , T A 4 = 47. T_{A_1}=37,\qquad T_{A_2}=49,\qquad T_{A_3}=57,\qquad T_{A_4}=47 . T A 1 = 37 , T A 2 = 49 , T A 3 = 57 , T A 4 = 47.
各水準のデータ数は2なので
S A = 37 2 + 49 2 + 57 2 + 47 2 2 − 4512.5 = 9228 2 − 4512.5 = 101.5. S_A=\frac{37^2+49^2+57^2+47^2}{2}-4512.5=\frac{9228}{2}-4512.5=101.5 . S A = 2 3 7 2 + 4 9 2 + 5 7 2 + 4 7 2 − 4512.5 = 2 9228 − 4512.5 = 101.5.
一方、3列の水準1・水準2の和 ( T k 1 , T k 2 ) (T_{k1},T_{k2}) ( T k 1 , T k 2 )
列[1] : ( 86 , 104 ) , S [ 1 ] = 18 2 / 8 = 40.5 , 列[2] : ( 94 , 96 ) , S [ 2 ] = 2 2 / 8 = 0.5 , 列[3] : ( 84 , 106 ) , S [ 3 ] = 22 2 / 8 = 60.5. \begin{aligned}\text{列[1]}&:\ (86,104), & S_{[1]}&=18^2/8=40.5,\\
\text{列[2]}&:\ (94,96), & S_{[2]}&=2^2/8=0.5,\\
\text{列[3]}&:\ (84,106), & S_{[3]}&=22^2/8=60.5.\end{aligned} 列 [1] 列 [2] 列 [3] : ( 86 , 104 ) , : ( 94 , 96 ) , : ( 84 , 106 ) , S [ 1 ] S [ 2 ] S [ 3 ] = 1 8 2 /8 = 40.5 , = 2 2 /8 = 0.5 , = 2 2 2 /8 = 60.5.
和は 101.5 となり一致する。
(2) 残りの列も同じように計算する。
列[4] ( B ) : ( 101 , 89 ) , S B = 12 2 / 8 = 18 , 列[7] ( C ) : ( 97 , 93 ) , S C = 4 2 / 8 = 2 , 列[5] ( e ) : ( 93 , 97 ) , S [ 5 ] = 2 , 列[6] ( e ) : ( 95 , 95 ) , S [ 6 ] = 0. \begin{aligned}\text{列[4]}\ (B)&:\ (101,89), & S_B&=12^2/8=18,\\
\text{列[7]}\ (C)&:\ (97,93), & S_C&=4^2/8=2,\\
\text{列[5]}\ (e)&:\ (93,97), & S_{[5]}&=2,\\
\text{列[6]}\ (e)&:\ (95,95), & S_{[6]}&=0.\end{aligned} 列 [4] ( B ) 列 [7] ( C ) 列 [5] ( e ) 列 [6] ( e ) : ( 101 , 89 ) , : ( 97 , 93 ) , : ( 93 , 97 ) , : ( 95 , 95 ) , S B S C S [ 5 ] S [ 6 ] = 1 2 2 /8 = 18 , = 4 2 /8 = 2 , = 2 , = 0.
誤差は S e = 2 + 0 = 2 S_e=2+0=2 S e = 2 + 0 = 2 ϕ e = 2 \phi_e=2 ϕ e = 2 101.5 + 18 + 2 + 2 = 123.5 = S T 101.5+18+2+2=123.5=S_T 101.5 + 18 + 2 + 2 = 123.5 = S T
要因 S S S ϕ \phi ϕ V V V F 0 F_0 F 0 A A A 101.5 3 33.83 33.83 B B B 18.0 1 18.00 18.00 C C C 2.0 1 2.00 2.00 e e e 2.0 2 1.00 計 123.5 7
C C C F 0 = 2 F_0=2 F 0 = 2
S e = 4 , ϕ e = 3 , V e = 4 / 3 S_e=4,\qquad \phi_e=3,\qquad V_e=4/3 S e = 4 , ϕ e = 3 , V e = 4/3
で、
F 0 ( A ) = 33.83 / ( 4 / 3 ) = 25.38 > F 3 , 3 ( 0.05 ) = 9.28 , F 0 ( B ) = 18 / ( 4 / 3 ) = 13.5 > F 1 , 3 ( 0.05 ) = 10.13 \begin{aligned}F_0(A)&=33.83/(4/3)=25.38>F_{3,3}(0.05)=9.28,\\
F_0(B)&=18/(4/3)=13.5>F_{1,3}(0.05)=10.13\end{aligned} F 0 ( A ) F 0 ( B ) = 33.83/ ( 4/3 ) = 25.38 > F 3 , 3 ( 0.05 ) = 9.28 , = 18/ ( 4/3 ) = 13.5 > F 1 , 3 ( 0.05 ) = 10.13
となる。A A A B B B F 3 , 3 ( 0.01 ) = 29.46 F_{3,3}(0.01)=29.46 F 3 , 3 ( 0.01 ) = 29.46 F 1 , 3 ( 0.01 ) = 34.12 F_{1,3}(0.01)=34.12 F 1 , 3 ( 0.01 ) = 34.12
(3) 水準ごとの平均は次のとおりである。
x ˉ A 1 = 18.5 , x ˉ A 2 = 24.5 , x ˉ A 3 = 28.5 , x ˉ A 4 = 23.5 , x ˉ B 1 = 25.25 , x ˉ B 2 = 22.25 , x ˉ = 23.75. \begin{aligned}&\bar x_{A_1}=18.5,\quad \bar x_{A_2}=24.5,\quad \bar x_{A_3}=28.5,\quad \bar x_{A_4}=23.5,\\
&\bar x_{B_1}=25.25,\quad \bar x_{B_2}=22.25,\quad \bar x=23.75 .\end{aligned} x ˉ A 1 = 18.5 , x ˉ A 2 = 24.5 , x ˉ A 3 = 28.5 , x ˉ A 4 = 23.5 , x ˉ B 1 = 25.25 , x ˉ B 2 = 22.25 , x ˉ = 23.75.
最適条件は A 3 B 1 A_3B_1 A 3 B 1
μ ^ ( A 3 B 1 ) = x ˉ A 3 + x ˉ B 1 − x ˉ = 28.5 + 25.25 − 23.75 = 30.0. \hat\mu(A_3B_1)=\bar x_{A_3}+\bar x_{B_1}-\bar x=28.5+25.25-23.75=30.0 . μ ^ ( A 3 B 1 ) = x ˉ A 3 + x ˉ B 1 − x ˉ = 28.5 + 25.25 − 23.75 = 30.0.
伊奈の式で
1 n e = 1 2 + 1 4 − 1 8 = 5 8 , n e = 1.6. \frac1{n_e}=\frac12+\frac14-\frac18=\frac58,\qquad n_e=1.6 . n e 1 = 2 1 + 4 1 − 8 1 = 8 5 , n e = 1.6.
田口の式でも ( 1 + 3 + 1 ) / 8 = 5 / 8 (1+3+1)/8=5/8 ( 1 + 3 + 1 ) /8 = 5/8
30.0 ± t 3 ( 0.025 ) V e n e = 30.0 ± 3.182 4 / 3 1.6 = 30.0 ± 2.90 , 30.0\pm t_3(0.025)\sqrt{\frac{V_e}{n_e}}=30.0\pm3.182\sqrt{\frac{4/3}{1.6}}=30.0\pm2.90, 30.0 ± t 3 ( 0.025 ) n e V e = 30.0 ± 3.182 1.6 4/3 = 30.0 ± 2.90 ,
すなわち [ 27.10 , 32.90 ] [27.10,\ 32.90] [ 27.10 , 32.90 ]
例題 10.2 L 16 L_{16} L 16
オリジナル
4水準の因子 A A A B , C , D , F B,C,D,F B , C , D , F A × B A\times B A × B B × C B\times C B × C
必要な自由度を数え、L 8 L_8 L 8 L 16 L_{16} L 16
L 16 L_{16} L 16 A A A
解答 (1) 必要な自由度を数える。
主効果:A A A B , C , D , F B,C,D,F B , C , D , F
交互作用:A × B A\times B A × B 3 × 1 = 3 3\times1=3 3 × 1 = 3 B × C B\times C B × C
合計は 7 + 3 + 1 = 11 7+3+1=11 7 + 3 + 1 = 11 L 8 L_8 L 8 L 16 L_{16} L 16 15 − 11 = 4 15-11=4 15 − 11 = 4
(2) 割り付けの一例を示す。
A A A 1 ⊕ 2 = 3 1\oplus2=3 1 ⊕ 2 = 3 B B B (10.4) より、A × B A\times B A × B [ 1 ⊕ 4 ] = [ 5 ] [1\oplus4]=[5] [ 1 ⊕ 4 ] = [ 5 ] C C C B × C B\times C B × C [ 4 ⊕ 8 ] = [ 12 ] [4\oplus8]=[12] [ 4 ⊕ 8 ] = [ 12 ] D D D F F F
使った列は 1〜8, 12, 14, 15 で、互いに重ならない。誤差の列は [9]・[10]・[11]・[13] で、誤差の自由度は4である。列[9]・[10]・[11]には、無視できると仮定した A × C A\times C A × C 1 ⊕ 8 = 9 1\oplus8=9 1 ⊕ 8 = 9
(3) 列[1]・[2]の水準の組が決まると、列[3]の水準も決まる。4水準の因子は列[1]・[2]の組で水準を決めるので、3本目は必ずその積の列[3]になる。列[1]・[2]・[4]の3本は互いに独立で、その水準の組は 2 3 = 8 2^3=8 2 3 = 8 A A A A A A
3水準系での多水準法
3水準系でも同じ考え方を使う。3水準系の表で互いに独立な2列の水準の組は 3 2 = 9 3^2=9 3 2 = 9 a b ab ab a b 2 ab^2 a b 2 2 × 4 = 8 = 9 − 1 2\times4=8=9-1 2 × 4 = 8 = 9 − 1
たとえば L 27 ( 3 13 ) L_{27}(3^{13}) L 27 ( 3 13 ) a , b , a b , a b 2 a,\ b,\ ab,\ ab^2 a , b , ab , a b 2
確認テスト
オリジナル
10.1-1 L 8 ( 2 7 ) L_8(2^7) L 8 ( 2 7 ) 10.1-2 表 10.1 の割り付けで A A A S A S_A S A S [ 1 ] , S [ 2 ] , S [ 3 ] S_{[1]},S_{[2]},S_{[3]} S [ 1 ] , S [ 2 ] , S [ 3 ] S T S_T S T 10.1-3 L 16 ( 2 15 ) L_{16}(2^{15}) L 16 ( 2 15 ) A A A C C C C C C A × C A\times C A × C 10.1-4 4水準の因子 A A A [ j ] , [ k ] , [ j ⊕ k ] [j],[k],[j\oplus k] [ j ] , [ k ] , [ j ⊕ k ]
x = μ 1 + ∑ i = 1 4 a i g i + ( ほかの列の効果 ) + ε \bm x=\mu\bm 1+\sum_{i=1}^4a_i\bm g_i+(\text{ほかの列の効果})+\bm\varepsilon x = μ 1 + i = 1 ∑ 4 a i g i + ( ほかの列の効果 ) + ε
とする。g i \bm g_i g i A i A_i A i
E ( S A ) = 3 σ 2 + N 4 ∑ i a i 2 E(S_A)=3\sigma^2+\frac N4\sum_{i}a_i^2 E ( S A ) = 3 σ 2 + 4 N i ∑ a i 2
使ってよいのは、定理 10.2 の分解 S A = S [ j ] + S [ k ] + S [ j ⊕ k ] S_A=S_{[j]}+S_{[k]}+S_{[j\oplus k]} S A = S [ j ] + S [ k ] + S [ j ⊕ k ]
E ( S [ m ] ) = σ 2 + ( E [ u m ⊤ x ] ) 2 N E(S_{[m]})=\sigma^2+\frac{(E[\bm u_m^\top\bm x])^2}N E ( S [ m ] ) = σ 2 + N ( E [ u m ⊤ x ] ) 2 10.1-5 例題 10.1 で、最適条件 A 3 B 1 A_3B_1 A 3 B 1 A 1 B 1 A_1B_1 A 1 B 1
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com