実験計画法 第11章 §11.1 ★★★ ブロック因子を変量として構造式に入れ、期待平均平方・検定・推定・分散成分の推定を導く
実験を何日かに分けて行うと、日によって室温や原料の状態が変わり、同じ条件でも測定値の水準がずれる。このずれを放っておくと、すべて誤差に混ざって誤差分散が大きくなり、本当は差のある要因が「有意でない」と判定されることになる。乱塊法 (randomized block design)は、このずれを生む単位(日、原料のロット、装置、圃場の区画など)をブロック としてまとめ、各ブロックの中で要因のすべての水準を1回ずつ無作為な順に実施する計画である。
解析では、ブロックを1つの因子として分散分析表に1行立て、ブロック間の変動を誤差から分けて取り出す。
この章で作る道具は4つある。
ブロックを変量因子とみなしたデータの構造式と、その下での期待平均平方。
要因の検定が、繰返しのない2元配置(第6章)と同じ計算で済む理由。
分散分析後の推定の非対称性。水準の母平均そのものの信頼区間にはブロックの分散成分が入るのに、水準間の差の信頼区間には入らない。
ブロック因子の分散成分 σ R 2 \sigma_R^2 σ R 2 σ R 2 / σ 2 \sigma_R^2/\sigma^2 σ R 2 / σ 2 F F F
統計応用(理工学)の実験計画法の大問では、「データから分散分析表を作る → 期待平均平方を書く → 検定する →最適水準の母平均と差を区間推定する → ブロックの分散成分を推定する」という連鎖で、この章の道具がそのまま使われる。
局所管理という考え方
Fisher は実験の計画に3つの原則を置いた。
反復 :同じ条件を複数回行い、誤差の大きさを推定できるようにする。無作為化 :実験の順序や割り付けを乱数で決め、系統的なずれが特定の水準に偏ってかからないようにする。局所管理 :実験の場を均一な小さいまとまりに分け、まとまりの中で比較する。
乱塊法は局所管理をもっとも素直に実現した計画で、「乱塊」の「塊」がブロックを、「乱」がブロックの中での無作為化を指す。
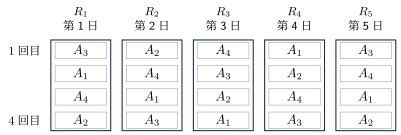
例として、触媒 A A A A 1 , … , A 4 A_1,\dots,A_4 A 1 , … , A 4
20回の順番を完全に無作為に決める(完全無作為化法の1元配置)と、日と水準の組合せが偏る。たとえばある日に A 1 A_1 A 1 A 4 A_4 A 4
乱塊法では、各日(ブロック)に4種類を1回ずつ割り当て、日の中での順番だけを無作為に決める(図 11.1 )。すると、どの水準も各日に1回ずつ現れるので、日のずれはすべての水準に同じだけ加わり、水準どうしを比べる段階で打ち消し合う。
図 11.1 乱塊法の割り付けの例。5つのブロック(日)のそれぞれで4水準を1回ずつ行い、日の中の実施順だけを乱数で決める。ブロックの中の順番は日ごとに独立に並べ替える。
ブロックの中で順番を無作為にする理由は、ブロックの中にも時間とともに変わる要因(装置の温まり方、作業者の疲れ)があるからである。毎日 A 1 → A 2 → A 3 → A 4 A_1\to A_2\to A_3\to A_4 A 1 → A 2 → A 3 → A 4 A 1 A_1 A 1 A 1 A_1 A 1 A 4 A_4 A 4
ブロックは「比べたい要因」ではない
因子 A A A 制御因子 (母数因子)と呼ぶ。ブロック因子 R R R 変量因子 として扱う。変量として扱うと、関心の対象は個々のブロックの効果でなく、ブロック間のばらつきの大きさ σ R 2 \sigma_R^2 σ R 2
データの構造式
因子 A A A a a a r r r R j R_j R j A i A_i A i
x i j ( i = 1 , … , a , j = 1 , … , r ) . x_{ij}\qquad(i=1,\dots,a,\quad j=1,\dots,r). x ij ( i = 1 , … , a , j = 1 , … , r ) .
総データ数は N = a r N=ar N = a r
定義 11.1(乱塊法のデータの構造式)
x i j = μ + a i + γ j + ε i j , ∑ i = 1 a a i = 0 , γ j ∼ N ( 0 , σ R 2 ) , ε i j ∼ N ( 0 , σ 2 ) (11.1) x_{ij}=\mu+a_i+\gamma_j+\varepsilon_{ij},\qquad \sum_{i=1}^a a_i=0,\qquad
\gamma_j\sim\mathrm{N}(0,\sigma_R^2),\qquad \varepsilon_{ij}\sim\mathrm{N}(0,\sigma^2)\tag{11.1} x ij = μ + a i + γ j + ε ij , i = 1 ∑ a a i = 0 , γ j ∼ N ( 0 , σ R 2 ) , ε ij ∼ N ( 0 , σ 2 ) ( 11.1 )
とし、γ 1 , … , γ r , ε 11 , … , ε a r \gamma_1,\dots,\gamma_r,\ \varepsilon_{11},\dots,\varepsilon_{ar} γ 1 , … , γ r , ε 11 , … , ε a r
μ \mu μ a i a_i a i γ j \gamma_j γ j ε i j \varepsilon_{ij} ε ij
σ R 2 \sigma_R^2 σ R 2 ブロック因子の分散成分 と呼ぶ。また、母数因子の大きさを表す量としてσ A 2 = ∑ i a i 2 / ( a − 1 ) \sigma_A^2=\sum_{i}a_i^2/(a-1) σ A 2 = ∑ i a i 2 / ( a − 1 )
ブロックの効果を r j r_j r j r r r
構造式には A × R A\times R A × R
繰返しのない2元配置(第6章)と同じく、各セルのデータが1個しか無いので、交互作用を入れると誤差と区別できなくなる。そのため仮定として置くしかない。実際に交互作用があれば、それは誤差に含まれて推定される。
構造式 (11.1) からデータの共分散の構造が決まる。同じブロックの異なる水準のデータ x i j x_{ij} x ij x i ′ j x_{i'j} x i ′ j
V [ x i j ] = σ R 2 + σ 2 , C o v ( x i j , x i ′ j ) = V [ γ j ] = σ R 2 , C o v ( x i j , x i ′ j ′ ) = 0 ( j ≠ j ′ ) (11.2) V[x_{ij}]=\sigma_R^2+\sigma^2,\qquad
\mathrm{Cov}(x_{ij},x_{i'j})=V[\gamma_j]=\sigma_R^2,\qquad
\mathrm{Cov}(x_{ij},x_{i'j'})=0\quad(j\neq j')\tag{11.2} V [ x ij ] = σ R 2 + σ 2 , Cov ( x ij , x i ′ j ) = V [ γ j ] = σ R 2 , Cov ( x ij , x i ′ j ′ ) = 0 ( j = j ′ ) ( 11.2 )
となる。同じブロックの中のデータは正の相関を持つ。この相関
σ R 2 σ R 2 + σ 2 \frac{\sigma_R^2}{\sigma_R^2+\sigma^2} σ R 2 + σ 2 σ R 2
をブロック内相関 (級内相関)と呼ぶ。乱塊法の解析では、この正の相関を、同じブロックの中で差を取ることによって打ち消す。
平方和の分解と分散分析表
記号を次のように置く。
水準 A i の合計と平均 : T i ⋅ = ∑ j x i j , x ˉ i ⋅ = T i ⋅ / r , ブロック R j の合計と平均 : T ⋅ j = ∑ i x i j , x ˉ ⋅ j = T ⋅ j / a , 総合計・総平均・修正項 : T = ∑ i , j x i j , x ˉ = T / N , C T = T 2 / N . \begin{aligned}&\text{水準 }{A_i}\text{ の合計と平均}: && T_{i\cdot}=\sum_j x_{ij},\quad \bar x_{i\cdot}=T_{i\cdot}/r,\\
&\text{ブロック }{R_j}\text{ の合計と平均}: && T_{\cdot j}=\sum_i x_{ij},\quad \bar x_{\cdot j}=T_{\cdot j}/a,\\
&\text{総合計・総平均・修正項}: && T=\sum_{i,j}x_{ij},\quad \bar x=T/N,\quad CT=T^2/N .\end{aligned} 水準 A i の合計と平均 : ブロック R j の合計と平均 : 総合計・総平均・修正項 : T i ⋅ = j ∑ x ij , x ˉ i ⋅ = T i ⋅ / r , T ⋅ j = i ∑ x ij , x ˉ ⋅ j = T ⋅ j / a , T = i , j ∑ x ij , x ˉ = T / N , C T = T 2 / N .
各データの総平均からの偏差を
x i j − x ˉ = ( x ˉ i ⋅ − x ˉ ) + ( x ˉ ⋅ j − x ˉ ) + ( x i j − x ˉ i ⋅ − x ˉ ⋅ j + x ˉ ) (11.3) x_{ij}-\bar x=(\bar x_{i\cdot}-\bar x)+(\bar x_{\cdot j}-\bar x)+(x_{ij}-\bar x_{i\cdot}-\bar x_{\cdot j}+\bar x)\tag{11.3} x ij − x ˉ = ( x ˉ i ⋅ − x ˉ ) + ( x ˉ ⋅ j − x ˉ ) + ( x ij − x ˉ i ⋅ − x ˉ ⋅ j + x ˉ ) ( 11.3 )
と3つに分ける。右辺の3つの項は、( i , j ) (i,j) ( i , j )
∑ i ( x ˉ i ⋅ − x ˉ ) ∑ j ( x i j − x ˉ i ⋅ − x ˉ ⋅ j + x ˉ ) . \sum_i(\bar x_{i\cdot}-\bar x)\sum_j(x_{ij}-\bar x_{i\cdot}-\bar x_{\cdot j}+\bar x). i ∑ ( x ˉ i ⋅ − x ˉ ) j ∑ ( x ij − x ˉ i ⋅ − x ˉ ⋅ j + x ˉ ) .
内側の和は、∑ j x ˉ ⋅ j = r x ˉ \sum_j\bar x_{\cdot j}=r\bar x ∑ j x ˉ ⋅ j = r x ˉ
T i ⋅ − r x ˉ i ⋅ − ∑ j x ˉ ⋅ j + r x ˉ = 0 − r x ˉ + r x ˉ = 0. T_{i\cdot}-r\bar x_{i\cdot}-\sum_j\bar x_{\cdot j}+r\bar x=0-r\bar x+r\bar x=0 . T i ⋅ − r x ˉ i ⋅ − j ∑ x ˉ ⋅ j + r x ˉ = 0 − r x ˉ + r x ˉ = 0.
第2項と第3項 :添字 i i i j j j 第1項と第2項 :∑ i ( x ˉ i ⋅ − x ˉ ) = 0 \sum_i(\bar x_{i\cdot}-\bar x)=0 ∑ i ( x ˉ i ⋅ − x ˉ ) = 0
したがって両辺を2乗して和を取ると
S T = S A + S R + S e , (11.4) S_T=S_A+S_R+S_e,\tag{11.4} S T = S A + S R + S e , ( 11.4 )
S T = ∑ i , j ( x i j − x ˉ ) 2 = ∑ i , j x i j 2 − C T , S A = r ∑ i ( x ˉ i ⋅ − x ˉ ) 2 = ∑ i T i ⋅ 2 r − C T , S R = a ∑ j ( x ˉ ⋅ j − x ˉ ) 2 = ∑ j T ⋅ j 2 a − C T , S e = ∑ i , j ( x i j − x ˉ i ⋅ − x ˉ ⋅ j + x ˉ ) 2 = S T − S A − S R \begin{align*}S_T&=\sum_{i,j}(x_{ij}-\bar x)^2=\sum_{i,j}x_{ij}^2-CT, &
S_A&=r\sum_i(\bar x_{i\cdot}-\bar x)^2=\sum_i\frac{T_{i\cdot}^2}{r}-CT,\\S_R&=a\sum_j(\bar x_{\cdot j}-\bar x)^2=\sum_j\frac{T_{\cdot j}^2}{a}-CT, &
S_e&=\sum_{i,j}(x_{ij}-\bar x_{i\cdot}-\bar x_{\cdot j}+\bar x)^2=S_T-S_A-S_R\tag{11.5}\end{align*} S T S R = i , j ∑ ( x ij − x ˉ ) 2 = i , j ∑ x ij 2 − C T , = a j ∑ ( x ˉ ⋅ j − x ˉ ) 2 = j ∑ a T ⋅ j 2 − C T , S A S e = r i ∑ ( x ˉ i ⋅ − x ˉ ) 2 = i ∑ r T i ⋅ 2 − C T , = i , j ∑ ( x ij − x ˉ i ⋅ − x ˉ ⋅ j + x ˉ ) 2 = S T − S A − S R ( 11.5 )
を得る。自由度は次のとおりで、ϕ T = ϕ A + ϕ R + ϕ e \phi_T=\phi_A+\phi_R+\phi_e ϕ T = ϕ A + ϕ R + ϕ e
ϕ T = N − 1 , ϕ A = a − 1 , ϕ R = r − 1 , ϕ e = ( a − 1 ) ( r − 1 ) . \phi_T=N-1,\qquad \phi_A=a-1,\qquad \phi_R=r-1,\qquad \phi_e=(a-1)(r-1). ϕ T = N − 1 , ϕ A = a − 1 , ϕ R = r − 1 , ϕ e = ( a − 1 ) ( r − 1 ) .
平方和と自由度の計算は、繰返しのない2元配置で B B B R R R
期待平均平方と分散分析表
定理 11.2(乱塊法の期待平均平方と平方和の分布 ★★★)
構造式 (11.1) のもとで
E ( V A ) = σ 2 + r σ A 2 , E ( V R ) = σ 2 + a σ R 2 , E ( V e ) = σ 2 (11.6) E(V_A)=\sigma^2+r\sigma_A^2,\qquad E(V_R)=\sigma^2+a\sigma_R^2,\qquad E(V_e)=\sigma^2\tag{11.6} E ( V A ) = σ 2 + r σ A 2 , E ( V R ) = σ 2 + a σ R 2 , E ( V e ) = σ 2 ( 11.6 )
が成り立つ。さらに S A , S R , S e S_A,S_R,S_e S A , S R , S e
S e σ 2 ∼ χ ϕ e 2 , S R σ 2 + a σ R 2 ∼ χ ϕ R 2 , H 0 : a 1 = ⋯ = a a = 0 のもとで S A σ 2 ∼ χ ϕ A 2 \frac{S_e}{\sigma^2}\sim\chi^2_{\phi_e},\qquad \frac{S_R}{\sigma^2+a\sigma_R^2}\sim\chi^2_{\phi_R},\qquad
H_0\colon a_1=\dots=a_a=0 \text{ のもとで } \frac{S_A}{\sigma^2}\sim\chi^2_{\phi_A} σ 2 S e ∼ χ ϕ e 2 , σ 2 + a σ R 2 S R ∼ χ ϕ R 2 , H 0 : a 1 = ⋯ = a a = 0 のもとで σ 2 S A ∼ χ ϕ A 2
である。
証明 構造式を各平均に代入する。誤差とブロック効果の平均を次のように書く。
γ ˉ = 1 r ∑ j γ j , ε ˉ i ⋅ = 1 r ∑ j ε i j , ε ˉ ⋅ j = 1 a ∑ i ε i j , ε ˉ = 1 N ∑ i , j ε i j . \bar\gamma=\frac1r\sum_j\gamma_j,\quad \bar\varepsilon_{i\cdot}=\frac1r\sum_j\varepsilon_{ij},\quad
\bar\varepsilon_{\cdot j}=\frac1a\sum_i\varepsilon_{ij},\quad \bar\varepsilon=\frac1N\sum_{i,j}\varepsilon_{ij}. γ ˉ = r 1 j ∑ γ j , ε ˉ i ⋅ = r 1 j ∑ ε ij , ε ˉ ⋅ j = a 1 i ∑ ε ij , ε ˉ = N 1 i , j ∑ ε ij .
∑ i a i = 0 \sum_i a_i=0 ∑ i a i = 0
x ˉ i ⋅ = μ + a i + γ ˉ + ε ˉ i ⋅ , x ˉ ⋅ j = μ + γ j + ε ˉ ⋅ j , x ˉ = μ + γ ˉ + ε ˉ . \bar x_{i\cdot}=\mu+a_i+\bar\gamma+\bar\varepsilon_{i\cdot},\qquad
\bar x_{\cdot j}=\mu+\gamma_j+\bar\varepsilon_{\cdot j},\qquad
\bar x=\mu+\bar\gamma+\bar\varepsilon . x ˉ i ⋅ = μ + a i + γ ˉ + ε ˉ i ⋅ , x ˉ ⋅ j = μ + γ j + ε ˉ ⋅ j , x ˉ = μ + γ ˉ + ε ˉ .
したがって
x ˉ i ⋅ − x ˉ = a i + ( ε ˉ i ⋅ − ε ˉ ) , x ˉ ⋅ j − x ˉ = ( γ j − γ ˉ ) + ( ε ˉ ⋅ j − ε ˉ ) , x i j − x ˉ i ⋅ − x ˉ ⋅ j + x ˉ = ε i j − ε ˉ i ⋅ − ε ˉ ⋅ j + ε ˉ . \begin{aligned}\bar x_{i\cdot}-\bar x&=a_i+(\bar\varepsilon_{i\cdot}-\bar\varepsilon),\\
\bar x_{\cdot j}-\bar x&=(\gamma_j-\bar\gamma)+(\bar\varepsilon_{\cdot j}-\bar\varepsilon),\\
x_{ij}-\bar x_{i\cdot}-\bar x_{\cdot j}+\bar x&=\varepsilon_{ij}-\bar\varepsilon_{i\cdot}-\bar\varepsilon_{\cdot j}+\bar\varepsilon .\end{aligned} x ˉ i ⋅ − x ˉ x ˉ ⋅ j − x ˉ x ij − x ˉ i ⋅ − x ˉ ⋅ j + x ˉ = a i + ( ε ˉ i ⋅ − ε ˉ ) , = ( γ j − γ ˉ ) + ( ε ˉ ⋅ j − ε ˉ ) , = ε ij − ε ˉ i ⋅ − ε ˉ ⋅ j + ε ˉ .
1行目にブロックの効果が残っていないことに注意する。水準の平均 x ˉ i ⋅ \bar x_{i\cdot} x ˉ i ⋅ γ ˉ \bar\gamma γ ˉ x ˉ ⋅ j \bar x_{\cdot j} x ˉ ⋅ j
S A S_A S A ε ˉ 1 ⋅ , … , ε ˉ a ⋅ \bar\varepsilon_{1\cdot},\dots,\bar\varepsilon_{a\cdot} ε ˉ 1 ⋅ , … , ε ˉ a ⋅ N ( 0 , σ 2 / r ) \mathrm{N}(0,\sigma^2/r) N ( 0 , σ 2 / r ) ε ˉ \bar\varepsilon ε ˉ
E [ ∑ i ( ε ˉ i ⋅ − ε ˉ ) 2 ] = ( a − 1 ) σ 2 r . E\Bigl[\sum_i(\bar\varepsilon_{i\cdot}-\bar\varepsilon)^2\Bigr]=\frac{(a-1)\sigma^2}{r}. E [ i ∑ ( ε ˉ i ⋅ − ε ˉ ) 2 ] = r ( a − 1 ) σ 2 .
交差項は期待値 0 なので
E ( S A ) = r ∑ i a i 2 + r ⋅ ( a − 1 ) σ 2 r = ( a − 1 ) ( σ 2 + r σ A 2 ) . E(S_A)=r\sum_i a_i^2+r\cdot\frac{(a-1)\sigma^2}{r}=(a-1)(\sigma^2+r\sigma_A^2). E ( S A ) = r i ∑ a i 2 + r ⋅ r ( a − 1 ) σ 2 = ( a − 1 ) ( σ 2 + r σ A 2 ) .
S R S_R S R u j = γ j + ε ˉ ⋅ j u_j=\gamma_j+\bar\varepsilon_{\cdot j} u j = γ j + ε ˉ ⋅ j
これらは独立に N ( 0 , σ R 2 + σ 2 / a ) \mathrm{N}(0,\sigma_R^2+\sigma^2/a) N ( 0 , σ R 2 + σ 2 / a ) x ˉ ⋅ j − x ˉ = u j − u ˉ \bar x_{\cdot j}-\bar x=u_j-\bar u x ˉ ⋅ j − x ˉ = u j − u ˉ
S R = a ∑ j ( u j − u ˉ ) 2 , E ( S R ) = a ( r − 1 ) ( σ R 2 + σ 2 a ) = ( r − 1 ) ( σ 2 + a σ R 2 ) . (11.7) S_R=a\sum_j(u_j-\bar u)^2,\qquad E(S_R)=a(r-1)\Bigl(\sigma_R^2+\frac{\sigma^2}{a}\Bigr)=(r-1)(\sigma^2+a\sigma_R^2).\tag{11.7} S R = a j ∑ ( u j − u ˉ ) 2 , E ( S R ) = a ( r − 1 ) ( σ R 2 + a σ 2 ) = ( r − 1 ) ( σ 2 + a σ R 2 ) . ( 11.7 )
S e S_e S e e i j = ε i j − ε ˉ i ⋅ − ε ˉ ⋅ j + ε ˉ e_{ij}=\varepsilon_{ij}-\bar\varepsilon_{i\cdot}-\bar\varepsilon_{\cdot j}+\bar\varepsilon e ij = ε ij − ε ˉ i ⋅ − ε ˉ ⋅ j + ε ˉ ∑ k , l c k l ε k l \sum_{k,l}c_{kl}\varepsilon_{kl} ∑ k , l c k l ε k l
c k l = δ i k δ j l − δ i k r − δ j l a + 1 N = ( δ i k − 1 a ) ( δ j l − 1 r ) . c_{kl}=\delta_{ik}\delta_{jl}-\frac{\delta_{ik}}{r}-\frac{\delta_{jl}}{a}+\frac1N=\Bigl(\delta_{ik}-\frac1a\Bigr)\Bigl(\delta_{jl}-\frac1r\Bigr). c k l = δ ik δ j l − r δ ik − a δ j l + N 1 = ( δ ik − a 1 ) ( δ j l − r 1 ) .
∑ k ( δ i k − 1 / a ) 2 = 1 − 1 / a \sum_k(\delta_{ik}-1/a)^2=1-1/a ∑ k ( δ ik − 1/ a ) 2 = 1 − 1/ a
∑ k , l c k l 2 = ( 1 − 1 r ) ( 1 − 1 a ) \sum_{k,l}c_{kl}^2=\Bigl(1-\frac1r\Bigr)\Bigl(1-\frac1a\Bigr) k , l ∑ c k l 2 = ( 1 − r 1 ) ( 1 − a 1 )
となる。よって E ( e i j 2 ) = σ 2 ( 1 − 1 / a ) ( 1 − 1 / r ) E(e_{ij}^2)=\sigma^2(1-1/a)(1-1/r) E ( e ij 2 ) = σ 2 ( 1 − 1/ a ) ( 1 − 1/ r ) N N N
E ( S e ) = a r σ 2 ( a − 1 ) ( r − 1 ) a r = ( a − 1 ) ( r − 1 ) σ 2 . E(S_e)=\frac{ar\sigma^2(a-1)(r-1)}{ar}=(a-1)(r-1)\sigma^2 . E ( S e ) = a r a r σ 2 ( a − 1 ) ( r − 1 ) = ( a − 1 ) ( r − 1 ) σ 2 .
各平方和を自由度で割れば (11.6) を得る。
分布と独立性 。誤差ベクトル ε = ( ε i j ) ∈ R N \bm{\varepsilon}=(\varepsilon_{ij})\in\mathbb{R}^N ε = ( ε ij ) ∈ R N
総平均の方向(1次元)。
「i i i a − 1 a-1 a − 1
「j j j r − 1 r-1 r − 1
残り(( a − 1 ) ( r − 1 ) (a-1)(r-1) ( a − 1 ) ( r − 1 )
誤差ベクトルを2番目・3番目・4番目の部分空間へ直交射影すると、その成分はそれぞれ次のようになる。
ε ˉ i ⋅ − ε ˉ , ε ˉ ⋅ j − ε ˉ , e i j . \bar\varepsilon_{i\cdot}-\bar\varepsilon,\qquad \bar\varepsilon_{\cdot j}-\bar\varepsilon,\qquad e_{ij}. ε ˉ i ⋅ − ε ˉ , ε ˉ ⋅ j − ε ˉ , e ij .
Cochran の定理によれば、ε ∼ N ( 0 , σ 2 I N ) \bm{\varepsilon}\sim\mathrm{N}(\bm 0,\sigma^2 I_N) ε ∼ N ( 0 , σ 2 I N ) σ 2 \sigma^2 σ 2
S e S_e S e S e / σ 2 ∼ χ ( a − 1 ) ( r − 1 ) 2 S_e/\sigma^2\sim\chi^2_{(a-1)(r-1)} S e / σ 2 ∼ χ ( a − 1 ) ( r − 1 ) 2 帰無仮説のもとで S A S_A S A S A / σ 2 ∼ χ a − 1 2 S_A/\sigma^2\sim\chi^2_{a-1} S A / σ 2 ∼ χ a − 1 2
S R S_R S R γ \bm\gamma γ
最後に、(11.7) で u j u_j u j
∑ j ( u j − u ˉ ) 2 σ R 2 + σ 2 / a ∼ χ r − 1 2 , すなわち S R σ 2 + a σ R 2 ∼ χ r − 1 2 \frac{\sum_j(u_j-\bar u)^2}{\sigma_R^2+\sigma^2/a}\sim\chi^2_{r-1},\qquad\text{すなわち}\qquad \frac{S_R}{\sigma^2+a\sigma_R^2}\sim\chi^2_{r-1} σ R 2 + σ 2 / a ∑ j ( u j − u ˉ ) 2 ∼ χ r − 1 2 , すなわち σ 2 + a σ R 2 S R ∼ χ r − 1 2
である。
定理 11.2 から、分散分析表は表 11.1 の形になる。
表 11.1 乱塊法の分散分析表 要因 平方和 自由度 平均平方 F 0 F_0 F 0 E ( V ) E(V) E ( V ) A A A S A S_A S A a − 1 a-1 a − 1 V A = S A / ϕ A V_A=S_A/\phi_A V A = S A / ϕ A V A / V e V_A/V_e V A / V e σ 2 + r σ A 2 \sigma^2+r\sigma_A^2 σ 2 + r σ A 2 R R R S R S_R S R r − 1 r-1 r − 1 V R = S R / ϕ R V_R=S_R/\phi_R V R = S R / ϕ R V R / V e V_R/V_e V R / V e σ 2 + a σ R 2 \sigma^2+a\sigma_R^2 σ 2 + a σ R 2 e e e S e S_e S e ( a − 1 ) ( r − 1 ) (a-1)(r-1) ( a − 1 ) ( r − 1 ) V e = S e / ϕ e V_e=S_e/\phi_e V e = S e / ϕ e σ 2 \sigma^2 σ 2 計 S T S_T S T a r − 1 ar-1 a r − 1
因子の検定 H 0 : σ A 2 = 0 H_0\colon\sigma_A^2=0 H 0 : σ A 2 = 0 F 0 = V A / V e F_0=V_A/V_e F 0 = V A / V e F 0 ≥ F ϕ A , ϕ e ( α ) F_0\ge F_{\phi_A,\phi_e}(\alpha) F 0 ≥ F ϕ A , ϕ e ( α ) F ϕ A , ϕ e F_{\phi_A,\phi_e} F ϕ A , ϕ e
期待値の差 E ( V A ) − E ( V e ) E(V_A)-E(V_e) E ( V A ) − E ( V e ) r σ A 2 r\sigma_A^2 r σ A 2
分子と分母は独立なカイ二乗変数をそれぞれの自由度で割ったものである。
ブロックの検定 H 0 : σ R 2 = 0 H_0\colon\sigma_R^2=0 H 0 : σ R 2 = 0 F 0 = V R / V e F_0=V_R/V_e F 0 = V R / V e
分散分析後の推定
因子 A A A A i A_i A i 変量のブロックを考えるとき、水準 A i A_i A i μ ( A i ) = μ + a i \mu(A_i)=\mu+a_i μ ( A i ) = μ + a i その点推定量は
μ ^ ( A i ) = x ˉ i ⋅ = μ + a i + γ ˉ + ε ˉ i ⋅ \hat\mu(A_i)=\bar x_{i\cdot}=\mu+a_i+\bar\gamma+\bar\varepsilon_{i\cdot} μ ^ ( A i ) = x ˉ i ⋅ = μ + a i + γ ˉ + ε ˉ i ⋅
で、実験に使った r r r γ ˉ \bar\gamma γ ˉ
V [ x ˉ i ⋅ ] = σ R 2 r + σ 2 r = σ R 2 + σ 2 r . (11.8) V[\bar x_{i\cdot}]=\frac{\sigma_R^2}{r}+\frac{\sigma^2}{r}=\frac{\sigma_R^2+\sigma^2}{r}.\tag{11.8} V [ x ˉ i ⋅ ] = r σ R 2 + r σ 2 = r σ R 2 + σ 2 . ( 11.8 )
一方、2水準の差ではブロック効果の平均が消える。
x ˉ i ⋅ − x ˉ i ′ ⋅ = a i − a i ′ + ε ˉ i ⋅ − ε ˉ i ′ ⋅ \bar x_{i\cdot}-\bar x_{i'\cdot}=a_i-a_{i'}+\bar\varepsilon_{i\cdot}-\bar\varepsilon_{i'\cdot} x ˉ i ⋅ − x ˉ i ′ ⋅ = a i − a i ′ + ε ˉ i ⋅ − ε ˉ i ′ ⋅
なので
V [ x ˉ i ⋅ − x ˉ i ′ ⋅ ] = 2 σ 2 r . (11.9) V[\bar x_{i\cdot}-\bar x_{i'\cdot}]=\frac{2\sigma^2}{r}.\tag{11.9} V [ x ˉ i ⋅ − x ˉ i ′ ⋅ ] = r 2 σ 2 . ( 11.9 )
乱塊法の推定の要点
水準間の差の信頼率 1 − α 1-\alpha 1 − α t t t
x ˉ i ⋅ − x ˉ i ′ ⋅ ± t ϕ e ( α / 2 ) 2 V e r . (11.10) \bar x_{i\cdot}-\bar x_{i'\cdot}\ \pm\ t_{\phi_e}(\alpha/2)\sqrt{\frac{2V_e}{r}}.\tag{11.10} x ˉ i ⋅ − x ˉ i ′ ⋅ ± t ϕ e ( α /2 ) r 2 V e . ( 11.10 )
水準の母平均 μ ( A i ) \mu(A_i) μ ( A i ) (11.8) には σ R 2 \sigma_R^2 σ R 2 E ( V R ) = σ 2 + a σ R 2 E(V_R)=\sigma^2+a\sigma_R^2 E ( V R ) = σ 2 + a σ R 2 E ( V e ) = σ 2 E(V_e)=\sigma^2 E ( V e ) = σ 2
σ R 2 + σ 2 ^ = V R − V e a + V e = V R + ( a − 1 ) V e a \widehat{\sigma_R^2+\sigma^2}=\frac{V_R-V_e}{a}+V_e=\frac{V_R+(a-1)V_e}{a} σ R 2 + σ 2 = a V R − V e + V e = a V R + ( a − 1 ) V e
で、
V ^ [ x ˉ i ⋅ ] = V R + ( a − 1 ) V e a r . (11.11) \widehat{V}[\bar x_{i\cdot}]=\frac{V_R+(a-1)V_e}{ar}.\tag{11.11} V [ x ˉ i ⋅ ] = a r V R + ( a − 1 ) V e . ( 11.11 )
これは2つの平均平方の1次結合なので、t t t (11.12) で近似し、x ˉ i ⋅ ± t ϕ ∗ ( α / 2 ) V ^ [ x ˉ i ⋅ ] \bar x_{i\cdot}\pm t_{\phi^*}(\alpha/2)\sqrt{\widehat V[\bar x_{i\cdot}]} x ˉ i ⋅ ± t ϕ ∗ ( α /2 ) V [ x ˉ i ⋅ ]
ブロックを母数因子とみなすこともできる。その場合は「この実験に使った r r r μ + a i + γ ˉ \mu+a_i+\bar\gamma μ + a i + γ ˉ σ 2 / r \sigma^2/r σ 2 / r x ˉ i ⋅ ± t ϕ e ( α / 2 ) V e / r \bar x_{i\cdot}\pm t_{\phi_e}(\alpha/2)\sqrt{V_e/r} x ˉ i ⋅ ± t ϕ e ( α /2 ) V e / r
Satterthwaite の等価自由度。
独立な平均平方 V 1 , … , V k V_1,\dots,V_k V 1 , … , V k ϕ k V k / E ( V k ) ∼ χ ϕ k 2 \phi_kV_k/E(V_k)\sim\chi^2_{\phi_k} ϕ k V k / E ( V k ) ∼ χ ϕ k 2 θ ^ = ∑ k c k V k \hat\theta=\sum_k c_kV_k θ ^ = ∑ k c k V k
ϕ ∗ θ ^ E ( θ ^ ) ≈ χ ϕ ∗ 2 . \frac{\phi^*\hat\theta}{E(\hat\theta)}\ \approx\ \chi^2_{\phi^*}. E ( θ ^ ) ϕ ∗ θ ^ ≈ χ ϕ ∗ 2 .
自由度 ϕ ∗ \phi^* ϕ ∗ V [ V k ] = 2 E ( V k ) 2 / ϕ k V[V_k]=2E(V_k)^2/\phi_k V [ V k ] = 2 E ( V k ) 2 / ϕ k
V [ θ ^ ] = ∑ k c k 2 2 E ( V k ) 2 ϕ k と V [ E ( θ ^ ) ϕ ∗ χ ϕ ∗ 2 ] = 2 E ( θ ^ ) 2 ϕ ∗ V[\hat\theta]=\sum_k c_k^2\frac{2E(V_k)^2}{\phi_k}
\quad\text{と}\quad
V\Bigl[\frac{E(\hat\theta)}{\phi^*}\chi^2_{\phi^*}\Bigr]=\frac{2E(\hat\theta)^2}{\phi^*} V [ θ ^ ] = k ∑ c k 2 ϕ k 2 E ( V k ) 2 と V [ ϕ ∗ E ( θ ^ ) χ ϕ ∗ 2 ] = ϕ ∗ 2 E ( θ ^ ) 2
を等しいとおき、期待値を推定値で置き換えると
ϕ ∗ = ( ∑ k c k V k ) 2 ∑ k ( c k V k ) 2 / ϕ k (11.12) \phi^*=\frac{\bigl(\sum_k c_kV_k\bigr)^2}{\sum_k (c_kV_k)^2/\phi_k}\tag{11.12} ϕ ∗ = ∑ k ( c k V k ) 2 / ϕ k ( ∑ k c k V k ) 2 ( 11.12 )
を得る。これを Satterthwaite の等価自由度 と呼ぶ。数表を引くときは最も近い整数に丸める。
(11.11) では c 1 V 1 = V R / ( a r ) c_1V_1=V_R/(ar) c 1 V 1 = V R / ( a r ) c 2 V 2 = ( a − 1 ) V e / ( a r ) c_2V_2=(a-1)V_e/(ar) c 2 V 2 = ( a − 1 ) V e / ( a r ) 1 / ( a r ) 1/(ar) 1/ ( a r )
ϕ ∗ = { V R + ( a − 1 ) V e } 2 V R 2 / ϕ R + ( a − 1 ) 2 V e 2 / ϕ e \phi^*=\frac{\{V_R+(a-1)V_e\}^2}{V_R^2/\phi_R+(a-1)^2V_e^2/\phi_e} ϕ ∗ = V R 2 / ϕ R + ( a − 1 ) 2 V e 2 / ϕ e { V R + ( a − 1 ) V e } 2
となる。分割法(第12章)でも同じ近似を使う。
ブロック因子の分散成分の推定
ブロック間のばらつき σ R 2 \sigma_R^2 σ R 2 E ( V R ) − E ( V e ) = a σ R 2 E(V_R)-E(V_e)=a\sigma_R^2 E ( V R ) − E ( V e ) = a σ R 2
σ ^ R 2 = V R − V e a (11.13) \hat\sigma_R^2=\frac{V_R-V_e}{a}\tag{11.13} σ ^ R 2 = a V R − V e ( 11.13 )
である。V R < V e V_R<V_e V R < V e
近似区間(Satterthwaite)。
点推定量は2つの平均平方の差なので、係数に負のもの(− V e / a -V_e/a − V e / a ϕ ∗ σ ^ R 2 / σ R 2 \phi^*\hat\sigma_R^2/\sigma_R^2 ϕ ∗ σ ^ R 2 / σ R 2 χ ϕ ∗ 2 \chi^2_{\phi^*} χ ϕ ∗ 2
ϕ ∗ = ( V R − V e ) 2 V R 2 / ϕ R + V e 2 / ϕ e , ϕ ∗ σ ^ R 2 χ ϕ ∗ 2 ( α / 2 ) ≤ σ R 2 ≤ ϕ ∗ σ ^ R 2 χ ϕ ∗ 2 ( 1 − α / 2 ) (11.14) \phi^*=\frac{(V_R-V_e)^2}{V_R^2/\phi_R+V_e^2/\phi_e},\qquad
\frac{\phi^*\hat\sigma_R^2}{\chi^2_{\phi^*}(\alpha/2)}\le\sigma_R^2\le\frac{\phi^*\hat\sigma_R^2}{\chi^2_{\phi^*}(1-\alpha/2)}\tag{11.14} ϕ ∗ = V R 2 / ϕ R + V e 2 / ϕ e ( V R − V e ) 2 , χ ϕ ∗ 2 ( α /2 ) ϕ ∗ σ ^ R 2 ≤ σ R 2 ≤ χ ϕ ∗ 2 ( 1 − α /2 ) ϕ ∗ σ ^ R 2 ( 11.14 )
を信頼率 1 − α 1-\alpha 1 − α 1 / a 2 1/a^2 1/ a 2
負の係数を含む1次結合では近似の精度が落ち、V R V_R V R V e V_e V e ϕ ∗ ≈ ϕ R \phi^*\approx\phi_R ϕ ∗ ≈ ϕ R σ ^ R 2 ≈ V R / a \hat\sigma_R^2\approx V_R/a σ ^ R 2 ≈ V R / a
分散比の正確な区間。
比 θ = σ R 2 / σ 2 \theta=\sigma_R^2/\sigma^2 θ = σ R 2 / σ 2 11.2 から、次の2つは独立なカイ二乗変数である。
S R σ 2 + a σ R 2 , S e σ 2 . \frac{S_R}{\sigma^2+a\sigma_R^2},\qquad \frac{S_e}{\sigma^2}. σ 2 + a σ R 2 S R , σ 2 S e .
よって
V R / ( σ 2 + a σ R 2 ) V e / σ 2 = V R / V e 1 + a θ ∼ F ϕ R , ϕ e . (11.15) \frac{V_R/(\sigma^2+a\sigma_R^2)}{V_e/\sigma^2}=\frac{V_R/V_e}{1+a\theta}\sim F_{\phi_R,\phi_e}.\tag{11.15} V e / σ 2 V R / ( σ 2 + a σ R 2 ) = 1 + a θ V R / V e ∼ F ϕ R , ϕ e . ( 11.15 )
F 0 = V R / V e F_0=V_R/V_e F 0 = V R / V e θ \theta θ
F ϕ R , ϕ e ( 1 − α / 2 ) ≤ F 0 1 + a θ ≤ F ϕ R , ϕ e ( α / 2 ) . F_{\phi_R,\phi_e}(1-\alpha/2)\le \frac{F_0}{1+a\theta}\le F_{\phi_R,\phi_e}(\alpha/2). F ϕ R , ϕ e ( 1 − α /2 ) ≤ 1 + a θ F 0 ≤ F ϕ R , ϕ e ( α /2 ) .
すると
1 a ( F 0 F ϕ R , ϕ e ( α / 2 ) − 1 ) ≤ θ ≤ 1 a ( F 0 F ϕ R , ϕ e ( 1 − α / 2 ) − 1 ) . (11.16) \frac{1}{a}\Bigl(\frac{F_0}{F_{\phi_R,\phi_e}(\alpha/2)}-1\Bigr)\le\theta\le\frac{1}{a}\Bigl(\frac{F_0}{F_{\phi_R,\phi_e}(1-\alpha/2)}-1\Bigr).\tag{11.16} a 1 ( F ϕ R , ϕ e ( α /2 ) F 0 − 1 ) ≤ θ ≤ a 1 ( F ϕ R , ϕ e ( 1 − α /2 ) F 0 − 1 ) . ( 11.16 )
下限が負になったら 0 に置き換える。下側の点は F m , n ( 1 − α / 2 ) = 1 / F n , m ( α / 2 ) F_{m,n}(1-\alpha/2)=1/F_{n,m}(\alpha/2) F m , n ( 1 − α /2 ) = 1/ F n , m ( α /2 )
ブロック内相関は σ R 2 / ( σ R 2 + σ 2 ) = θ / ( 1 + θ ) \sigma_R^2/(\sigma_R^2+\sigma^2)=\theta/(1+\theta) σ R 2 / ( σ R 2 + σ 2 ) = θ / ( 1 + θ ) θ \theta θ (11.16) の両端を変換すれば正確な区間になる。
例題 11.1 2水準の乱塊法と対応のある t t t
オリジナル 乱塊法で a = 2 a=2 a = 2 d j = x 1 j − x 2 j d_j=x_{1j}-x_{2j} d j = x 1 j − x 2 j j = 1 , … , r j=1,\dots,r j = 1 , … , r d ˉ \bar d d ˉ s d 2 s_d^2 s d 2
2つの平方和 S A S_A S A S e S_e S e
分散分析の F 0 = V A / V e F_0=V_A/V_e F 0 = V A / V e t t t t 0 = d ˉ / s d 2 / r t_0=\bar d/\sqrt{s_d^2/r} t 0 = d ˉ / s d 2 / r
差 d j d_j d j (11.1) から求めよ。また、ブロック内相関が大きいほど対応のある比較が有利になる理由を述べよ。
解答
水準の平均と総平均の差は次のとおりである。
x ˉ 1 ⋅ − x ˉ = x ˉ 1 ⋅ − x ˉ 2 ⋅ 2 = d ˉ 2 , x ˉ 2 ⋅ − x ˉ = − d ˉ 2 . \bar x_{1\cdot}-\bar x=\frac{\bar x_{1\cdot}-\bar x_{2\cdot}}{2}=\frac{\bar d}{2},\qquad \bar x_{2\cdot}-\bar x=-\frac{\bar d}{2}. x ˉ 1 ⋅ − x ˉ = 2 x ˉ 1 ⋅ − x ˉ 2 ⋅ = 2 d ˉ , x ˉ 2 ⋅ − x ˉ = − 2 d ˉ .
よって S A = r { ( d ˉ / 2 ) 2 + ( d ˉ / 2 ) 2 } = r d ˉ 2 / 2 S_A=r\{(\bar d/2)^2+(\bar d/2)^2\}=r\bar d^2/2 S A = r {( d ˉ /2 ) 2 + ( d ˉ /2 ) 2 } = r d ˉ 2 /2
残差は e 1 j = x 1 j − x ˉ 1 ⋅ − x ˉ ⋅ j + x ˉ e_{1j}=x_{1j}-\bar x_{1\cdot}-\bar x_{\cdot j}+\bar x e 1 j = x 1 j − x ˉ 1 ⋅ − x ˉ ⋅ j + x ˉ x ˉ ⋅ j = ( x 1 j + x 2 j ) / 2 \bar x_{\cdot j}=(x_{1j}+x_{2j})/2 x ˉ ⋅ j = ( x 1 j + x 2 j ) /2
x 1 j − x ˉ ⋅ j = d j 2 , x ˉ 1 ⋅ − x ˉ = d ˉ 2 x_{1j}-\bar x_{\cdot j}=\frac{d_j}{2},\qquad \bar x_{1\cdot}-\bar x=\frac{\bar d}{2} x 1 j − x ˉ ⋅ j = 2 d j , x ˉ 1 ⋅ − x ˉ = 2 d ˉ
なので e 1 j = ( d j − d ˉ ) / 2 e_{1j}=(d_j-\bar d)/2 e 1 j = ( d j − d ˉ ) /2 e 2 j = − ( d j − d ˉ ) / 2 e_{2j}=-(d_j-\bar d)/2 e 2 j = − ( d j − d ˉ ) /2
S e = ∑ j { ( d j − d ˉ ) 2 4 + ( d j − d ˉ ) 2 4 } = 1 2 ∑ j ( d j − d ˉ ) 2 = ( r − 1 ) s d 2 2 . S_e=\sum_j\Bigl\{\frac{(d_j-\bar d)^2}{4}+\frac{(d_j-\bar d)^2}{4}\Bigr\}=\frac12\sum_j(d_j-\bar d)^2=\frac{(r-1)s_d^2}{2}. S e = j ∑ { 4 ( d j − d ˉ ) 2 + 4 ( d j − d ˉ ) 2 } = 2 1 j ∑ ( d j − d ˉ ) 2 = 2 ( r − 1 ) s d 2 . ϕ A = 1 \phi_A=1 ϕ A = 1 ϕ e = ( 2 − 1 ) ( r − 1 ) = r − 1 \phi_e=(2-1)(r-1)=r-1 ϕ e = ( 2 − 1 ) ( r − 1 ) = r − 1
V A = r d ˉ 2 / 2 , V e = s d 2 / 2. V_A=r\bar d^2/2,\qquad V_e=s_d^2/2. V A = r d ˉ 2 /2 , V e = s d 2 /2.
したがって
F 0 = r d ˉ 2 / 2 s d 2 / 2 = r d ˉ 2 s d 2 = ( d ˉ s d 2 / r ) 2 = t 0 2 . F_0=\frac{r\bar d^2/2}{s_d^2/2}=\frac{r\bar d^2}{s_d^2}=\Bigl(\frac{\bar d}{\sqrt{s_d^2/r}}\Bigr)^2=t_0^2 . F 0 = s d 2 /2 r d ˉ 2 /2 = s d 2 r d ˉ 2 = ( s d 2 / r d ˉ ) 2 = t 0 2 .
F F F F 1 , r − 1 ( α ) = t r − 1 ( α / 2 ) 2 F_{1,r-1}(\alpha)=t_{r-1}(\alpha/2)^2 F 1 , r − 1 ( α ) = t r − 1 ( α /2 ) 2 t t t F F F d j = ( a 1 − a 2 ) + ( ε 1 j − ε 2 j ) d_j=(a_1-a_2)+(\varepsilon_{1j}-\varepsilon_{2j}) d j = ( a 1 − a 2 ) + ( ε 1 j − ε 2 j ) V [ d j ] = 2 σ 2 V[d_j]=2\sigma^2 V [ d j ] = 2 σ 2 σ R 2 + σ 2 \sigma_R^2+\sigma^2 σ R 2 + σ 2 2 ( σ R 2 + σ 2 ) / r 2(\sigma_R^2+\sigma^2)/r 2 ( σ R 2 + σ 2 ) / r 2 σ 2 / r 2\sigma^2/r 2 σ 2 / r σ R 2 / ( σ R 2 + σ 2 ) \sigma_R^2/(\sigma_R^2+\sigma^2) σ R 2 / ( σ R 2 + σ 2 )
ブロックを無視して解析したらどうなるか
ブロックの列を区別せず、同じデータを1元配置(各水準の繰返し r r r
誤差平方和は S R + S e S_R+S_e S R + S e ϕ R + ϕ e = a ( r − 1 ) \phi_R+\phi_e=a(r-1) ϕ R + ϕ e = a ( r − 1 )
定理 11.2 の期待値を足すと
E ( S R + S e ) = ( r − 1 ) ( σ 2 + a σ R 2 ) + ( a − 1 ) ( r − 1 ) σ 2 = a ( r − 1 ) ( σ 2 + σ R 2 ) . E(S_R+S_e)=(r-1)(\sigma^2+a\sigma_R^2)+(a-1)(r-1)\sigma^2=a(r-1)(\sigma^2+\sigma_R^2). E ( S R + S e ) = ( r − 1 ) ( σ 2 + a σ R 2 ) + ( a − 1 ) ( r − 1 ) σ 2 = a ( r − 1 ) ( σ 2 + σ R 2 ) .
よってこの誤差分散 V e ′ = ( S R + S e ) / { a ( r − 1 ) } V_e'=(S_R+S_e)/\{a(r-1)\} V e ′ = ( S R + S e ) / { a ( r − 1 )} σ 2 + σ R 2 \sigma^2+\sigma_R^2 σ 2 + σ R 2 E ( V A ) = σ 2 + r σ A 2 E(V_A)=\sigma^2+r\sigma_A^2 E ( V A ) = σ 2 + r σ A 2 σ R 2 \sigma_R^2 σ R 2 F 0 F_0 F 0
ブロックとして実験したデータは、必ずブロックの行を立てて解析する。
確認テスト
オリジナル
11.1-1 Fisher の3原則を挙げ、乱塊法でブロックを作ることとブロックの中で順番を乱数で決めることが、それぞれどの原則に当たるかを答えよ。11.1-2 構造式 (11.1) のもとで、E ( S R ) = ( r − 1 ) ( σ 2 + a σ R 2 ) E(S_R)=(r-1)(\sigma^2+a\sigma_R^2) E ( S R ) = ( r − 1 ) ( σ 2 + a σ R 2 ) 11.1-3 構造式 (11.1) のもとで、x ˉ 1 ⋅ \bar x_{1\cdot} x ˉ 1 ⋅ x ˉ 2 ⋅ \bar x_{2\cdot} x ˉ 2 ⋅
V [ x ˉ 1 ⋅ − x ˉ 2 ⋅ ] = 2 σ 2 / r . V[\bar x_{1\cdot}-\bar x_{2\cdot}]=2\sigma^2/r. V [ x ˉ 1 ⋅ − x ˉ 2 ⋅ ] = 2 σ 2 / r . 11.1-4 3水準・6ブロックの乱塊法で V R = 20 V_R=20 V R = 20 V e = 2 V_e=2 V e = 2 θ = σ R 2 / σ 2 \theta=\sigma_R^2/\sigma^2 θ = σ R 2 / σ 2 F 5 , 10 ( 0.025 ) = 4.236 F_{5,10}(0.025)=4.236 F 5 , 10 ( 0.025 ) = 4.236 F 10 , 5 ( 0.025 ) = 6.619 F_{10,5}(0.025)=6.619 F 10 , 5 ( 0.025 ) = 6.619 11.1-5 ブロックを無視して1元配置で解析したときの誤差分散 V e ′ = ( S R + S e ) / { a ( r − 1 ) } V_e'=(S_R+S_e)/\{a(r-1)\} V e ′ = ( S R + S e ) / { a ( r − 1 )} E ( V e ′ ) = σ 2 + σ R 2 E(V_e')=\sigma^2+\sigma_R^2 E ( V e ′ ) = σ 2 + σ R 2 F 0 ′ = V A / V e ′ F_0'=V_A/V_e' F 0 ′ = V A / V e ′ F a − 1 , a ( r − 1 ) F_{a-1,a(r-1)} F a − 1 , a ( r − 1 )
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com