実験計画法 第14章 §14.1 ★★ 構造式に1次誤差と2次誤差を入れ、期待平均平方・検定の分母・推定の分散・測定回数の最適化を導く
工業の実験では、1回の実験で試験片を1個作り、その硬さを2回測る、というように、同じ実験単位に対して測定を何回か繰り返すことが多い。実験 r r r m m m
この違いを無視して全データを「繰返し」として1元配置の解析にかけると、誤差分散を小さく見積もる。その結果、本当は差の無い要因を有意と判定する誤りが起きる。
この章では次の道具を作る。
構造式 :実験の誤差(1次誤差 )と測定の誤差(2次誤差 )を別々の項として持つデータの構造式。検定の規則 :平方和の3分解と期待平均平方。そこから「要因 A A A 推定 :要因の水準の母平均の推定とその分散 σ ( 1 ) 2 / r + σ ( 2 ) 2 / ( r m ) \sigma_{(1)}^2/r+\sigma_{(2)}^2/(rm) σ ( 1 ) 2 / r + σ ( 2 ) 2 / ( r m ) 測定回数の最適化 :測定を繰り返す利点を数式で示し、実験1回と測定1回の費用から測定回数の最適値を決める式。
期待平均平方が2段の誤差を持つ形は、第12章の分割法(1次誤差と2次誤差)と同じ構造をしており、この章はその最も簡単な場合に当たる。
統計応用(理工学)の大問では、「構造式を書く → 平方和と自由度を3つに分ける → 期待平均平方から検定の分母を選ぶ →母平均を区間推定する → 分散成分を推定し測定回数の妥当性を論じる」という連鎖で、この章の道具が使われうる。
実験の繰返しと測定の繰返し
第1章で述べた Fisher の3原則の「反復」は、実験の繰返し を指す。実験の繰返しとは、ある水準 A i A_i A i 実験の誤差 と呼ぶ。
一方、測定の繰返し とは、1回の実験でできた試料(試験片・製品・溶液)を、同じ測定器で何回か測ることである。測定の繰返しで新しく入るのは測定器の読みのばらつきだけで、実験の誤差は入らない。
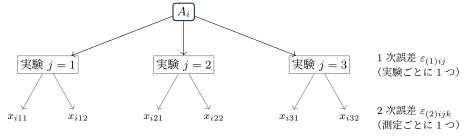
図 14.1 は、水準ごとに r r r m m m
図 14.1 測定を繰り返す実験のデータの階層(r = 3 , m = 2 r=3,\ m=2 r = 3 , m = 2 ε ( 1 ) i j \varepsilon_{(1)ij} ε ( 1 ) ij
データの構造式
記号を次のように決める。
因子 A A A a a a
各水準での実験の繰返し数を r r r m m m
測定値は x i j k x_{ijk} x ij k i = 1 , … , a , j = 1 , … , r , k = 1 , … , m i=1,\dots,a,\ j=1,\dots,r,\ k=1,\dots,m i = 1 , … , a , j = 1 , … , r , k = 1 , … , m
総データ数を N = a r m N=arm N = a r m a r ar a r
定義 14.1(測定を繰り返す1元配置のデータの構造式)
x i j k = μ + a i + ε ( 1 ) i j + ε ( 2 ) i j k , ∑ i = 1 a a i = 0 , ε ( 1 ) i j ∼ N ( 0 , σ ( 1 ) 2 ) , ε ( 2 ) i j k ∼ N ( 0 , σ ( 2 ) 2 ) (14.1) x_{ijk}=\mu+a_i+\varepsilon_{(1)ij}+\varepsilon_{(2)ijk},\qquad \sum_{i=1}^a a_i=0,\qquad
\varepsilon_{(1)ij}\sim\mathrm{N}(0,\sigma_{(1)}^2),\qquad \varepsilon_{(2)ijk}\sim\mathrm{N}(0,\sigma_{(2)}^2)\tag{14.1} x ij k = μ + a i + ε ( 1 ) ij + ε ( 2 ) ij k , i = 1 ∑ a a i = 0 , ε ( 1 ) ij ∼ N ( 0 , σ ( 1 ) 2 ) , ε ( 2 ) ij k ∼ N ( 0 , σ ( 2 ) 2 ) ( 14.1 )
とし、すべての誤差は互いに独立とする。
ε ( 1 ) i j \varepsilon_{(1)ij} ε ( 1 ) ij 1次誤差 (実験の誤差)と呼び、その分散 σ ( 1 ) 2 \sigma_{(1)}^2 σ ( 1 ) 2 ε ( 2 ) i j k \varepsilon_{(2)ijk} ε ( 2 ) ij k 2次誤差 (測定の誤差)と呼び、その分散 σ ( 2 ) 2 \sigma_{(2)}^2 σ ( 2 ) 2
母数因子の大きさを σ A 2 = ∑ i a i 2 / ( a − 1 ) \sigma_A^2=\sum_i a_i^2/(a-1) σ A 2 = ∑ i a i 2 / ( a − 1 )
構造式から、データの分散と共分散は次のように決まる。
V [ x i j k ] = σ ( 1 ) 2 + σ ( 2 ) 2 , C o v ( x i j k , x i j k ′ ) = σ ( 1 ) 2 ( k ≠ k ′ ) , C o v ( x i j k , x i j ′ k ′ ) = 0 ( j ≠ j ′ ) . (14.2) V[x_{ijk}]=\sigma_{(1)}^2+\sigma_{(2)}^2,\qquad
\mathrm{Cov}(x_{ijk},x_{ijk'})=\sigma_{(1)}^2\quad(k\neq k'),\qquad
\mathrm{Cov}(x_{ijk},x_{ij'k'})=0\quad(j\neq j').\tag{14.2} V [ x ij k ] = σ ( 1 ) 2 + σ ( 2 ) 2 , Cov ( x ij k , x ij k ′ ) = σ ( 1 ) 2 ( k = k ′ ) , Cov ( x ij k , x i j ′ k ′ ) = 0 ( j = j ′ ) . ( 14.2 )
同じ実験の2つの測定値は正の相関 σ ( 1 ) 2 / ( σ ( 1 ) 2 + σ ( 2 ) 2 ) \sigma_{(1)}^2/(\sigma_{(1)}^2+\sigma_{(2)}^2) σ ( 1 ) 2 / ( σ ( 1 ) 2 + σ ( 2 ) 2 )
平方和の分解
和と平均の記号を次のように置く。
実験ごと : T i j ⋅ = ∑ k x i j k , x ˉ i j ⋅ = T i j ⋅ / m , 水準ごと : T i ⋅ ⋅ = ∑ j , k x i j k , x ˉ i ⋅ ⋅ = T i ⋅ ⋅ / ( r m ) , 全体 : T = ∑ i , j , k x i j k , x ˉ = T / N , C T = T 2 / N (修正項) . \begin{aligned}\text{実験ごと}&:\ T_{ij\cdot}=\sum_k x_{ijk},\quad \bar x_{ij\cdot}=T_{ij\cdot}/m,\\
\text{水準ごと}&:\ T_{i\cdot\cdot}=\sum_{j,k}x_{ijk},\quad \bar x_{i\cdot\cdot}=T_{i\cdot\cdot}/(rm),\\
\text{全体}&:\ T=\sum_{i,j,k}x_{ijk},\quad \bar x=T/N,\quad CT=T^2/N\ \text{(修正項)}.\end{aligned} 実験ごと 水準ごと 全体 : T ij ⋅ = k ∑ x ij k , x ˉ ij ⋅ = T ij ⋅ / m , : T i ⋅⋅ = j , k ∑ x ij k , x ˉ i ⋅⋅ = T i ⋅⋅ / ( r m ) , : T = i , j , k ∑ x ij k , x ˉ = T / N , C T = T 2 / N (修正項) .
各データの総平均からの偏差を
x i j k − x ˉ = ( x ˉ i ⋅ ⋅ − x ˉ ) + ( x ˉ i j ⋅ − x ˉ i ⋅ ⋅ ) + ( x i j k − x ˉ i j ⋅ ) (14.3) x_{ijk}-\bar x=(\bar x_{i\cdot\cdot}-\bar x)+(\bar x_{ij\cdot}-\bar x_{i\cdot\cdot})+(x_{ijk}-\bar x_{ij\cdot})\tag{14.3} x ij k − x ˉ = ( x ˉ i ⋅⋅ − x ˉ ) + ( x ˉ ij ⋅ − x ˉ i ⋅⋅ ) + ( x ij k − x ˉ ij ⋅ ) ( 14.3 )
と3つに分ける。右辺の3項は、和を取ると互いの積の和が 0 になる。理由は次のとおりである。
第3項は、k k k ∑ k ( x i j k − x ˉ i j ⋅ ) = 0 \sum_k(x_{ijk}-\bar x_{ij\cdot})=0 ∑ k ( x ij k − x ˉ ij ⋅ ) = 0 k k k
第2項は、j j j ∑ j ( x ˉ i j ⋅ − x ˉ i ⋅ ⋅ ) = 0 \sum_j(\bar x_{ij\cdot}-\bar x_{i\cdot\cdot})=0 ∑ j ( x ˉ ij ⋅ − x ˉ i ⋅⋅ ) = 0 j j j
したがって両辺を2乗して和を取ると
S T = S A + S e ( 1 ) + S e ( 2 ) (14.4) S_T=S_A+S_{e(1)}+S_{e(2)}\tag{14.4} S T = S A + S e ( 1 ) + S e ( 2 ) ( 14.4 )
を得る。各平方和の定義と計算式は
S T = ∑ i , j , k ( x i j k − x ˉ ) 2 = ∑ i , j , k x i j k 2 − C T , S A = r m ∑ i ( x ˉ i ⋅ ⋅ − x ˉ ) 2 = ∑ i T i ⋅ ⋅ 2 r m − C T , S e ( 1 ) = m ∑ i , j ( x ˉ i j ⋅ − x ˉ i ⋅ ⋅ ) 2 = S A R − S A , S e ( 2 ) = ∑ i , j , k ( x i j k − x ˉ i j ⋅ ) 2 = S T − S A R \begin{align*}S_T&=\sum_{i,j,k}(x_{ijk}-\bar x)^2=\sum_{i,j,k}x_{ijk}^2-CT, &
S_A&=rm\sum_i(\bar x_{i\cdot\cdot}-\bar x)^2=\sum_i\frac{T_{i\cdot\cdot}^2}{rm}-CT,\\S_{e(1)}&=m\sum_{i,j}(\bar x_{ij\cdot}-\bar x_{i\cdot\cdot})^2=S_{AR}-S_A, &
S_{e(2)}&=\sum_{i,j,k}(x_{ijk}-\bar x_{ij\cdot})^2=S_T-S_{AR}\tag{14.5}\end{align*} S T S e ( 1 ) = i , j , k ∑ ( x ij k − x ˉ ) 2 = i , j , k ∑ x ij k 2 − C T , = m i , j ∑ ( x ˉ ij ⋅ − x ˉ i ⋅⋅ ) 2 = S A R − S A , S A S e ( 2 ) = r m i ∑ ( x ˉ i ⋅⋅ − x ˉ ) 2 = i ∑ r m T i ⋅⋅ 2 − C T , = i , j , k ∑ ( x ij k − x ˉ ij ⋅ ) 2 = S T − S A R ( 14.5 )
である。ここで S A R = ∑ i , j T i j ⋅ 2 / m − C T S_{AR}=\sum_{i,j}T_{ij\cdot}^2/m-CT S A R = ∑ i , j T ij ⋅ 2 / m − C T S A S_A S A S e ( 1 ) S_{e(1)} S e ( 1 )
ϕ T = a r m − 1 , ϕ A = a − 1 , ϕ e ( 1 ) = a ( r − 1 ) , ϕ e ( 2 ) = a r ( m − 1 ) (14.6) \phi_T=arm-1,\qquad \phi_A=a-1,\qquad \phi_{e(1)}=a(r-1),\qquad \phi_{e(2)}=ar(m-1)\tag{14.6} ϕ T = a r m − 1 , ϕ A = a − 1 , ϕ e ( 1 ) = a ( r − 1 ) , ϕ e ( 2 ) = a r ( m − 1 ) ( 14.6 )
で、ϕ T = ϕ A + ϕ e ( 1 ) + ϕ e ( 2 ) \phi_T=\phi_A+\phi_{e(1)}+\phi_{e(2)} ϕ T = ϕ A + ϕ e ( 1 ) + ϕ e ( 2 )
ϕ e ( 1 ) \phi_{e(1)} ϕ e ( 1 ) r − 1 r-1 r − 1 ϕ e ( 2 ) \phi_{e(2)} ϕ e ( 2 ) m − 1 m-1 m − 1
期待平均平方と平方和の分布
定理 14.2(測定を繰り返す1元配置の期待平均平方 ★★)
構造式 (14.1) のもとで、平均平方 V A = S A / ϕ A , V e ( 1 ) = S e ( 1 ) / ϕ e ( 1 ) , V e ( 2 ) = S e ( 2 ) / ϕ e ( 2 ) V_A=S_A/\phi_A,\ V_{e(1)}=S_{e(1)}/\phi_{e(1)},\ V_{e(2)}=S_{e(2)}/\phi_{e(2)} V A = S A / ϕ A , V e ( 1 ) = S e ( 1 ) / ϕ e ( 1 ) , V e ( 2 ) = S e ( 2 ) / ϕ e ( 2 )
E ( V A ) = σ ( 2 ) 2 + m σ ( 1 ) 2 + r m σ A 2 , E ( V e ( 1 ) ) = σ ( 2 ) 2 + m σ ( 1 ) 2 , E ( V e ( 2 ) ) = σ ( 2 ) 2 (14.7) E(V_A)=\sigma_{(2)}^2+m\sigma_{(1)}^2+rm\sigma_A^2,\qquad
E(V_{e(1)})=\sigma_{(2)}^2+m\sigma_{(1)}^2,\qquad
E(V_{e(2)})=\sigma_{(2)}^2\tag{14.7} E ( V A ) = σ ( 2 ) 2 + m σ ( 1 ) 2 + r m σ A 2 , E ( V e ( 1 ) ) = σ ( 2 ) 2 + m σ ( 1 ) 2 , E ( V e ( 2 ) ) = σ ( 2 ) 2 ( 14.7 )
を満たす。さらに3つの平方和 S A , S e ( 1 ) , S e ( 2 ) S_A,S_{e(1)},S_{e(2)} S A , S e ( 1 ) , S e ( 2 )
S e ( 2 ) σ ( 2 ) 2 ∼ χ ϕ e ( 2 ) 2 , S e ( 1 ) σ ( 2 ) 2 + m σ ( 1 ) 2 ∼ χ ϕ e ( 1 ) 2 , \frac{S_{e(2)}}{\sigma_{(2)}^2}\sim\chi^2_{\phi_{e(2)}},\qquad
\frac{S_{e(1)}}{\sigma_{(2)}^2+m\sigma_{(1)}^2}\sim\chi^2_{\phi_{e(1)}}, σ ( 2 ) 2 S e ( 2 ) ∼ χ ϕ e ( 2 ) 2 , σ ( 2 ) 2 + m σ ( 1 ) 2 S e ( 1 ) ∼ χ ϕ e ( 1 ) 2 ,
H 0 : a 1 = ⋯ = a a = 0 のもとで S A σ ( 2 ) 2 + m σ ( 1 ) 2 ∼ χ ϕ A 2 H_0\colon a_1=\dots=a_a=0 \text{ のもとで } \frac{S_A}{\sigma_{(2)}^2+m\sigma_{(1)}^2}\sim\chi^2_{\phi_A} H 0 : a 1 = ⋯ = a a = 0 のもとで σ ( 2 ) 2 + m σ ( 1 ) 2 S A ∼ χ ϕ A 2
が成り立つ。
証明 実験ごとの2次誤差の平均を ε ˉ ( 2 ) i j ⋅ = 1 m ∑ k ε ( 2 ) i j k \bar\varepsilon_{(2)ij\cdot}=\frac1m\sum_k\varepsilon_{(2)ijk} ε ˉ ( 2 ) ij ⋅ = m 1 ∑ k ε ( 2 ) ij k
u i j = ε ( 1 ) i j + ε ˉ ( 2 ) i j ⋅ u_{ij}=\varepsilon_{(1)ij}+\bar\varepsilon_{(2)ij\cdot} u ij = ε ( 1 ) ij + ε ˉ ( 2 ) ij ⋅
と置く。u i j u_{ij} u ij
u i j ∼ N ( 0 , σ ( 1 ) 2 + σ ( 2 ) 2 / m ) u_{ij}\sim\mathrm{N}\bigl(0,\ \sigma_{(1)}^2+\sigma_{(2)}^2/m\bigr) u ij ∼ N ( 0 , σ ( 1 ) 2 + σ ( 2 ) 2 / m )
u ˉ i = 1 r ∑ j u i j , u ˉ = 1 a ∑ i u ˉ i \bar u_{i}=\frac1r\sum_j u_{ij},\ \bar u=\frac1a\sum_i\bar u_i u ˉ i = r 1 ∑ j u ij , u ˉ = a 1 ∑ i u ˉ i
x ˉ i j ⋅ = μ + a i + u i j , x ˉ i ⋅ ⋅ = μ + a i + u ˉ i , x ˉ = μ + u ˉ \bar x_{ij\cdot}=\mu+a_i+u_{ij},\qquad \bar x_{i\cdot\cdot}=\mu+a_i+\bar u_i,\qquad \bar x=\mu+\bar u x ˉ ij ⋅ = μ + a i + u ij , x ˉ i ⋅⋅ = μ + a i + u ˉ i , x ˉ = μ + u ˉ
となる(∑ i a i = 0 \sum_i a_i=0 ∑ i a i = 0
x ˉ i ⋅ ⋅ − x ˉ = a i + ( u ˉ i − u ˉ ) , x ˉ i j ⋅ − x ˉ i ⋅ ⋅ = u i j − u ˉ i , x i j k − x ˉ i j ⋅ = ε ( 2 ) i j k − ε ˉ ( 2 ) i j ⋅ \begin{aligned}\bar x_{i\cdot\cdot}-\bar x&=a_i+(\bar u_i-\bar u),\\
\bar x_{ij\cdot}-\bar x_{i\cdot\cdot}&=u_{ij}-\bar u_i,\\
x_{ijk}-\bar x_{ij\cdot}&=\varepsilon_{(2)ijk}-\bar\varepsilon_{(2)ij\cdot}\end{aligned} x ˉ i ⋅⋅ − x ˉ x ˉ ij ⋅ − x ˉ i ⋅⋅ x ij k − x ˉ ij ⋅ = a i + ( u ˉ i − u ˉ ) , = u ij − u ˉ i , = ε ( 2 ) ij k − ε ˉ ( 2 ) ij ⋅
と書ける。1次誤差は3行目から完全に消え、1行目と2行目には u i j u_{ij} u ij
S e ( 2 ) S_{e(2)} S e ( 2 ) ε ( 2 ) i j 1 , … , ε ( 2 ) i j m \varepsilon_{(2)ij1},\dots,\varepsilon_{(2)ijm} ε ( 2 ) ij 1 , … , ε ( 2 ) ij m N ( 0 , σ ( 2 ) 2 ) \mathrm{N}(0,\sigma_{(2)}^2) N ( 0 , σ ( 2 ) 2 )
∑ k ( ε ( 2 ) i j k − ε ˉ ( 2 ) i j ⋅ ) 2 σ ( 2 ) 2 ∼ χ m − 1 2 \frac{\sum_k(\varepsilon_{(2)ijk}-\bar\varepsilon_{(2)ij\cdot})^2}{\sigma_{(2)}^2}\sim\chi^2_{m-1} σ ( 2 ) 2 ∑ k ( ε ( 2 ) ij k − ε ˉ ( 2 ) ij ⋅ ) 2 ∼ χ m − 1 2
で、これは2次誤差の平均 ε ˉ ( 2 ) i j ⋅ \bar\varepsilon_{(2)ij\cdot} ε ˉ ( 2 ) ij ⋅
S e ( 2 ) σ ( 2 ) 2 ∼ χ a r ( m − 1 ) 2 , E ( S e ( 2 ) ) = a r ( m − 1 ) σ ( 2 ) 2 \frac{S_{e(2)}}{\sigma_{(2)}^2}\sim\chi^2_{ar(m-1)},\qquad E(S_{e(2)})=ar(m-1)\sigma_{(2)}^2 σ ( 2 ) 2 S e ( 2 ) ∼ χ a r ( m − 1 ) 2 , E ( S e ( 2 ) ) = a r ( m − 1 ) σ ( 2 ) 2
S e ( 1 ) S_{e(1)} S e ( 1 ) τ 2 = σ ( 1 ) 2 + σ ( 2 ) 2 / m \tau^2=\sigma_{(1)}^2+\sigma_{(2)}^2/m τ 2 = σ ( 1 ) 2 + σ ( 2 ) 2 / m u i 1 , … , u i r u_{i1},\dots,u_{ir} u i 1 , … , u i r τ 2 \tau^2 τ 2 ∑ j ( u i j − u ˉ i ) 2 / τ 2 ∼ χ r − 1 2 \sum_j(u_{ij}-\bar u_i)^2/\tau^2\sim\chi^2_{r-1} ∑ j ( u ij − u ˉ i ) 2 / τ 2 ∼ χ r − 1 2 u ˉ i \bar u_i u ˉ i m m m
S e ( 1 ) m τ 2 = S e ( 1 ) σ ( 2 ) 2 + m σ ( 1 ) 2 ∼ χ a ( r − 1 ) 2 , E ( S e ( 1 ) ) = a ( r − 1 ) ( σ ( 2 ) 2 + m σ ( 1 ) 2 ) . \frac{S_{e(1)}}{m\tau^2}=\frac{S_{e(1)}}{\sigma_{(2)}^2+m\sigma_{(1)}^2}\sim\chi^2_{a(r-1)},\qquad E(S_{e(1)})=a(r-1)(\sigma_{(2)}^2+m\sigma_{(1)}^2). m τ 2 S e ( 1 ) = σ ( 2 ) 2 + m σ ( 1 ) 2 S e ( 1 ) ∼ χ a ( r − 1 ) 2 , E ( S e ( 1 ) ) = a ( r − 1 ) ( σ ( 2 ) 2 + m σ ( 1 ) 2 ) .
S A S_A S A u ˉ 1 , … , u ˉ a \bar u_1,\dots,\bar u_a u ˉ 1 , … , u ˉ a N ( 0 , τ 2 / r ) \mathrm{N}(0,\tau^2/r) N ( 0 , τ 2 / r )
E [ ∑ i ( u ˉ i − u ˉ ) 2 ] = ( a − 1 ) τ 2 / r E\Bigl[\sum_i(\bar u_i-\bar u)^2\Bigr]=(a-1)\tau^2/r E [ i ∑ ( u ˉ i − u ˉ ) 2 ] = ( a − 1 ) τ 2 / r
である。交差項 2 ∑ i a i ( u ˉ i − u ˉ ) 2\sum_i a_i(\bar u_i-\bar u) 2 ∑ i a i ( u ˉ i − u ˉ )
E ( S A ) = r m ∑ i a i 2 + r m ⋅ ( a − 1 ) τ 2 r = ( a − 1 ) ( σ ( 2 ) 2 + m σ ( 1 ) 2 + r m σ A 2 ) . E(S_A)=rm\sum_i a_i^2+rm\cdot\frac{(a-1)\tau^2}{r}=(a-1)\bigl(\sigma_{(2)}^2+m\sigma_{(1)}^2+rm\sigma_A^2\bigr). E ( S A ) = r m i ∑ a i 2 + r m ⋅ r ( a − 1 ) τ 2 = ( a − 1 ) ( σ ( 2 ) 2 + m σ ( 1 ) 2 + r m σ A 2 ) .
帰無仮説のもとでは S A = r m ∑ i ( u ˉ i − u ˉ ) 2 S_A=rm\sum_i(\bar u_i-\bar u)^2 S A = r m ∑ i ( u ˉ i − u ˉ ) 2 ∑ i ( u ˉ i − u ˉ ) 2 / ( τ 2 / r ) ∼ χ a − 1 2 \sum_i(\bar u_i-\bar u)^2/(\tau^2/r)\sim\chi^2_{a-1} ∑ i ( u ˉ i − u ˉ ) 2 / ( τ 2 / r ) ∼ χ a − 1 2 S A / ( m τ 2 ) ∼ χ a − 1 2 S_A/(m\tau^2)\sim\chi^2_{a-1} S A / ( m τ 2 ) ∼ χ a − 1 2
独立性。 次の2段で示す。
S e ( 2 ) S_{e(2)} S e ( 2 ) ε ( 2 ) i j k − ε ˉ ( 2 ) i j ⋅ \varepsilon_{(2)ijk}-\bar\varepsilon_{(2)ij\cdot} ε ( 2 ) ij k − ε ˉ ( 2 ) ij ⋅ u i j u_{ij} u ij S e ( 2 ) S_{e(2)} S e ( 2 ) S e ( 1 ) S_{e(1)} S e ( 1 ) u i j − u ˉ i u_{ij}-\bar u_i u ij − u ˉ i S A S_A S A u ˉ i \bar u_i u ˉ i
各平方和の期待値を自由度で割れば (14.7) を得る。
定理 14.2 から、分散分析表は表 14.1 の形になる。
表 14.1 測定を繰り返す1元配置の分散分析表 要因 平方和 自由度 平均平方 F 0 F_0 F 0 E ( V ) E(V) E ( V ) A A A S A S_A S A a − 1 a-1 a − 1 V A V_A V A V A / V e ( 1 ) V_A/V_{e(1)} V A / V e ( 1 ) σ ( 2 ) 2 + m σ ( 1 ) 2 + r m σ A 2 \sigma_{(2)}^2+m\sigma_{(1)}^2+rm\sigma_A^2 σ ( 2 ) 2 + m σ ( 1 ) 2 + r m σ A 2 e ( 1 ) e_{(1)} e ( 1 ) S e ( 1 ) S_{e(1)} S e ( 1 ) a ( r − 1 ) a(r-1) a ( r − 1 ) V e ( 1 ) V_{e(1)} V e ( 1 ) V e ( 1 ) / V e ( 2 ) V_{e(1)}/V_{e(2)} V e ( 1 ) / V e ( 2 ) σ ( 2 ) 2 + m σ ( 1 ) 2 \sigma_{(2)}^2+m\sigma_{(1)}^2 σ ( 2 ) 2 + m σ ( 1 ) 2 e ( 2 ) e_{(2)} e ( 2 ) S e ( 2 ) S_{e(2)} S e ( 2 ) a r ( m − 1 ) ar(m-1) a r ( m − 1 ) V e ( 2 ) V_{e(2)} V e ( 2 ) σ ( 2 ) 2 \sigma_{(2)}^2 σ ( 2 ) 2 計 S T S_T S T a r m − 1 arm-1 a r m − 1
検定の分母の選び方とプーリング
検定の分母は、期待平均平方の表で「検定したい項だけが違う行」を選ぶ。要因の効果の有無 H 0 : σ A 2 = 0 H_0\colon\sigma_A^2=0 H 0 : σ A 2 = 0 E ( V A ) E(V_A) E ( V A ) E ( V e ( 1 ) ) = σ ( 2 ) 2 + m σ ( 1 ) 2 E(V_{e(1)})=\sigma_{(2)}^2+m\sigma_{(1)}^2 E ( V e ( 1 ) ) = σ ( 2 ) 2 + m σ ( 1 ) 2 14.2 から、帰無仮説のもとで
F 0 = V A V e ( 1 ) ∼ F a − 1 , a ( r − 1 ) (14.8) F_0=\frac{V_A}{V_{e(1)}}\sim F_{a-1,\ a(r-1)}\tag{14.8} F 0 = V e ( 1 ) V A ∼ F a − 1 , a ( r − 1 ) ( 14.8 )
なので、F 0 ≥ F a − 1 , a ( r − 1 ) ( α ) F_0\geq F_{a-1,a(r-1)}(\alpha) F 0 ≥ F a − 1 , a ( r − 1 ) ( α ) m σ ( 1 ) 2 m\sigma_{(1)}^2 m σ ( 1 ) 2
同じ表で、1次誤差が実在するか(σ ( 1 ) 2 > 0 \sigma_{(1)}^2>0 σ ( 1 ) 2 > 0 F 0 = V e ( 1 ) / V e ( 2 ) F_0=V_{e(1)}/V_{e(2)} F 0 = V e ( 1 ) / V e ( 2 ) F a ( r − 1 ) , a r ( m − 1 ) F_{a(r-1),ar(m-1)} F a ( r − 1 ) , a r ( m − 1 ) e ( 1 ) , e ( 2 ) e_{(1)},\ e_{(2)} e ( 1 ) , e ( 2 )
S e ′ = S e ( 1 ) + S e ( 2 ) , ϕ e ′ = ϕ e ( 1 ) + ϕ e ( 2 ) = a ( r m − 1 ) , V e ′ = S e ′ / ϕ e ′ (14.9) S_{e'}=S_{e(1)}+S_{e(2)},\qquad \phi_{e'}=\phi_{e(1)}+\phi_{e(2)}=a(rm-1),\qquad V_{e'}=S_{e'}/\phi_{e'}\tag{14.9} S e ′ = S e ( 1 ) + S e ( 2 ) , ϕ e ′ = ϕ e ( 1 ) + ϕ e ( 2 ) = a ( r m − 1 ) , V e ′ = S e ′ / ϕ e ′ ( 14.9 )
で、要因は V A / V e ′ V_A/V_{e'} V A / V e ′ F a − 1 , a ( r m − 1 ) F_{a-1,a(rm-1)} F a − 1 , a ( r m − 1 ) σ ( 1 ) 2 ≈ 0 \sigma_{(1)}^2\approx0 σ ( 1 ) 2 ≈ 0
分散分析後の推定
水準 A i A_i A i μ ( A i ) = μ + a i \mu(A_i)=\mu+a_i μ ( A i ) = μ + a i x ˉ i ⋅ ⋅ = μ + a i + u ˉ i \bar x_{i\cdot\cdot}=\mu+a_i+\bar u_i x ˉ i ⋅⋅ = μ + a i + u ˉ i
V [ x ˉ i ⋅ ⋅ ] = τ 2 r = σ ( 1 ) 2 r + σ ( 2 ) 2 r m = σ ( 2 ) 2 + m σ ( 1 ) 2 r m (14.10) V[\bar x_{i\cdot\cdot}]=\frac{\tau^2}{r}=\frac{\sigma_{(1)}^2}{r}+\frac{\sigma_{(2)}^2}{rm}=\frac{\sigma_{(2)}^2+m\sigma_{(1)}^2}{rm}\tag{14.10} V [ x ˉ i ⋅⋅ ] = r τ 2 = r σ ( 1 ) 2 + r m σ ( 2 ) 2 = r m σ ( 2 ) 2 + m σ ( 1 ) 2 ( 14.10 )
となる。最後の形の分子はちょうど E ( V e ( 1 ) ) E(V_{e(1)}) E ( V e ( 1 ) ) V e ( 1 ) / ( r m ) V_{e(1)}/(rm) V e ( 1 ) / ( r m ) ( σ ( 2 ) 2 + m σ ( 1 ) 2 ) χ ϕ e ( 1 ) 2 / ϕ e ( 1 ) (\sigma_{(2)}^2+m\sigma_{(1)}^2)\chi^2_{\phi_{e(1)}}/\phi_{e(1)} ( σ ( 2 ) 2 + m σ ( 1 ) 2 ) χ ϕ e ( 1 ) 2 / ϕ e ( 1 )
x ˉ i ⋅ ⋅ − μ ( A i ) V e ( 1 ) / ( r m ) ∼ t ϕ e ( 1 ) \frac{\bar x_{i\cdot\cdot}-\mu(A_i)}{\sqrt{V_{e(1)}/(rm)}}\sim t_{\phi_{e(1)}} V e ( 1 ) / ( r m ) x ˉ i ⋅⋅ − μ ( A i ) ∼ t ϕ e ( 1 )
信頼率 1 − α 1-\alpha 1 − α
x ˉ i ⋅ ⋅ ± t ϕ e ( 1 ) ( α / 2 ) V e ( 1 ) r m , ( x ˉ i ⋅ ⋅ − x ˉ i ′ ⋅ ⋅ ) ± t ϕ e ( 1 ) ( α / 2 ) 2 V e ( 1 ) r m (14.11) \bar x_{i\cdot\cdot}\pm t_{\phi_{e(1)}}(\alpha/2)\sqrt{\frac{V_{e(1)}}{rm}},\qquad
(\bar x_{i\cdot\cdot}-\bar x_{i'\cdot\cdot})\pm t_{\phi_{e(1)}}(\alpha/2)\sqrt{\frac{2V_{e(1)}}{rm}}\tag{14.11} x ˉ i ⋅⋅ ± t ϕ e ( 1 ) ( α /2 ) r m V e ( 1 ) , ( x ˉ i ⋅⋅ − x ˉ i ′ ⋅⋅ ) ± t ϕ e ( 1 ) ( α /2 ) r m 2 V e ( 1 ) ( 14.11 )
である(右は2水準の母平均の差の区間)。第11章の乱塊法では、水準の母平均の分散に入るブロックの分散成分を V e V_e V e σ ( 2 ) 2 + m σ ( 1 ) 2 \sigma_{(2)}^2+m\sigma_{(1)}^2 σ ( 2 ) 2 + m σ ( 1 ) 2 t t t
分散成分の点推定は、期待平均平方の式 (14.7) を下から解いて
σ ^ ( 2 ) 2 = V e ( 2 ) , σ ^ ( 1 ) 2 = V e ( 1 ) − V e ( 2 ) m (14.12) \hat\sigma_{(2)}^2=V_{e(2)},\qquad \hat\sigma_{(1)}^2=\frac{V_{e(1)}-V_{e(2)}}{m}\tag{14.12} σ ^ ( 2 ) 2 = V e ( 2 ) , σ ^ ( 1 ) 2 = m V e ( 1 ) − V e ( 2 ) ( 14.12 )
とする。どちらも不偏推定量である。V e ( 1 ) < V e ( 2 ) V_{e(1)}<V_{e(2)} V e ( 1 ) < V e ( 2 ) σ ( 1 ) 2 = 0 \sigma_{(1)}^2=0 σ ( 1 ) 2 = 0
実験ごとの平均で解析しても A A A
各実験の測定値を平均して x ˉ i j ⋅ \bar x_{ij\cdot} x ˉ ij ⋅
水準間平方和は S A / m S_A/m S A / m S e ( 1 ) / m S_{e(1)}/m S e ( 1 ) / m
自由度は a − 1 a-1 a − 1 a ( r − 1 ) a(r-1) a ( r − 1 )
分子も分母も同じ割合で縮むので、分散比は V A / V e ( 1 ) V_A/V_{e(1)} V A / V e ( 1 ) (14.11) も同じ値になる。平均で解析したときと比べて、測定の繰返しを入れた解析で新たに得られるのは、S e ( 2 ) S_{e(2)} S e ( 2 ) σ ( 2 ) 2 \sigma_{(2)}^2 σ ( 2 ) 2
測定を繰り返す利点と測定回数の決め方
測定を繰り返す利点は2つある。
平均の精度が上がる。 水準の平均の分散 (14.10) のうち、測定誤差の部分 σ ( 2 ) 2 / ( r m ) \sigma_{(2)}^2/(rm) σ ( 2 ) 2 / ( r m ) 2つの分散成分を分けて推定できる。 ばらつきの大部分が測定器に由来するのか、実験の手順に由来するのかが分かる。それが分かれば、改善の手を測定器と工程のどちらに向けるかを決めることができる。
一方で、測定回数をいくら大きくしても V [ x ˉ i ⋅ ⋅ ] ≥ σ ( 1 ) 2 / r V[\bar x_{i\cdot\cdot}]\geq\sigma_{(1)}^2/r V [ x ˉ i ⋅⋅ ] ≥ σ ( 1 ) 2 / r c 1 c_1 c 1 c 2 c_2 c 2
命題 14.3(測定回数の最適値 ★★)
水準1つあたりの費用を C = r ( c 1 + m c 2 ) C=r(c_1+mc_2) C = r ( c 1 + m c 2 ) r r r V [ x ˉ i ⋅ ⋅ ] V[\bar x_{i\cdot\cdot}] V [ x ˉ i ⋅⋅ ] m m m
m ∗ = c 1 σ ( 2 ) 2 c 2 σ ( 1 ) 2 (14.13) m^*=\sqrt{\frac{c_1\,\sigma_{(2)}^2}{c_2\,\sigma_{(1)}^2}}\tag{14.13} m ∗ = c 2 σ ( 1 ) 2 c 1 σ ( 2 ) 2 ( 14.13 )
で、そのときの最小値は V min = ( σ ( 1 ) c 1 + σ ( 2 ) c 2 ) 2 / C V_{\min}=\bigl(\sigma_{(1)}\sqrt{c_1}+\sigma_{(2)}\sqrt{c_2}\bigr)^2/C V m i n = ( σ ( 1 ) c 1 + σ ( 2 ) c 2 ) 2 / C
証明 r = C / ( c 1 + m c 2 ) r=C/(c_1+mc_2) r = C / ( c 1 + m c 2 ) (14.10) に代入すると
C ⋅ V [ x ˉ i ⋅ ⋅ ] = ( σ ( 1 ) 2 + σ ( 2 ) 2 m ) ( c 1 + m c 2 ) = σ ( 1 ) 2 c 1 + σ ( 2 ) 2 c 2 + σ ( 1 ) 2 c 2 m + σ ( 2 ) 2 c 1 m . C\cdot V[\bar x_{i\cdot\cdot}]=\Bigl(\sigma_{(1)}^2+\frac{\sigma_{(2)}^2}{m}\Bigr)(c_1+mc_2)
=\sigma_{(1)}^2c_1+\sigma_{(2)}^2c_2+\sigma_{(1)}^2c_2\,m+\frac{\sigma_{(2)}^2c_1}{m}. C ⋅ V [ x ˉ i ⋅⋅ ] = ( σ ( 1 ) 2 + m σ ( 2 ) 2 ) ( c 1 + m c 2 ) = σ ( 1 ) 2 c 1 + σ ( 2 ) 2 c 2 + σ ( 1 ) 2 c 2 m + m σ ( 2 ) 2 c 1 .
これを g ( m ) g(m) g ( m )
g ′ ( m ) = σ ( 1 ) 2 c 2 − σ ( 2 ) 2 c 1 m 2 , g ′ ′ ( m ) = 2 σ ( 2 ) 2 c 1 m 3 > 0 g'(m)=\sigma_{(1)}^2c_2-\frac{\sigma_{(2)}^2c_1}{m^2},\qquad g''(m)=\frac{2\sigma_{(2)}^2c_1}{m^3}>0 g ′ ( m ) = σ ( 1 ) 2 c 2 − m 2 σ ( 2 ) 2 c 1 , g ′′ ( m ) = m 3 2 σ ( 2 ) 2 c 1 > 0
よって g ′ ( m ) = 0 g'(m)=0 g ′ ( m ) = 0 m ∗ = c 1 σ ( 2 ) 2 / ( c 2 σ ( 1 ) 2 ) m^*=\sqrt{c_1\sigma_{(2)}^2/(c_2\sigma_{(1)}^2)} m ∗ = c 1 σ ( 2 ) 2 / ( c 2 σ ( 1 ) 2 )
σ ( 1 ) 2 c 2 m ∗ = σ ( 2 ) 2 c 1 m ∗ = σ ( 1 ) σ ( 2 ) c 1 c 2 \sigma_{(1)}^2c_2m^*=\frac{\sigma_{(2)}^2c_1}{m^*}=\sigma_{(1)}\sigma_{(2)}\sqrt{c_1c_2} σ ( 1 ) 2 c 2 m ∗ = m ∗ σ ( 2 ) 2 c 1 = σ ( 1 ) σ ( 2 ) c 1 c 2
したがって
g ( m ∗ ) = σ ( 1 ) 2 c 1 + σ ( 2 ) 2 c 2 + 2 σ ( 1 ) σ ( 2 ) c 1 c 2 = ( σ ( 1 ) c 1 + σ ( 2 ) c 2 ) 2 . □ g(m^*)=\sigma_{(1)}^2c_1+\sigma_{(2)}^2c_2+2\sigma_{(1)}\sigma_{(2)}\sqrt{c_1c_2}=\bigl(\sigma_{(1)}\sqrt{c_1}+\sigma_{(2)}\sqrt{c_2}\bigr)^2 .\quad\square g ( m ∗ ) = σ ( 1 ) 2 c 1 + σ ( 2 ) 2 c 2 + 2 σ ( 1 ) σ ( 2 ) c 1 c 2 = ( σ ( 1 ) c 1 + σ ( 2 ) c 2 ) 2 . □
式 (14.13) は直観に合っている。実験が高い(c 1 c_1 c 1 σ ( 2 ) 2 \sigma_{(2)}^2 σ ( 2 ) 2 σ ( 2 ) 2 ≪ σ ( 1 ) 2 \sigma_{(2)}^2\ll\sigma_{(1)}^2 σ ( 2 ) 2 ≪ σ ( 1 ) 2 m ∗ < 1 m^*<1 m ∗ < 1
実際の測定回数は整数なので、m ∗ m^* m ∗ g g g ϕ e ( 1 ) = a ( r − 1 ) ≥ 1 \phi_{e(1)}=a(r-1)\geq1 ϕ e ( 1 ) = a ( r − 1 ) ≥ 1
測定の繰返しを実験の繰返しとして扱う誤り
全測定値を独立な繰返しとみなして普通の1元配置で解析すると、誤差平方和は S e ( 1 ) + S e ( 2 ) S_{e(1)}+S_{e(2)} S e ( 1 ) + S e ( 2 ) a ( r m − 1 ) a(rm-1) a ( r m − 1 ) V e ′ V_e' V e ′ 14.1 で導くとおり次になる。
E ( V e ′ ) = σ ( 2 ) 2 + m ( r − 1 ) r m − 1 σ ( 1 ) 2 < E ( V e ( 1 ) ) = σ ( 2 ) 2 + m σ ( 1 ) 2 E(V_e')=\sigma_{(2)}^2+\frac{m(r-1)}{rm-1}\sigma_{(1)}^2\ <\ E(V_{e(1)})=\sigma_{(2)}^2+m\sigma_{(1)}^2 E ( V e ′ ) = σ ( 2 ) 2 + r m − 1 m ( r − 1 ) σ ( 1 ) 2 < E ( V e ( 1 ) ) = σ ( 2 ) 2 + m σ ( 1 ) 2
分母が小さく見積もられるうえ自由度も水増しされるので、要因に差が無くても有意と判定する確率が名目の α \alpha α
とくに極端なのは r = 1 r=1 r = 1 ϕ e ( 1 ) = 0 \phi_{e(1)}=0 ϕ e ( 1 ) = 0 V A / V e ( 2 ) V_A/V_{e(2)} V A / V e ( 2 )
例題 14.1 測定の繰返しを実験の繰返しと誤認したときの誤差分散 ★★
オリジナル 構造式 (14.1) のデータを、全測定値を繰返しとする1元配置とみなして解析した。そのときの誤差分散を V e ′ = ( S e ( 1 ) + S e ( 2 ) ) / { a ( r m − 1 ) } V_e'=(S_{e(1)}+S_{e(2)})/\{a(rm-1)\} V e ′ = ( S e ( 1 ) + S e ( 2 ) ) / { a ( r m − 1 )}
E ( V e ′ ) E(V_e') E ( V e ′ ) σ ( 1 ) 2 , σ ( 2 ) 2 \sigma_{(1)}^2,\sigma_{(2)}^2 σ ( 1 ) 2 , σ ( 2 ) 2 a = 3 , r = 3 , m = 2 , σ ( 1 ) 2 = 2 , σ ( 2 ) 2 = 0.5 a=3,\ r=3,\ m=2,\ \sigma_{(1)}^2=2,\ \sigma_{(2)}^2=0.5 a = 3 , r = 3 , m = 2 , σ ( 1 ) 2 = 2 , σ ( 2 ) 2 = 0.5 E ( V e ( 1 ) ) E(V_{e(1)}) E ( V e ( 1 ) ) E ( V e ′ ) E(V_e') E ( V e ′ ) σ A 2 = 0 \sigma_A^2=0 σ A 2 = 0 E ( V A ) E(V_A) E ( V A ) (2) の設定で、V A / V e ′ V_A/V_e' V A / V e ′ F 2 , 15 ( 0.05 ) = 3.68 F_{2,15}(0.05)=3.68 F 2 , 15 ( 0.05 ) = 3.68
解答
定理 14.2 から E ( S e ( 1 ) ) = a ( r − 1 ) ( σ ( 2 ) 2 + m σ ( 1 ) 2 ) , E ( S e ( 2 ) ) = a r ( m − 1 ) σ ( 2 ) 2 E(S_{e(1)})=a(r-1)(\sigma_{(2)}^2+m\sigma_{(1)}^2),\ E(S_{e(2)})=ar(m-1)\sigma_{(2)}^2 E ( S e ( 1 ) ) = a ( r − 1 ) ( σ ( 2 ) 2 + m σ ( 1 ) 2 ) , E ( S e ( 2 ) ) = a r ( m − 1 ) σ ( 2 ) 2
E ( S e ( 1 ) + S e ( 2 ) ) = a { ( r − 1 ) + r ( m − 1 ) } σ ( 2 ) 2 + a m ( r − 1 ) σ ( 1 ) 2 = a ( r m − 1 ) σ ( 2 ) 2 + a m ( r − 1 ) σ ( 1 ) 2 . E(S_{e(1)}+S_{e(2)})=a\{(r-1)+r(m-1)\}\sigma_{(2)}^2+am(r-1)\sigma_{(1)}^2=a(rm-1)\sigma_{(2)}^2+am(r-1)\sigma_{(1)}^2 . E ( S e ( 1 ) + S e ( 2 ) ) = a {( r − 1 ) + r ( m − 1 )} σ ( 2 ) 2 + am ( r − 1 ) σ ( 1 ) 2 = a ( r m − 1 ) σ ( 2 ) 2 + am ( r − 1 ) σ ( 1 ) 2 .
a ( r m − 1 ) a(rm-1) a ( r m − 1 )
E ( V e ′ ) = σ ( 2 ) 2 + m ( r − 1 ) r m − 1 σ ( 1 ) 2 . E(V_e')=\sigma_{(2)}^2+\frac{m(r-1)}{rm-1}\sigma_{(1)}^2 . E ( V e ′ ) = σ ( 2 ) 2 + r m − 1 m ( r − 1 ) σ ( 1 ) 2 .
m ≥ 2 m\geq2 m ≥ 2 ( r − 1 ) / ( r m − 1 ) < 1 / m (r-1)/(rm-1)<1/m ( r − 1 ) / ( r m − 1 ) < 1/ m m m m E ( V e ( 1 ) ) = 0.5 + 2 × 2 = 4.5 E(V_{e(1)})=0.5+2\times2=4.5 E ( V e ( 1 ) ) = 0.5 + 2 × 2 = 4.5 E ( V e ′ ) = 0.5 + 2 × 2 5 × 2 = 0.5 + 1.6 = 2.1 E(V_e')=0.5+\dfrac{2\times2}{5}\times2=0.5+1.6=2.1 E ( V e ′ ) = 0.5 + 5 2 × 2 × 2 = 0.5 + 1.6 = 2.1 H 0 H_0 H 0 E ( V A ) = σ ( 2 ) 2 + m σ ( 1 ) 2 = 4.5 E(V_A)=\sigma_{(2)}^2+m\sigma_{(1)}^2=4.5 E ( V A ) = σ ( 2 ) 2 + m σ ( 1 ) 2 = 4.5
S A ∼ 4.5 χ 2 2 , S e ( 1 ) ∼ 4.5 χ 6 2 , S e ( 2 ) ∼ 0.5 χ 9 2 S_A\sim4.5\chi^2_2,\qquad S_{e(1)}\sim4.5\chi^2_6,\qquad S_{e(2)}\sim0.5\chi^2_9 S A ∼ 4.5 χ 2 2 , S e ( 1 ) ∼ 4.5 χ 6 2 , S e ( 2 ) ∼ 0.5 χ 9 2
乱数で V A / V e ′ V_A/V_e' V A / V e ′ V A / V e ( 1 ) V_A/V_{e(1)} V A / V e ( 1 ) F 2 , 6 ( 0.05 ) F_{2,6}(0.05) F 2 , 6 ( 0.05 )
例題 14.2 同じ費用で実験と測定の回数を配分する ★★
オリジナル ある材料の強度を測る実験で、1次誤差の分散が σ ( 1 ) 2 = 1 \sigma_{(1)}^2=1 σ ( 1 ) 2 = 1 σ ( 2 ) 2 = 4 \sigma_{(2)}^2=4 σ ( 2 ) 2 = 4 c 1 = 9 c_1=9 c 1 = 9 c 2 = 1 c_2=1 c 2 = 1 C = 90 C=90 C = 90
水準の平均 x ˉ i ⋅ ⋅ \bar x_{i\cdot\cdot} x ˉ i ⋅⋅ m ∗ m^* m ∗
測定を1回だけにして予算をすべて実験に回したときの r r r
解答
命題 14.3 から m ∗ = 9 × 4 / ( 1 × 1 ) = 36 = 6 m^*=\sqrt{9\times4/(1\times1)}=\sqrt{36}=6 m ∗ = 9 × 4/ ( 1 × 1 ) = 36 = 6 r = C / ( c 1 + m ∗ c 2 ) = 90 / ( 9 + 6 ) = 6 r=C/(c_1+m^*c_2)=90/(9+6)=6 r = C / ( c 1 + m ∗ c 2 ) = 90/ ( 9 + 6 ) = 6
V [ x ˉ i ⋅ ⋅ ] = σ ( 1 ) 2 r + σ ( 2 ) 2 r m = 1 6 + 4 36 = 10 36 ≈ 0.278. V[\bar x_{i\cdot\cdot}]=\frac{\sigma_{(1)}^2}{r}+\frac{\sigma_{(2)}^2}{rm}=\frac16+\frac4{36}=\frac{10}{36}\approx0.278 . V [ x ˉ i ⋅⋅ ] = r σ ( 1 ) 2 + r m σ ( 2 ) 2 = 6 1 + 36 4 = 36 10 ≈ 0.278.
命題の最小値の式でも ( 1 × 3 + 2 × 1 ) 2 / 90 = 25 / 90 ≈ 0.278 (1\times3+2\times1)^2/90=25/90\approx0.278 ( 1 × 3 + 2 × 1 ) 2 /90 = 25/90 ≈ 0.278 m = 1 m=1 m = 1 r = 90 / ( 9 + 1 ) = 9 r=90/(9+1)=9 r = 90/ ( 9 + 1 ) = 9 1 / 9 + 4 / 9 = 5 / 9 ≈ 0.556 1/9+4/9=5/9\approx0.556 1/9 + 4/9 = 5/9 ≈ 0.556
確認テスト
オリジナル
14.1-1 同じ試験片を5回測って得た5個の値の不偏分散は、どの分散成分の推定量か。また、それを誤差分散として要因の検定に使ってはいけない理由を1文で述べよ。14.1-2 構造式 (14.1) のもとで、E ( S e ( 2 ) ) = a r ( m − 1 ) σ ( 2 ) 2 E(S_{e(2)})=ar(m-1)\sigma_{(2)}^2 E ( S e ( 2 ) ) = a r ( m − 1 ) σ ( 2 ) 2 x i j k − x ˉ i j ⋅ x_{ijk}-\bar x_{ij\cdot} x ij k − x ˉ ij ⋅ 14.1-3 a = 4 , r = 2 , m = 3 a=4,\ r=2,\ m=3 a = 4 , r = 2 , m = 3 V e ( 1 ) = 5 , V e ( 2 ) = 1 V_{e(1)}=5,\ V_{e(2)}=1 V e ( 1 ) = 5 , V e ( 2 ) = 1 V [ x ˉ i ⋅ ⋅ ] V[\bar x_{i\cdot\cdot}] V [ x ˉ i ⋅⋅ ] 14.1-4 σ ( 1 ) 2 = 0.5 , σ ( 2 ) 2 = 2 , c 1 = 4 , c 2 = 2 \sigma_{(1)}^2=0.5,\ \sigma_{(2)}^2=2,\ c_1=4,\ c_2=2 σ ( 1 ) 2 = 0.5 , σ ( 2 ) 2 = 2 , c 1 = 4 , c 2 = 2 m ∗ m^* m ∗
g ( m ) = ( σ ( 1 ) 2 + σ ( 2 ) 2 m ) ( c 1 + m c 2 ) g(m)=\Bigl(\sigma_{(1)}^2+\frac{\sigma_{(2)}^2}{m}\Bigr)(c_1+mc_2) g ( m ) = ( σ ( 1 ) 2 + m σ ( 2 ) 2 ) ( c 1 + m c 2 ) 14.1-5 各実験の測定値を平均した x ˉ i j ⋅ \bar x_{ij\cdot} x ˉ ij ⋅ S A / m S_A/m S A / m S e ( 1 ) / m S_{e(1)}/m S e ( 1 ) / m V A / V e ( 1 ) V_A/V_{e(1)} V A / V e ( 1 )
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com