統計学の復習 第9章 §9.1 ★★★ 推定量は標本の関数で、それ自体が確率変数。良さは不偏性・平均二乗誤差・一致性で測る
この章は、対策本の第17章(点推定)に当たる。
第8章までで、母集団から無作為に取り出した標本 X1,…,Xn が互いに独立で同じ分布に従う確率変数であること、標本平均 Xˉ の期待値が μ、分散が σ2/n になることを見た。この章では向きを逆にして、標本から未知の母数 θ を1つの数で言い当てる点推定を扱う。道具として、推定量と推定値の区別、推定量の良さを測る不偏性・平均二乗誤差・一致性の3つの物差し、標準誤差を定義する。
2級の試験では「不偏分散を計算せよ」「標準誤差を求めよ」「不偏推定量はどれか」が単独の小問として出る。1級の統計数理では、最尤推定量を求めたあとに「不偏か」「一致推定量か」「平均二乗誤差を求めよ」と続く小問が定番になっている。この章ではその問いに答えるための定義と、2級の範囲の道具(期待値の線形性・独立な和の分散・Chebyshev の不等式)だけで示せる結果を導出つきで書く。最尤法・モーメント法・Fisher 情報量・Cramér–Rao の不等式は、数理統計の解説 第6章で扱う。
記号は第2章に揃える。n で割る標本分散を σ^2、n−1 で割る不偏分散を確率変数のときは S2、実現値のときは s2 と書く。
母数・統計量・推定量
母集団の分布が、値の分からない定数 θ を1つ決めれば定まるとする。例えば正規母集団 N(μ,σ2) では μ と σ2、ベルヌーイ母集団(1 を確率 p、0 を確率 1−p でとる)では p がこれに当たる。このような定数を母数(パラメータ)と呼ぶ。母数は確率変数ではなく、ただ値が分からないだけの定数である。
定義 9.1(統計量・推定量・推定値)
X1,…,Xn を母集団からの無作為標本(独立で同じ分布に従う確率変数)とする。
- 標本の関数 T=T(X1,…,Xn) で、未知の母数を含まないものを統計量と呼ぶ。
- 母数 θ を言い当てるために使う統計量を θ の推定量と呼び、θ^ と書く。
- 観測した値 x1,…,xn を推定量に代入して得られる数 T(x1,…,xn) を推定値と呼ぶ。
統計量の条件「未知の母数を含まない」は、データが手に入れば値が計算できることを意味する。μ が未知のとき、∑(Xi−μ)2 は μ を含むので統計量ではない。
推定量は確率変数なので、期待値や分散や分布をもつ。推定値は1つの数なので、それらをもたない。推定量の良し悪しは、推定値1つではなく、推定量の分布で論じることになる。
推定量と推定値を取り違えない
「xˉ=52.3 は μ の不偏推定値である」という言い方は、厳密には意味をもたない。52.3 は定数なので期待値は 52.3 そのもので、μ に等しいかどうかは分からない。不偏であるのは、標本を取り直すたびに値の変わる確率変数 Xˉ の方である。記号でも、推定量は大文字 Xˉ,S2、推定値は小文字 xˉ,s2 と書き分ける。
推定量の良さを測る3つの物差し
推定量 θ^ は確率変数なので、ある標本では θ より大きく、別の標本では小さくなる。そこで「平均として θ の周りにあるか」「θ からのずれの2乗は平均してどれほどか」「標本を増やせば θ に近づくか」の3つを定義する。
定義 9.2(不偏推定量・偏り・平均二乗誤差)
- すべての θ について E[θ^]=θ が成り立つ推定量を、θ の不偏推定量と呼ぶ。
- b(θ)=E[θ^]−θ を θ^ の偏り(バイアス)と呼ぶ。
- MSE(θ^)=E[(θ^−θ)2] を θ^ の平均二乗誤差と呼ぶ。
不偏性の定義にある「すべての θ について」は省けない条件である。例えば θ^≡5(データを見ずに常に 5 と答える推定量)は、真の値がたまたま 5 のときだけ E[θ^]=θ を満たすが、不偏推定量ではない。期待値は θ の値ごとに変わる分布で計算するので、E[θ^] は θ の関数であり、その関数が恒等的に θ に一致することを求めている。
命題 9.3(平均二乗誤差の分解)
MSE(θ^)=V[θ^]+b(θ)2.(9.1)
特に不偏推定量では MSE(θ^)=V[θ^] である。
証明
m=E[θ^] とおくと θ^−θ=(θ^−m)+(m−θ) で、m−θ=b(θ) は定数である。2乗して期待値をとると
E[(θ^−θ)2]=E[(θ^−m)2]+2b(θ)E[θ^−m]+b(θ)2.
E[θ^−m]=m−m=0 なので中央の項は消え、第1項は V[θ^] である。
これは第4章の定理「E[(X−c)2]=V[X]+(μ−c)2」で X=θ^、c=θ とおいたものと同じ式である。平均二乗誤差は「ばらつき」と「中心のずれの2乗」の和に分かれる。偏りが 0 でも分散が大きければ平均二乗誤差は大きく、偏りを少し許して分散を大きく減らせば平均二乗誤差は小さくなりうる。
同じ母数の不偏推定量が2つあるとき、分散の小さい方をより有効であるという。不偏推定量の分散がどこまで小さくなりうるかの下限(Cramér–Rao の不等式)は、数理統計の解説 第6章 §6.3 で扱う。
定義 9.4(一致推定量)
標本の大きさ n ごとに推定量 θ^n が定まっているとする。任意の ε>0 と、すべての θ について
n→∞limP(∣θ^n−θ∣≥ε)=0
が成り立つとき、θ^n を θ の一致推定量と呼ぶ。
一致性は「標本を増やせば、θ から ε 以上ずれる確率がいくらでも小さくなる」ことを表す。不偏性は1つの n についての性質で、一致性は n→∞ での性質なので、どちらか一方だけをもつ推定量がある(確認テスト 9.1-2・9.1-3)。
命題 9.5(平均二乗誤差による一致性の十分条件)
n→∞ で MSE(θ^n)→0 ならば、θ^n は θ の一致推定量である。(9.1) により、条件は「偏り →0 かつ分散 →0」と同じである。
証明
第4章の Chebyshev の不等式の証明で、期待値 μ を任意の定数 c に取り替えても同じ議論が通り、P(∣Y−c∣≥ε)≤E[(Y−c)2]/ε2 が成り立つ。実際、連続型なら ∣y−c∣≥ε の範囲で (y−c)2≥ε2 なので
E[(Y−c)2] ≥ ∫∣y−c∣≥ε(y−c)2f(y)dy ≥ ε2P(∣Y−c∣≥ε)
である(離散型は積分を和に変える)。Y=θ^n、c=θ とおくとP(∣θ^n−θ∣≥ε)≤MSE(θ^n)/ε2→0。
例題 9.1 母比率の2つの推定量の平均二乗誤差 ★★★
オリジナル成功の確率が p のベルヌーイ試行を独立に n 回行い、成功の回数を X とする(X∼Bin(n,p))。p の推定量として
p^=nX,p~=n+2X+1
を比べる。
- p^ と p~ の偏りと分散を求めよ。
- 平均二乗誤差 MSE(p^) と MSE(p~) を求め、n=10、p=0.5 と p=0.05 のときの値を比べよ。
- n=10 のとき、MSE(p~)<MSE(p^) となる p の範囲を求めよ。
- 2つの推定量はどちらも一致推定量であることを示せ。
解答
(1) 第5章の結果 E[X]=np、V[X]=np(1−p) を使う。p^ は
E[p^]=nnp=p,V[p^]=n2np(1−p)=np(1−p)
で、偏りは 0 である。p~ は
E[p~]=n+2np+1,b(p)=n+2np+1−p=n+21−2p,V[p~]=(n+2)2np(1−p)
である。p~ は p=1/2 のときだけ偏りが 0 で、それ以外の p では 1/2 の側へ偏る。分散は p^ の n2/(n+2)2 倍で、p^ より小さい。
(2) (9.1) から
MSE(p^)=np(1−p),MSE(p~)=(n+2)2np(1−p)+(1−2p)2.
n=10、p=0.5 では MSE(p^)=0.25/10=0.025、MSE(p~)=2.5/144≈0.0174 で、p~ の方が小さい。p=0.05 では MSE(p^)=0.0475/10=0.00475、MSE(p~)=(0.475+0.81)/144≈0.00892 で、p^ の方が小さい。
(3) q=p(1−p) とおくと (1−2p)2=1−4q である。MSE(p~)<MSE(p^) は
n{nq+(1−4q)}<(n+2)2q⟺n<{(n+2)2−n2+4n}q=(8n+4)q
と同値なので、条件は p(1−p)>n/(8n+4) である。n=10 では p(1−p)>10/84≈0.1190 となる。p2−p+0.1190<0 を解いて 0.138<p<0.862(小数第3位まで)。図 9.1 の2本の曲線の交点がこの両端である。
(4) n→∞ で MSE(p^)=p(1−p)/n→0。MSE(p~) は分子が n の1次式、分母が n の2次式なので 0 に近づく。命題 9.5 によりどちらも一致推定量である。
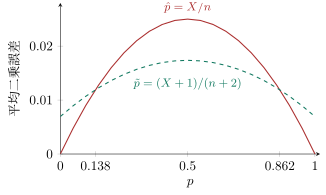
図 9.1 n=10 のときの母比率の推定量の平均二乗誤差。赤の実線が不偏な p^、緑の破線が偏りのある p~。0.138<p<0.862 では p~ の方が小さく、p が 0 や 1 に近いと p^ の方が小さい。どの p でも一方が他方より小さい、という関係にはならない。
例題 9.1 は、平均二乗誤差で比べると、すべての p で優れた推定量が決まらないことを示している。2級の範囲では「不偏な推定量の中で分散の小さいものを選ぶ」という考え方を採ることが多く、その代表が次の節の Xˉ である。
確認テスト
オリジナル
- 9.1-1 X1,…,Xn を N(μ,σ2) からの無作為標本とし、μ と σ2 はともに未知とする。次のうち統計量であるものをすべて選べ。(a) Xˉ (b) Xˉ−μ (c) maxiXi (d) n1∑(Xi−μ)2 (e) ∑Xi2
- 9.1-2 X1,…,Xn を N(μ,σ2) からの無作為標本とする。最初の観測 X1 だけを μ の推定量に使うとき、X1 は μ の不偏推定量であるが、一致推定量でないことを示せ。
- 9.1-3 E[Xˉ]=μ、V[Xˉ]=σ2/n とする。Tn=Xˉ+n1 の偏りと平均二乗誤差を求め、Tn が不偏ではないが一致推定量であることを示せ。
- 9.1-4 θ の推定量 θ^ の偏りが b、分散が v である。θ^ の平均二乗誤差を b,v で表せ。また E[θ^2] を θ,b,v で表し、θ^ が不偏でも θ^2 は θ2 の不偏推定量にならない(v>0 のとき)ことを示せ。
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com
