統計学の復習 第11章 §11.1 ★★★ p ^ \hat p p ^ p p p p ^ \hat p p ^ z α / 2 z_{\alpha/2} z α /2 t t t
この章は、対策本の第20章(母比率の区間推定)・第21章(母分散の区間推定)に当たる。
第10章では、正規母集団の母平均について、母分散が既知なら標準正規分布、未知なら t t t p p p σ 2 \sigma^2 σ 2
2つの母数で使う分布が違うのは、推定量の分布の出自が違うからである。母比率の推定量 p ^ \hat p p ^ n n n p ^ \hat p p ^ S 2 S^2 S 2 ( n − 1 ) S 2 / σ 2 (n-1)S^2/\sigma^2 ( n − 1 ) S 2 / σ 2 χ 2 \chi^2 χ 2
この章で作る道具は次の4つである。第一に、母比率の信頼区間を、正規近似から導き、近似が崩れる条件と、2次不等式を解いて作る区間(Wilson の区間)まで含めて扱う。第二に、区間の幅を指定したときに必要な標本の大きさを逆算する。第三に、2つの母比率の差の信頼区間を作り、検定(第13章)でプールした比率を使うのに区間ではプールしない理由を説明する。第四に、χ 2 \chi^2 χ 2 1 1 1
1級の統計数理では、「統計量の分布を導く → 母数を含みながら分布が母数によらない量(ピボット)を作る → 不等式を母数について解く」という区間の作り方そのものが記述で問われる。この章の母分散の区間は、その手順の最も基本的な例である。ピボットによる区間の一般論は数理統計の解説 第8章 §8.2 で扱う。
標本比率の分布
母集団の中で性質 A を持つものの割合を母比率 p p p n n n X X X X ∼ B i n ( n , p ) X\sim\mathrm{Bin}(n,p) X ∼ Bin ( n , p ) ( N − n ) / ( N − 1 ) (N-n)/(N-1) ( N − n ) / ( N − 1 ) 1 1 1 標本比率 を p ^ = X / n \hat p=X/n p ^ = X / n E [ X ] = n p E[X]=np E [ X ] = n p V [ X ] = n p ( 1 − p ) V[X]=np(1-p) V [ X ] = n p ( 1 − p ) E [ a X ] = a E [ X ] E[aX]=aE[X] E [ a X ] = a E [ X ] V [ a X ] = a 2 V [ X ] V[aX]=a^2V[X] V [ a X ] = a 2 V [ X ]
E [ p ^ ] = p , V [ p ^ ] = p ( 1 − p ) n (11.1) E[\hat p]=p,\qquad V[\hat p]=\frac{p(1-p)}{n}\tag{11.1} E [ p ^ ] = p , V [ p ^ ] = n p ( 1 − p ) ( 11.1 )
となる。p ^ \hat p p ^ p p p n n n
X X X 1 1 1 0 0 0 B 1 , … , B n B_1,\dots,B_n B 1 , … , B n p ^ = ( B 1 + ⋯ + B n ) / n \hat p=(B_1+\cdots+B_n)/n p ^ = ( B 1 + ⋯ + B n ) / n p p p p ( 1 − p ) p(1-p) p ( 1 − p ) n n n
Z = p ^ − p p ( 1 − p ) / n の分布は N ( 0 , 1 ) で近似できる (11.2) Z=\frac{\hat p-p}{\sqrt{p(1-p)/n}}\ \ \text{の分布は}\ \ \mathrm{N}(0,1)\ \ \text{で近似できる}\tag{11.2} Z = p ( 1 − p ) / n p ^ − p の分布は N ( 0 , 1 ) で近似できる ( 11.2 )
ことが分かる(第8章 §8.5 で扱った二項分布の正規近似)。
区間の導出
上側 100 α / 2 % 100\alpha/2\% 100 α /2% z α / 2 z_{\alpha/2} z α /2 (11.2) から
P ( − z α / 2 ≤ p ^ − p p ( 1 − p ) / n ≤ z α / 2 ) ≈ 1 − α P\!\left(-z_{\alpha/2}\le\frac{\hat p-p}{\sqrt{p(1-p)/n}}\le z_{\alpha/2}\right)\approx1-\alpha P ( − z α /2 ≤ p ( 1 − p ) / n p ^ − p ≤ z α /2 ) ≈ 1 − α
である。括弧の中を p p p p p p p p p p p p p ^ \hat p p ^ n n n p ^ \hat p p ^ p p p p p p
P ( p ^ − z α / 2 p ^ ( 1 − p ^ ) n ≤ p ≤ p ^ + z α / 2 p ^ ( 1 − p ^ ) n ) ≈ 1 − α P\!\left(\hat p-z_{\alpha/2}\sqrt{\frac{\hat p(1-\hat p)}n}\le p\le\hat p+z_{\alpha/2}\sqrt{\frac{\hat p(1-\hat p)}n}\right)\approx1-\alpha P ( p ^ − z α /2 n p ^ ( 1 − p ^ ) ≤ p ≤ p ^ + z α /2 n p ^ ( 1 − p ^ ) ) ≈ 1 − α
と解くことができる。
命題 11.1(母比率の信頼区間(Wald 型))
n n n x x x p ^ = x / n \hat p=x/n p ^ = x / n p p p 1 − α 1-\alpha 1 − α
[ p ^ − z α / 2 p ^ ( 1 − p ^ ) n , p ^ + z α / 2 p ^ ( 1 − p ^ ) n ] (11.3) \left[\ \hat p-z_{\alpha/2}\sqrt{\frac{\hat p(1-\hat p)}n}\ ,\ \ \hat p+z_{\alpha/2}\sqrt{\frac{\hat p(1-\hat p)}n}\ \right]\tag{11.3} [ p ^ − z α /2 n p ^ ( 1 − p ^ ) , p ^ + z α /2 n p ^ ( 1 − p ^ ) ] ( 11.3 )
である。p ^ ( 1 − p ^ ) / n \sqrt{\hat p(1-\hat p)/n} p ^ ( 1 − p ^ ) / n p ^ \hat p p ^ 標準誤差 と呼ぶ。95% 区間では z 0.025 = 1.960 z_{0.025}=1.960 z 0.025 = 1.960 z 0.005 = 2.576 z_{0.005}=2.576 z 0.005 = 2.576 z 0.05 = 1.645 z_{0.05}=1.645 z 0.05 = 1.645
近似を使ってよい目安として、n p ^ ≥ 5 n\hat p\ge5 n p ^ ≥ 5 n ( 1 − p ^ ) ≥ 5 n(1-\hat p)\ge5 n ( 1 − p ^ ) ≥ 5 n n n
なぜ t t t
第10章の母平均では、母分散が未知なら σ \sigma σ s s s t t t p p p p ^ \hat p p ^ z z z
正規分布 N ( μ , σ 2 ) \mathrm{N}(\mu,\sigma^2) N ( μ , σ 2 ) μ \mu μ σ 2 \sigma^2 σ 2 σ \sigma σ s s s ( X ˉ − μ ) / ( s / n ) (\bar X-\mu)/(s/\sqrt n) ( X ˉ − μ ) / ( s / n ) N ( 0 , 1 ) \mathrm{N}(0,1) N ( 0 , 1 ) t n − 1 t_{n-1} t n − 1 t t t
ベルヌーイ分布の母数は p p p p ( 1 − p ) p(1-p) p ( 1 − p ) p p p p p p p ^ \hat p p ^ p ^ \hat p p ^ (11.2) の段階ですでに正規分布で近似している。分母を置き換える誤差は、この近似の誤差と同じ程度の大きさの小さな項に含まれてしまうので、t t t n p ^ n\hat p n p ^ n ( 1 − p ^ ) n(1-\hat p) n ( 1 − p ^ ) t t t z z z
近似の崩れと、2次不等式を解く区間
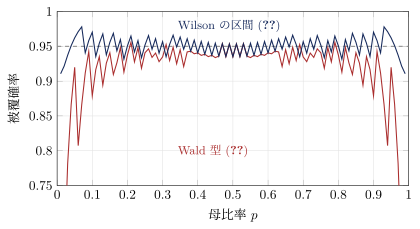
区間 (11.3) が「95% の確率で p p p X X X p p p 被覆確率 )は、二項分布の確率を足し合わせて正確に計算することができる。n = 50 n=50 n = 50 p p p X = 0 , 1 , … , 50 X=0,1,\dots,50 X = 0 , 1 , … , 50 p p p X X X 11.1 に示す。
図 11.1 n = 50 n=50 n = 50 p p p 0.95 0.95 0.95 p = 0.5 p=0.5 p = 0.5 0.935 0.935 0.935 p = 0.1 p=0.1 p = 0.1 0.879 0.879 0.879 p = 0.01 p=0.01 p = 0.01 0.395 0.395 0.395 0.91 0.91 0.91 X X X
被覆確率が名目を下回る原因は2つある。1つは X X X p p p 0 0 0 1 1 1 x = 0 x=0 x = 0 p ^ = 0 \hat p=0 p ^ = 0 0 0 0 (11.3) は1点 [ 0 , 0 ] [0,0] [ 0 , 0 ] p = 0 p=0 p = 0
この欠点は、分母の p p p p ^ \hat p p ^ ∣ p ^ − p ∣ ≤ z p ( 1 − p ) / n \lvert \hat p-p\rvert \le z\sqrt{p(1-p)/n} ∣ p ^ − p ∣ ≤ z p ( 1 − p ) / n z = z α / 2 z=z_{\alpha/2} z = z α /2
( p ^ − p ) 2 ≤ z 2 n p ( 1 − p ) ⟺ ( 1 + z 2 n ) p 2 − ( 2 p ^ + z 2 n ) p + p ^ 2 ≤ 0 (\hat p-p)^2\le\frac{z^2}np(1-p)
\iff\Bigl(1+\frac{z^2}n\Bigr)p^2-\Bigl(2\hat p+\frac{z^2}n\Bigr)p+\hat p^2\le0 ( p ^ − p ) 2 ≤ n z 2 p ( 1 − p ) ⟺ ( 1 + n z 2 ) p 2 − ( 2 p ^ + n z 2 ) p + p ^ 2 ≤ 0
となる。左辺は p p p p 2 p^2 p 2 p p p ( 2 p ^ + z 2 / n ) 2 − 4 ( 1 + z 2 / n ) p ^ 2 = 4 ( z 2 / n ) p ^ ( 1 − p ^ ) + ( z 2 / n ) 2 (2\hat p+z^2/n)^2-4(1+z^2/n)\hat p^2=4(z^2/n)\hat p(1-\hat p)+(z^2/n)^2 ( 2 p ^ + z 2 / n ) 2 − 4 ( 1 + z 2 / n ) p ^ 2 = 4 ( z 2 / n ) p ^ ( 1 − p ^ ) + ( z 2 / n ) 2
p = p ^ + z 2 2 n ± z p ^ ( 1 − p ^ ) n + z 2 4 n 2 1 + z 2 n (11.4) p=\frac{\hat p+\dfrac{z^2}{2n}\pm z\sqrt{\dfrac{\hat p(1-\hat p)}n+\dfrac{z^2}{4n^2}}}{1+\dfrac{z^2}n}\tag{11.4} p = 1 + n z 2 p ^ + 2 n z 2 ± z n p ^ ( 1 − p ^ ) + 4 n 2 z 2 ( 11.4 )
が区間の両端になる。これを Wilson の区間 と呼ぶ。中心は p ^ \hat p p ^ p ^ \hat p p ^ 1 / 2 1/2 1/2 x = 0 x=0 x = 0 0 0 0 n n n z 2 / n z^2/n z 2 / n (11.4) は (11.3) に一致する。2級で問われるのは (11.3) だが、2次不等式から区間を作る手順は1級の記述でそのまま使う形である。二項分布の確率そのものから作る正確な区間(Clopper–Pearson の区間)と、漸近正規性から作る区間の一般論は数理統計の解説 第8章 §8.2 で扱う。
注意
信頼区間の解釈は第10章と同じである。p p p p p p [ 0.318 , 0.402 ] [0.318,0.402] [ 0.318 , 0.402 ] p p p 0 0 0 1 1 1
例題 11.1 世論調査の支持率の区間 ★★★
オリジナル ある政策について無作為に選んだ500人に尋ねたところ、180人が賛成と答えた。
賛成の母比率 p p p (11.3) で求めよ。
正規近似の目安が満たされているかを確かめよ。
Wilson の区間 (11.4) を求め、(1) と比べよ。
解答 (1) p ^ = 180 / 500 = 0.36 \hat p=180/500=0.36 p ^ = 180/500 = 0.36
0.36 × 0.64 500 = 0.0004608 = 0.021466 \sqrt{\frac{0.36\times0.64}{500}}=\sqrt{0.0004608}=0.021466 500 0.36 × 0.64 = 0.0004608 = 0.021466
で、半幅は 1.960 × 0.021466 = 0.04207 1.960\times0.021466=0.04207 1.960 × 0.021466 = 0.04207
[ 0.36 − 0.04207 , 0.36 + 0.04207 ] = [ 0.3179 , 0.4021 ] . [\,0.36-0.04207,\ 0.36+0.04207\,]=[\,0.3179,\ 0.4021\,]. [ 0.36 − 0.04207 , 0.36 + 0.04207 ] = [ 0.3179 , 0.4021 ] .
(2) n p ^ = 180 n\hat p=180 n p ^ = 180 n ( 1 − p ^ ) = 320 n(1-\hat p)=320 n ( 1 − p ^ ) = 320
(3) z 2 = 1.960 2 = 3.8415 z^2=1.960^2=3.8415 z 2 = 1.96 0 2 = 3.8415 z 2 / n = 0.0076829 z^2/n=0.0076829 z 2 / n = 0.0076829 1 + 0.0076829 = 1.0076829 1+0.0076829=1.0076829 1 + 0.0076829 = 1.0076829 0.36 + 0.0076829 / 2 = 0.363841 0.36+0.0076829/2=0.363841 0.36 + 0.0076829/2 = 0.363841 0.0004608 + 3.8415 / ( 4 × 500 2 ) = 0.0004608 + 0.0000038415 = 0.00046464 0.0004608+3.8415/(4\times500^2)=0.0004608+0.0000038415=0.00046464 0.0004608 + 3.8415/ ( 4 × 50 0 2 ) = 0.0004608 + 0.0000038415 = 0.00046464 0.021556 0.021556 0.021556 z z z 0.042249 0.042249 0.042249
[ 0.363841 − 0.042249 1.0076829 , 0.363841 + 0.042249 1.0076829 ] = [ 0.3191 , 0.4030 ] . \left[\frac{0.363841-0.042249}{1.0076829},\ \frac{0.363841+0.042249}{1.0076829}\right]=[\,0.3191,\ 0.4030\,]. [ 1.0076829 0.363841 − 0.042249 , 1.0076829 0.363841 + 0.042249 ] = [ 0.3191 , 0.4030 ] .
Wald 型と比べると、両端がどちらも 0.001 0.001 0.001 1 / 2 1/2 1/2 n p ^ n\hat p n p ^ n ( 1 − p ^ ) n(1-\hat p) n ( 1 − p ^ )
例題 11.2 成功が少ないときの区間 ★★
オリジナル 新しい部品を40個試験したところ、4個が規定の時間内に故障した。故障率 p p p
解答 p ^ = 4 / 40 = 0.1 \hat p=4/40=0.1 p ^ = 4/40 = 0.1 0.1 × 0.9 / 40 = 0.00225 = 0.04743 \sqrt{0.1\times0.9/40}=\sqrt{0.00225}=0.04743 0.1 × 0.9/40 = 0.00225 = 0.04743 1.960 × 0.04743 = 0.09297 1.960\times0.04743=0.09297 1.960 × 0.04743 = 0.09297
Wald 型: [ 0.1 − 0.0930 , 0.1 + 0.0930 ] = [ 0.0070 , 0.1930 ] \text{Wald 型:}[\,0.1-0.0930,\ 0.1+0.0930\,]=[\,0.0070,\ 0.1930\,] Wald 型: [ 0.1 − 0.0930 , 0.1 + 0.0930 ] = [ 0.0070 , 0.1930 ]
である。Wilson の区間は、z 2 / n = 3.8415 / 40 = 0.096037 z^2/n=3.8415/40=0.096037 z 2 / n = 3.8415/40 = 0.096037 1.096037 1.096037 1.096037 0.1 + 0.048019 = 0.148019 0.1+0.048019=0.148019 0.1 + 0.048019 = 0.148019 0.00225 + 3.8415 / 6400 = 0.00285023 0.00225+3.8415/6400=0.00285023 0.00225 + 3.8415/6400 = 0.00285023 0.053388 0.053388 0.053388 z z z 0.104638 0.104638 0.104638
Wilson: [ 0.148019 − 0.104638 1.096037 , 0.148019 + 0.104638 1.096037 ] = [ 0.0396 , 0.2305 ] \text{Wilson:}\left[\frac{0.148019-0.104638}{1.096037},\ \frac{0.148019+0.104638}{1.096037}\right]=[\,0.0396,\ 0.2305\,] Wilson : [ 1.096037 0.148019 − 0.104638 , 1.096037 0.148019 + 0.104638 ] = [ 0.0396 , 0.2305 ]
である。n p ^ = 4 < 5 n\hat p=4<5 n p ^ = 4 < 5 p ^ = 0.1 \hat p=0.1 p ^ = 0.1 0 0 0 p p p p ^ \hat p p ^
確認テスト
オリジナル
11.1-1 母平均の区間では母分散が未知なら t t t p ^ \hat p p ^ z z z 11.1-2 1200人を調べたところ420人がある商品を知っていた。認知率の99% 信頼区間を Wald 型で求めよ(z 0.005 = 2.576 z_{0.005}=2.576 z 0.005 = 2.576 11.1-3 20個を検査して不良品が1個もなかった。Wald 型の95% 区間がどうなるかを述べ、Wilson の区間 (11.4) を p ^ = 0 \hat p=0 p ^ = 0 11.1-4 片側の区間 p ≤ p ^ + z α p ^ ( 1 − p ^ ) / n p\le\hat p+z_{\alpha}\sqrt{\hat p(1-\hat p)/n} p ≤ p ^ + z α p ^ ( 1 − p ^ ) / n 上側信頼限界 と呼ぶ。この不等式が近似的に確率 1 − α 1-\alpha 1 − α (11.2) から説明し、400個中24個が不良だったときの不良率の95% 上側信頼限界を求めよ(z 0.05 = 1.645 z_{0.05}=1.645 z 0.05 = 1.645
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com