統計学の復習 第13章 §13.3 ★★★ 期待度数とのずれの2乗を期待度数で割って足した X2 は、H0 の下で近似的に χ2 分布に従う。自由度はカテゴリ数から拘束の数を引いたもので、検定は常に右片側
統計量
n 個の観測を、互いに重ならない k 個のカテゴリに分類する。カテゴリ j に入った個数(観測度数)を Oj とすると、O1+⋯+Ok=n である。各観測が独立に確率 pj でカテゴリ j に入るとき、帰無仮説
H0: pj=pj0(j=1,…,k)
を検定したい。p10,…,pk0 は与えられた数で、合計は 1 である。H0 の下で、カテゴリ j に入る個数の期待値は
Ej=npj0
で、これを期待度数と呼ぶ(Ej は添字つきの数で、期待値の記号 E[⋅] とは別のものである)。
定義 13.3(Pearson の X2 統計量)
観測度数 Oj と期待度数 Ej から作る
X2=j=1∑kEj(Oj−Ej)2(13.5)
を Pearson の X2 統計量(カイ二乗統計量)と呼ぶ。
定理 13.4(X2 の近似分布)
H0 の下で、n が大きいとき、X2 の分布は自由度 k−1 の χ2 分布 χk−12 で近似できる。有意水準 α の棄却域は X2≥χk−12(α) である。
χν2 は、第10章で定義し、第11章で密度を導いた、独立な標準正規変数 ν 個の2乗和の分布である。定理 13.4 の一般の k での証明は、度数の組 (O1,…,Ok) の多次元の正規近似を使うので2級の範囲を越え、数理統計の解説 第7章 §7.4 で扱う。ここでは k=2 の場合を厳密に示し、一般の k で何が起きているかを自由度の数え方から説明する。
カテゴリが2つのとき
k=2 のとき、カテゴリ1に入る確率を p10=p0 とすると p20=1−p0 で、O1=X∼Bin(n,p0)、O2=n−X である。期待度数は E1=np0、E2=n(1−p0) で、
O2−E2=(n−X)−n(1−p0)=−(X−np0)=−(O1−E1)
が成り立つ。2つのカテゴリのずれは、大きさが同じで符号が逆である。したがって
X2=(X−np0)2{np01+n(1−p0)1}=(X−np0)2⋅np0(1−p0)(1−p0)+p0=np0(1−p0)(X−np0)2
となる。最後の式は、§13.1 の母比率の検定統計量 (13.1) の2乗 Z2 である。
命題 13.5(k=2 の X2 は Z2)
カテゴリが2つのとき、適合度の X2 は母比率の検定統計量の2乗に厳密に等しい:X2=Z2。Z は近似的に N(0,1) に従うので、X2 は近似的に χ12 に従う。
この計算から、X2 の分母がなぜ Ej なのかも分かる。Oj の分散は npj0(1−pj0)=Ej(1−pj0) なので、各カテゴリのずれを正しく標準化するなら分母は Ej(1−pj0) のはずである。しかし k 個のずれは和が 0 に縛られていて独立でなく、正しく標準化した2乗を k 個足すと、同じ情報を重ねて数えることになる。k=2 では、正しく標準化した2乗はどちらも Z2 に等しいので、足すと 2Z2 になってしまう。分母を Ej(1−pj0) より大きい Ej にすることで、この重ね数えがちょうど打ち消され、和が Z2 になる。一般の k でも同じことが成り立つ(証明は数理統計の解説 第7章 §7.4)。
両側検定の ∣Z∣≥zα/2 は Z2≥zα/22 と同値で、第11章で示した χ12(α)=zα/22 から、X2≥χ12(α) と同値である。つまり、k=2 の適合度検定と、母比率の両側検定とは、同じ検定である。
自由度の数え方
度数 O1,…,Ok は k 個あるが、和が n に決まっているので、k−1 個を決めると残りの1個は自動的に決まる。ずれ Oj−Ej も和が 0 で、自由に動けるのは k−1 個である。第9章で、偏差 Xi−Xˉ の和が 0 であることから偏差平方和の自由度が n−1 になったのと同じ数え方で、X2 の自由度は k−1 になる。
帰無仮説が確率を完全に指定せず、未知の母数を含む場合もある。たとえば「度数はポアソン分布に従う」という H0 では、pj0 が λ に依存し、λ をデータから推定してから期待度数を計算する。推定した母数があると、期待度数がデータに寄せて作られるので、ずれはその分だけ小さくなる。推定した母数1個につき、ずれに拘束が1本加わると考えてよく、自由度は次のようになる。
適合度検定の自由度
自由度=(カテゴリの数)−1−(データから推定した母数の数)
最初の 1 は度数の和が n であることからくる拘束で、推定した母数1個ごとに拘束が1本増える。
推定した母数の分だけ自由度が減ることの厳密な扱い(Wilks の定理)は数理統計の解説 第7章 §7.3・§7.4 で扱う。
右片側である理由と、近似の条件
X2 は、k 個のずれ Oj−Ej を、それぞれ Ej で割ってから2乗して足したもので、ずれのベクトルの長さの2乗にあたる。観測度数がどの方向に期待度数からずれても、X2 は大きくなる。H0 から外れていることは X2 が大きいことにしか現れないので、棄却域は右の裾 X2≥χk−12(α) だけである。平均の Z 検定の両側の棄却域 ∣Z∣≥zα/2 が2乗すると右片側 Z2≥zα/22 になったのと同じで、2乗した時点で向きの情報は消えている。
X2 が極端に小さいことは、観測度数が期待度数に近すぎることを意味する。これは H0 を棄却する理由にはならないが、偶然とは考えにくいほど理論に合っているので、データの作り方を疑うきっかけにはなる。
近似 χk−12 は n が大きいときのもので、目安としてすべての期待度数が 5 以上あることが求められる。期待度数が 5 未満のカテゴリがあれば、隣のカテゴリとまとめてから計算し、自由度もまとめた後のカテゴリの数で数える。棄却されたとき、どのカテゴリがずれているかは X2 からは分からない。2乗して足した時点で、どの成分がずれたかの情報は失われているからである。それを見るには、足す前の標準化残差 (Oj−Ej)/Ej を並べ、絶対値が2前後を超えるものを探す。
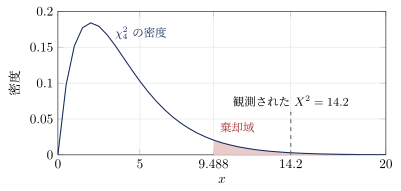
図 13.2 例題 13.4 の帰無分布 χ42 と、有意水準 5% の棄却域 x≥9.488(塗った部分)。観測値 14.2 は棄却域に入り、その右側の面積(p 値)は 0.0067 である。X2 が大きいことだけが H0 からの外れを表すので、棄却域は右の裾だけに置く。
例題 13.4 曜日ごとの件数は一様か ★★★
オリジナルある窓口に寄せられた苦情150件を、受け付けた曜日(月〜金)で分けると、(32,24,21,26,47) であった。苦情の件数は曜日によらず一様であるといえるかを、有意水準 5% で検定せよ。棄却されたら、どの曜日がずれているかを標準化残差で調べよ。
解答
H0 は「各曜日の確率は 1/5」で、期待度数はすべて Ej=150/5=30 である(5 以上なので近似の目安を満たす)。
X2=3022+(−6)2+(−9)2+(−4)2+172=304+36+81+16+289=30426=14.2.
推定した母数は無いので、自由度は 5−1=4 である。棄却域は X2≥χ42(0.05)=9.488 で、14.2 はこれに入る。H0 は棄却され、件数は曜日によって異なるといえる(p 値 0.0067、図 13.2)。
標準化残差 (Oj−30)/30 は、30=5.477 で割って
(0.37, −1.10, −1.64, −0.73, 3.10)
である。金曜日の 3.10 だけが絶対値2を大きく超え、X2=14.2 のうち 289/30=9.63 が金曜日の寄与である。ずれの主な原因は、金曜日の件数が多いことである。
例題 13.5 ポアソン分布への当てはまり ★★
オリジナルある交差点で、1時間あたりの車両の通過の異常を記録した。200時間について、1時間あたりの異常の回数を数えると次のとおりであった(4回以上の10時間は、すべてちょうど4回であった)。
回数がポアソン分布に従うといえるかを、有意水準 5% で検定せよ。
解答
λ は与えられていないので、データから推定する。ポアソン分布の平均は λ なので(第5章)、標本平均で推定して
λ^=2000×48+1×74+2×44+3×24+4×10=200274=1.37
である。Po(1.37) の確率は P(0)=e−1.37=0.25411、P(1)=1.37×0.25411=0.34813、P(2)=0.34813×1.37/2=0.23847、P(3)=0.23847×1.37/3=0.10890、P(4以上)=1−(0.25411+0.34813+0.23847+0.10890)=0.05040 で、200 を掛けた期待度数は
(50.82, 69.63, 47.69, 21.78, 10.08)
である。すべて 5 以上である。各カテゴリの (Oj−Ej)2/Ej は (0.157, 0.275, 0.286, 0.226, 0.001) で、X2=0.944 になる。
自由度は、カテゴリ5個から、度数の和の拘束1本と、推定した λ の1個を引いて 5−1−1=3 である。棄却域は X2≥χ32(0.05)=7.815 で、0.944 はこれに入らない。ポアソン分布に従わないとはいえない(p 値 0.815)。「従うとはいえない」と「従う」の違いに注意する。検定で棄却されないことは、H0 が正しいことを示したことにはならない(第12章)。
確認テスト
オリジナル
- 13.3-1 (a) 適合度検定の棄却域が右の裾だけである理由を1文で述べよ。(b) 度数分布を8つの階級に分け、平均と分散をデータから推定した正規分布に当てはまるかを検定するとき、自由度はいくつか。
- 13.3-2 ある交配で、4つの表現型が 9:3:3:1 の比で現れると予想される。160個体を調べると (95,28,27,10) であった。予想に合っているかを、有意水準 5% で検定せよ。
- 13.3-3 4つのカテゴリの確率が H0 で (0.5,0.3,0.15,0.05) と予想されている。60個の観測で度数は (26,17,13,4) であった。期待度数を計算し、近似の目安を満たさないカテゴリをまとめてから、有意水準 5% で検定せよ。
- 13.3-4 k=2 のとき X2=Z2(命題 13.5)となることを、O2−E2=−(O1−E1) から導け。さらに、各カテゴリのずれを分散 npj0(1−pj0) で正しく標準化して2乗した2つの量の和が 2Z2 になることを示せ。
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com
