数理統計 第8章 §8.2 ★★★ 枢軸量・検定の反転・漸近正規性の3つの作り方。1級で区間を求めさせる小問はこのどれかで解ける
枢軸量による方法
前節の正規平均の例では、標本平均と母数を組み合わせた Z=n(Xˉ−μ)/σ の分布が μ によらないという性質を使った。これを一般化する。
定義 8.2(枢軸量)
標本と母数の関数 Q(X,θ) で、その分布が θ によらないものを枢軸量(pivotal quantity)と呼ぶ。
定理 8.3(枢軸量からの信頼区間 ★★★)
Q(X,θ) を枢軸量とし、定数 q1<q2 を次のように選ぶ。
P(q1≤Q(X,θ)≤q2)=1−α
(Q の分布は母数によらないので、q1,q2 も母数によらない定数として選べる)。各 x について
C(x)={θ: q1≤Q(x,θ)≤q2}
とおく。このとき次が成り立つ。
- (i) すべての θ で Pθ(θ∈C(X))=1−α である。
- (ii) Q(x,θ) が母数について狭義単調なら、C(x) は区間になる。
証明
C の定義から、次の2つは同じ事象である。
{θ∈C(X)}={q1≤Q(X,θ)≤q2}
後者の確率は、真の値のもとでの Q(X,θ) の分布で計算される。その分布は母数によらないので、確率は 1−α に等しい。
Q が母数について狭義増加なら、逆関数 Q−1(x,⋅) を使って次のように書ける。
q1≤Q(x,θ)≤q2⟺Q−1(x,q1)≤θ≤Q−1(x,q2)
これは区間である。狭義減少なら端点が入れ替わる。
この定理で答案の型が決まる。手順は次の3段である。
- (i) 母数を含み分布が既知の量 Q を見つける。ほとんどの場合、第5章の標本分布の結果を引くことに当たる。
- (ii) Q の分布の分位点で、確率 1−α の区間を作る。
- (iii) 不等式を θ について解く。
以下、1級で使う枢軸量を並べる。
正規母集団の平均(分散未知)。
第5章 §5.2 で示したとおり、N(μ,σ2) の標本では標本平均と不偏分散が独立で、(n−1)S2/σ2∼χn−12 である。したがって
T=Sn(Xˉ−μ)=n−1(n−1)S2/σ2n(Xˉ−μ)/σ∼tn−1
であり、T の分布は2つの母数のどちらにもよらない。次の式を μ について解く。
P(−tn−1(α/2)≤T≤tn−1(α/2))=1−α
すると区間
[Xˉ−tn−1(α/2)nS, Xˉ+tn−1(α/2)nS].(8.4)
を得る。母標準偏差を標本の値で置き換えた代償として、分位点が zα/2 から t 分布の分位点へ大きくなる。たとえば n=9 では t8(0.025)=2.306 で、1.960 より大きい。
正規母集団の分散。
Q=(n−1)S2/σ2∼χn−12 は σ2 について狭義減少である。次の式を σ2 について解く。
P(χn−12(1−α/2)≤Q≤χn−12(α/2))=1−α
すると区間
[χn−12(α/2)(n−1)S2, χn−12(1−α/2)(n−1)S2].(8.5)
を得る。分母の大きい分位点が下端に来る。χ2 分布は左右対称でないので、この区間は S2 を中心に対称でない。
2標本:平均の差と分散の比。
2つの標本が互いに独立で、次に従うとする。
X1,…,Xm∼N(μ1,σ12),Y1,…,Yn∼N(μ2,σ22)
それぞれの不偏分散を S12,S22 とする。等分散 σ12=σ22=σ2 を仮定し、併合分散を次で定める。
Sp2=m+n−2(m−1)S12+(n−1)S22
χ2 の再生性から (m+n−2)Sp2/σ2∼χm+n−22 である。これは次の平均の差と独立である。
Xˉ−Yˉ∼N(μ1−μ2, σ2(1/m+1/n))
よって
T=Sp1/m+1/n(Xˉ−Yˉ)−(μ1−μ2)∼tm+n−2
が枢軸量になり、平均の差 μ1−μ2 の区間は次になる。
Xˉ−Yˉ±tm+n−2(α/2)Sp1/m+1/n
分散の比については、χ2 の比の定義から
F=S22/σ22S12/σ12∼Fm−1,n−1
が枢軸量で、F は σ12/σ22 について狭義減少である。分位点の関係
Fm,n(1−α)=Fn,m(α)1
を使うと
σ22σ12∈[Fm−1,n−1(α/2)S12/S22, S22S12Fn−1,m−1(α/2)].(8.6)
下側の分位点の関係は、F∼Fm,n なら 1/F∼Fn,m であることから次のように書き直して得られる。
P(F≤Fm,n(1−α))=α⟺P(1/F≥1/Fm,n(1−α))=α
指数分布とガンマ分布。
X1,…,Xn を Ex(λ) からの標本とする。密度は正の範囲で λe−λx である。積率母関数を順に計算する。
E[etλXi]E[et⋅2λXi]=∫0∞λe−(λ−tλ)xdx=(1−t)−1(t<1)=(1−2t)−1=(1−2t)−2/2(λXi∼Ex(1))(χ22 の積率母関数)
独立な和をとれば積率母関数は積になるので
2λi=1∑nXi∼χ2n2(8.7)
が成り立ち、これが λ の枢軸量になる。母数について狭義増加なので、
λ∈[2∑Xiχ2n2(1−α/2), 2∑Xiχ2n2(α/2)],μ=λ1∈[χ2n2(α/2)2∑Xi, χ2n2(1−α/2)2∑Xi]
を得る。平均 μ=1/λ の区間は、λ の区間の端点の逆数をとって並べ替えたものである。母数の単調な変換に対して、信頼区間は端点を写すだけで変換できる(被覆の事象が同じだから)。
一様分布。
Xi∼U(0,θ) とし、最大値を M=maxXi とおく。0≤t≤1 で次が成り立つ。
P(M/θ≤t)=P(X1≤tθ)n=tn
である。よって M/θ の分布は母数によらない。密度は ntn−1 で、ベータ分布 Beta(n,1) にあたる。M/θ≤1 が常に成り立つので、上端を 1 にとる。
P(α1/n≤M/θ≤1)=1−α⟹θ∈[M, Mα−1/n]
この形が同じ枢軸量から作れる区間の中で最短であることは確認テスト 8.3-3 で示す。
例題 8.2 指数分布の平均の正確な区間と近似区間 ★★★
オリジナルある部品の寿命が Ex(λ) に従うとする。10 個を試験して寿命の合計 ∑xi=23.5 を得た。
- 式 (8.7) を用いて、平均寿命 μ=1/λ の 95% 信頼区間を求めよ。
- 平均の最尤推定量 μ^=Xˉ の漸近正規性 n(μ^−μ)→N(0,μ2) を使う。近似 95% 区間 μ^±z0.025μ^/n を求め、(1) と比べよ。
解答
(1) 2∑xi=47 である。自由度 2n=20 の分位点は次の2つである。
χ202(0.025)=34.170,χ202(0.975)=9.591
よって
μ∈[34.17047, 9.59147]=[1.375, 4.901].
(2) 計算は次のとおり。
μ^半幅近似区間=2.35,μ^/10=0.7431,=1.960×0.7431=1.457,=[0.893, 3.807].
漸近分散 μ2 は、Fisher 情報量 I(μ)=1/μ2 の逆数である。密度を平均で書くと μ−1e−x/μ になる。
比べると、(1) の区間は点推定値 2.35 より右に長く伸びている(左に 0.975、右に 2.551)。合計 ∑Xi の分布は右に裾の長いガンマ分布である。大きな平均でも小さな合計が出ることはそれなりに起きるので、上側をより遠くまで残す必要がある。
(2) は分布を正規で近似したために対称になり、n=10 では下端・上端とも (1) から大きくずれる。正確な枢軸量があるときは、そちらで区間を作るほうがよい。
検定の反転による方法
枢軸量が見つからないときにも使える一般的な方法が、検定と信頼区間の双対性である。
定理 8.4(検定の反転 ★★★)
各 θ0∈Θ について、帰無仮説 H0:θ=θ0 の検定を考える。有意水準は α とする。その受容域を A(θ0) とする。つまり Pθ0(X∈A(θ0))≥1−α である。
- (i) C(x)={θ0: x∈A(θ0)} とおくと、これは信頼係数 1−α 以上の信頼集合である。
- (ii) 逆に信頼係数 1−α の信頼集合 C(X) があれば、次の集合を受容域とする検定は有意水準を満たす。
A(θ0)={x: θ0∈C(x)}
証明
定義から、すべての θ0 と標本の値について次の同値が成り立つ。
θ0∈C(x)⟺x∈A(θ0)
真の値を θ とすると、Pθ(θ∈C(X))=Pθ(X∈A(θ))≥1−α である。後半も同じ同値関係を逆向きに読めばよい。
信頼区間は「データを見て、そのデータで棄却されない θ0 を全部集めたもの」である。たとえば正規平均の t 検定は、次のとき H0:μ=μ0 を受容する。
∣sn(xˉ−μ0)∣≤tn−1(α/2)
受容される μ0 の集合は、区間 (8.4) にそのまま一致する。第7章で作った検定は、すべてこの手続きで信頼区間に読み替えることができる。
二項分布の正確な区間(Clopper–Pearson)。
X∼Bin(n,p) で x を観測したとする。H0:p=p0 を両側の各裾 α/2 で検定し、次のとき棄却する。
Pp0(X≥x)≤α/2またはPp0(X≤x)≤α/2
反転すると、区間の両端は次の方程式の解になる。
- 下端 pL:方程式 PpL(X≥x)=α/2 の解。ただし x=0 なら下端は 0 とする。
- 上端 pU:方程式 PpU(X≤x)=α/2 の解。ただし x=n なら上端は 1 とする。
この方程式は次の補題でベータ分布の分位点に書き換えられる。
補題 8.5(二項分布の裾とベータ分布)
1≤x≤n について
Pp(X≥x)=k=x∑n(kn)pk(1−p)n−k=(x−1)!(n−x)!n!∫0ptx−1(1−t)n−xdt,
すなわち左辺の裾確率は、Beta(x,n−x+1) の分布関数の p における値に等しい。
証明
左辺を G(p) とおく。x≥1 なので G(0)=0 で、右辺も 0 である。両辺を p で微分して一致を示せばよい。
dpd(kn)pk(1−p)n−k=n(k−1n−1)pk−1(1−p)n−k−n(kn−1)pk(1−p)n−k−1
ここで2つの恒等式 k(kn)=n(k−1n−1) と (n−k)(kn)=n(kn−1) を使った。k=n のとき第2項は 0 である。次のようにおく。
ak=n(k−1n−1)pk−1(1−p)n−k
すると第2項は ak+1 なので、k=x,…,n で和をとると隣り合う項が打ち消し合う。
G′(p)=ax−an+1=ax=(x−1)!(n−x)!n!px−1(1−p)n−x(an+1=0)
これは右辺の微分に等しい。
補題から両端は次のベータ分布の分位点になる。
- 下端は Beta(x,n−x+1) の下側 α/2 点である。
- 上端は Beta(x+1,n−x) の上側 α/2 点である。Pp(X≤x)=1−Pp(X≥x+1) に補題を使えばよい。
X が離散なので被覆確率はちょうど 1−α にはならず、それ以上になる(保守的な区間)。
漸近正規性による方法
正確な分布が求まらないときは、第5章の中心極限定理と第6章の最尤推定量の漸近正規性を使う。正則条件のもとで
n(θ^ML−θ) d N(0, 1/I(θ))(8.8)
であった。Fisher 情報量 I が連続で最尤推定量が一致推定量なら、I(θ^ML)→I(θ)(確率収束)である。Slutsky の定理から次が成り立つ。
nI(θ^ML)(θ^ML−θ) d N(0,1)
これを近似的な枢軸量として使うと、
θ^ML±nI(θ^ML)zα/2(8.9)
が漸近的に信頼係数 1−α の区間になる。これを Wald 型の区間と呼ぶ。
漸近的な区間には作り方の自由度が残る。
スコア型の区間は、I(θ) を推定値で置き換えずに母数のまま残し、次の不等式を θ について解いて作る。
∣nI(θ)(θ^−θ)∣≤zα/2
また、分散が母数によらなくなる変換 g を先に施す方法もある。デルタ法(第5章)から
n(g(θ^)−g(θ)) d N(0,g′(θ)2/I(θ))
なので、
g′(θ)=I(θ)(8.10)
を満たす g を選ぶと漸近分散が 1 になる。これを分散安定化変換と呼ぶ。変換後の区間 g(θ^)±zα/2/n を作り、逆変換で戻せばよい。代表例は次の2つである。
- ポアソン分布:I(λ)=1/λ なので g(λ)=2λ。
- 二項分布の成功確率:I(p)=1/{p(1−p)} なので g(p)=2arcsinp。微分すると
dpd2arcsinp=p(1−p)1
となり、条件 (8.10) を満たす。
二項分布の3つの区間
X∼Bin(n,p) とし、p^=X/n, I(p)=1/{p(1−p)} とする。z=zα/2 と略記する。
- Wald 型:p^±zp^(1−p^)/n。
- スコア型(Wilson の区間):不等式 (p^−p)2≤z2p(1−p)/n を p について解く。
スコア型の不等式を整理すると、次の2次不等式になる。
(1+z2/n)p2−(2p^+z2/n)p+p^2≤0
判別式の4分の1は z2p^(1−p^)/n+z4/(4n2) なので、
p∈1+z2/np^+2nz2±znp^(1−p^)+4n2z2
を得る。n=40, x=12(p^=0.3)の 95% 区間は次のとおりである。
- Wald 型:[0.158, 0.442]
- Wilson:[0.181, 0.454]
- Clopper–Pearson:[0.166, 0.465]
Wilson の区間の中心 (p^+z2/(2n))/(1+z2/n) は、点推定値を 1/2 の側へ寄せた位置にある。
図 8.2 は n=20 での被覆確率を p の関数として描いたものである。Wald 型は、成功確率が 0 や 1 に近いと被覆確率が 0.95 を大きく下回る。p^ が 0 に近いと推定した分散 p^(1−p^)/n が小さくなり、区間が短くなりすぎるためである。
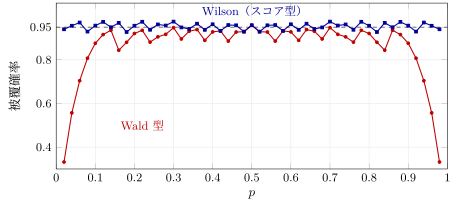
図 8.2 n=20 の二項分布で、名目 95% の Wald 型区間(赤)と Wilson の区間(青)の正確な被覆確率∑x1{p∈C(x)}(x20)px(1−p)20−x を p=0.02,0.04,…,0.98 で計算したもの。破線は 0.95。
極限分布が正規でない場合。
最尤推定量が漸近正規にならない非正則な模型でも、適切に基準化した統計量の極限分布が θ によらないなら、それを近似的な枢軸量に使える。典型は分布の台の端が母数で決まる模型である。最小値(または最大値)が 1/n の速さで母数に近づき、n(minXi−θ) が指数分布に収束する。次の例題でこの手続きを最後まで走らせる。
例題 8.3 台の端が母数の模型:最小値の極限分布から作る区間 ★★★
オリジナルZ1,…,Zn を N(0,1) からの無作為標本とする。観測するのは Xi=θ+∣Zi∣ である。Xi の密度は次のとおりである。
f(x;θ)=2/πe−(x−θ)2/2(x>θ)
M=miniXi とおく。
- θ の最尤推定量が M であることを示せ。
- M−θ の分布関数を、標準正規分布の分布関数 Φ を用いて表せ。
- Tn=n(M−θ) が、標本の大きさを増やすと指数分布 Ex(2/π) に分布収束することを示せ。
- (3) を使って θ の近似 95% 信頼区間を作れ。n=50, M=3.05 のときの区間を求めよ。また、その区間の正確な被覆確率を (2) から求めよ。
解答
(1) 尤度は次のとおりである。
L(θ)=(2/π)n/2exp{−21∑(xi−θ)2}1{θ<minxi}
場合を分けて調べる。
- θ<minxi の範囲:dθdlogL=∑(xi−θ)>0 なので、尤度は狭義増加である。
- θ≥minxi の範囲:尤度は 0 になる。
よって上限は θ↑minxi で達成され、最尤推定量は M である。密度を x≥θ で定義しておけば、最大値として達成される。尤度が最大になる点が微分の零点でなく台の端にあるので、第6章の正則条件は満たされない。
(2) s>0 について P(X1−θ>s)=P(∣Z1∣>s)=2{1−Φ(s)}。独立性から
P(M−θ>s)=i=1∏nP(Xi−θ>s)=[2{1−Φ(s)}]n,P(M−θ≤s)=1−[2{1−Φ(s)}]n.
(3) t>0 を固定する。ϕ(0)=1/2π として、s→0 で次の展開が成り立つ。
Φ(s)2{1−Φ(t/n)}=21+ϕ(0)s+o(s),=1−2ϕ(0)t/n+o(1/n)(s=t/n を入れた)
(1−c/n+o(1/n))n→e−c から
P(Tn>t)=[1−n2ϕ(0)t+o(1/n)]n → e−2ϕ(0)t=e−2/πt.
これは Ex(2/π) の生存関数であり、極限分布は θ によらない。
(4) Tn>0 は常に成り立つので、片側に区間を置く。極限分布で次を満たす c を求める。
P(Tn≤c)c≈1−e−2/πc=0.95,=π/2log20=1.2533×2.9957=3.755.
0<n(M−θ)≤c を θ について解くと
θ∈[M−nc, M).
n=50, M=3.05 なら c/n=0.0751 である。区間は [2.975, 3.05) になる。
正確な被覆確率は、(2) で s=c/n=0.0751 として
1−[2{1−Φ(0.0751)}]50=0.954
で、名目の 0.95 にほぼ一致している。(2) の正確な分布で 0.95 ちょうどになる c を数値的に解くと 3.648 になる。
確認テスト
オリジナル
- 8.2-1 N(μ,σ2) からの大きさ 9 の標本で xˉ=4.8, s2=1.44 を得た(母数はともに未知)。μ と σ2 のそれぞれの 95% 信頼区間を求めよ。
- 8.2-2 U(0,θ) からの大きさ 5 の標本で最大値 M=3.2 を得た。区間 [M, Mα−1/n] の信頼係数が 1−α であることを確かめよ。また α=0.05 の区間を求めよ。
- 8.2-3 Po(λ) からの大きさ 30 の標本で ∑xi=72 を得た。(a) Wald 型 Xˉ±z0.025Xˉ/n と、(b) 分散安定化変換 g(λ)=2λ を使った区間を求めよ。(b) で n(2Xˉ−2λ) の漸近分散が 1 になることも示せ。
- 8.2-4 X1,…,Xn を Ga(k,β) からの標本とし、形状は既知の正の整数、尺度は未知とする。2∑Xi/β∼χ2nk2 を積率母関数で示し、尺度の信頼係数 1−α の区間を作れ。k=2, n=5, ∑xi=18 のときの 95% 区間を求めよ。
- 8.2-5 独立な2つの正規標本で、m=11, s12=6.0, n=16, s22=2.5 を得た。σ12/σ22 の 95% 信頼区間を求めよ。この区間から、等分散の仮説「σ12=σ22」が有意水準 5% の両側 F 検定で棄却されるかを判定せよ。
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com
