tecktom.com

最尤推定値の計算法

2026年10月15日24分で読めますAI生成教科書『資格試験』第11章 計算統計学の方法
目次
  1. Newton–Raphson 法
  2. Fisher のスコア法
  3. EM アルゴリズム
  4. 収束の速さと欠測情報
  5. 有限混合分布
  6. 確認テスト
  7. 木下の層

AI 生成・木下が未勉強

数理統計 第11章 §11.3 ★★ 尤度方程式を反復で解く。Newton 法は2次収束だが初期値に敏感、EM アルゴリズムは尤度を単調に増やすが1次収束。どちらも更新式の導出が小問になる

Newton–Raphson 法

対数尤度 ℓ(θ)\ell(\theta)(1母数)の最大点を、尤度方程式 ℓ′(θ)=0\ell'(\theta)=0 の解として求める。現在の値 θk\theta_k のまわりで ℓ′\ell' を1次まで Taylor 展開すると

ℓ′(θ)≈ℓ′(θk)+ℓ′′(θk)(θ−θk)\ell'(\theta)\approx\ell'(\theta_k)+\ell''(\theta_k)(\theta-\theta_k)

である。右辺を 0 とおいて解いた点を次の値にする。

θk+1=θk−ℓ′(θk)ℓ′′(θk).(11.12)\theta_{k+1}=\theta_k-\frac{\ell'(\theta_k)}{\ell''(\theta_k)} .\tag{11.12}

これを Newton–Raphson 法(Newton 法)と呼ぶ。ℓ\ell を θk\theta_k のまわりで2次式で近似し、その2次式の最大点へ移る、と言い換えることもできる。ℓ′′(θk)<0\ell''(\theta_k)<0 ならその2次式は上に凸で、移る先は最大点である。ℓ′′(θk)>0\ell''(\theta_k)>0 のところでは2次式が下に凸になり、Newton 法は極小点へ向かう。

母数がベクトル θ∈Rp\bm\theta\in\mathbb{R}^p のときは、次の2つを使う。

s(θ)=∂ℓ∂θ  (スコアベクトル),J(θ)=−∂2ℓ∂θ∂θ⊤  (観測情報行列)\bm s(\bm\theta)=\frac{\partial\ell}{\partial\bm\theta}\ \ (\text{スコアベクトル}),\qquad J(\bm\theta)=-\frac{\partial^2\ell}{\partial\bm\theta\partial\bm\theta^\top}\ \ (\text{観測情報行列})

更新式は

θk+1=θk+J(θk)−1s(θk)(11.13)\bm\theta_{k+1}=\bm\theta_k+J(\bm\theta_k)^{-1}\bm s(\bm\theta_k)\tag{11.13}

とする。J(θ^)−1J(\hat{\bm\theta})^{-1} は最尤推定量の漸近分散の推定にもなる(第6章)ので、収束したときに標準誤差も同時に得られる。

定理 11.13(Newton 法の2次収束 ★★)

ψ=ℓ′\psi=\ell' とおく。ψ\psi は θ^\hat\theta の近くで2回連続微分可能で、次を満たすとする。

ψ(θ^)=0,ψ′(θ^)≠0\psi(\hat\theta)=0,\qquad \psi'(\hat\theta)\ne0

このとき、θ^\hat\theta の十分近くから始めた Newton 法は θ^\hat\theta に収束する。誤差 ek=θk−θ^e_k=\theta_k-\hat\theta は

ek+1=ψ′′(ξk)2ψ′(θk) ek2(ξk は θk と θ^ の間の点)(11.14)e_{k+1}=\frac{\psi''(\xi_k)}{2\psi'(\theta_k)}\,e_k^2\qquad(\xi_k\text{ は }\theta_k\text{ と }\hat\theta\text{ の間の点})\tag{11.14}

を満たす。特に ek+1/ek2→ψ′′(θ^)/{2ψ′(θ^)}e_{k+1}/e_k^2\to\psi''(\hat\theta)/\{2\psi'(\hat\theta)\} で、正しい桁数が1回ごとにほぼ2倍になる。

証明

ψ\psi を θk\theta_k のまわりで、2次の剰余つきで展開する。θ^\hat\theta で評価すると次を得る。

0=ψ(θ^)=ψ(θk)+ψ′(θk)(θ^−θk)+12ψ′′(ξk)(θ^−θk)20=\psi(\hat\theta)=\psi(\theta_k)+\psi'(\theta_k)(\hat\theta-\theta_k)+\frac12\psi''(\xi_k)(\hat\theta-\theta_k)^2

両辺を ψ′(θk)\psi'(\theta_k) で割り、Newton の式 (11.12) の θk+1=θk−ψ(θk)/ψ′(θk)\theta_{k+1}=\theta_k-\psi(\theta_k)/\psi'(\theta_k) を使うと

0=ψ(θk)ψ′(θk)−ek+ψ′′(ξk)2ψ′(θk)ek2=(θk−θk+1)−ek+ψ′′(ξk)2ψ′(θk)ek2=−ek+1+ψ′′(ξk)2ψ′(θk)ek20=\frac{\psi(\theta_k)}{\psi'(\theta_k)}-e_k+\frac{\psi''(\xi_k)}{2\psi'(\theta_k)}e_k^2=(\theta_k-\theta_{k+1})-e_k+\frac{\psi''(\xi_k)}{2\psi'(\theta_k)}e_k^2 =-e_{k+1}+\frac{\psi''(\xi_k)}{2\psi'(\theta_k)}e_k^2

となり (11.14) を得る。

次に収束を示す。θ^\hat\theta の近くの区間 II をとり、その上で次が成り立つとする。

∣ψ′′∣≤A,∣ψ′∣≥B>0,C=A2B\lvert \psi''\rvert \le A,\qquad\lvert \psi'\rvert \ge B>0,\qquad C=\frac A{2B}

θk∈I\theta_k\in I かつ C∣ek∣<1C\lvert e_k\rvert <1 とする。このとき

∣ek+1∣≤C∣ek∣2<∣ek∣\lvert e_{k+1}\rvert \le C\lvert e_k\rvert ^2<\lvert e_k\rvert

なので、θk+1\theta_{k+1} も II に入る。帰納的に

C∣ek∣≤(C∣e0∣)2k→0C\lvert e_k\rvert \le(C\lvert e_0\rvert )^{2^k}\to0

となる。極限の比は ξk→θ^\xi_k\to\hat\theta、θk→θ^\theta_k\to\hat\theta と連続性から従う。

定理は「十分近くから始めれば」という条件つきである。初期値が遠いと、ℓ′′>0\ell''>0 の領域に入って極小点へ向かったり、発散したりする(確認テスト 11.3-5)。実際には、モーメント推定量のような一致推定量を初期値に使う。n\sqrt n 一致推定量(n(θ~−θ)\sqrt n(\tilde\theta-\theta) が確率有界になる推定量)から Newton 法を1回だけ行った推定量(ワンステップ推定量)は、最尤推定量と同じ漸近分布を持つことが知られている。

Fisher のスコア法

Newton 法の −ℓ′′(θk)-\ell''(\theta_k)(観測情報量)を、その期待値である Fisher 情報量 In(θk)=nI(θk)I_n(\theta_k)=nI(\theta_k) に置き換えたもの

θk+1=θk+ℓ′(θk)In(θk)(11.15)\theta_{k+1}=\theta_k+\frac{\ell'(\theta_k)}{I_n(\theta_k)}\tag{11.15}

を Fisher のスコア法と呼ぶ。In(θ)>0I_n(\theta)>0 なので、ℓ′′\ell'' の符号で向きが反転することがなく、Newton 法より安定する。

収束の速さは一般に1次に落ちる。しかし −ℓ′′(θ^)/n-\ell''(\hat\theta)/n と I(θ^)I(\hat\theta) の差は、標本が大きいと小さい。そのため実際の反復回数はあまり変わらない。

自然母数で書いた指数型分布族 f(x∣θ)=h(x)exp⁡{θT(x)−A(θ)}f(x\mid\theta)=h(x)\exp\{\theta T(x)-A(\theta)\} では、ℓ′′(θ)=−nA′′(θ)\ell''(\theta)=-nA''(\theta) がデータによらないので、観測情報量とFisher 情報量が一致し、スコア法と Newton 法は同じ反復になる(確認テスト 11.3-1)。第9章のロジスティック回帰の最尤推定でスコア法を使うと、各反復が重み付き最小2乗法の形になる。これを反復重み付き最小2乗法(IRLS)と呼ぶ。

例題 11.4 0 を除いた Poisson 分布の最尤推定値を Newton 法で求める ★★

オリジナル0 が観測されない Poisson 分布(ゼロ切断 Poisson 分布)

P(X=x)=e−λλxx! (1−e−λ)(x=1,2,… )P(X=x)=\frac{\mathrm{e}^{-\lambda}\lambda^x}{x!\,(1-\mathrm{e}^{-\lambda})}\qquad(x=1,2,\dots)

から nn 個の観測を得て、標本平均が xˉ\bar x だったとする。

  1. 尤度方程式が λ/(1−e−λ)=xˉ\lambda/(1-\mathrm{e}^{-\lambda})=\bar x になることを示せ。
  2. Newton 法の更新式を書け。
  3. n=50n=50、xˉ=2\bar x=2 とする。初期値 λ0=xˉ=2\lambda_0=\bar x=2 から3回反復した値を小数第4位まで求め、収束の様子を述べよ。
解答

(1) 対数尤度は、λ\lambda によらない項を除いて

ℓ(λ)=nxˉlog⁡λ−nλ−nlog⁡(1−e−λ)\ell(\lambda)=n\bar x\log\lambda-n\lambda-n\log(1-\mathrm{e}^{-\lambda})

である。微分すると

ℓ′(λ)=nxˉλ−n−ne−λ1−e−λ=nxˉλ−n1−e−λ\ell'(\lambda)=\frac{n\bar x}{\lambda}-n-\frac{n\mathrm{e}^{-\lambda}}{1-\mathrm{e}^{-\lambda}}=\frac{n\bar x}\lambda-\frac{n}{1-\mathrm{e}^{-\lambda}}

(1+e−λ/(1−e−λ)=1/(1−e−λ)1+\mathrm{e}^{-\lambda}/(1-\mathrm{e}^{-\lambda})=1/(1-\mathrm{e}^{-\lambda}) を使った)。ℓ′(λ)=0\ell'(\lambda)=0 を整理すると xˉ=λ/(1−e−λ)\bar x=\lambda/(1-\mathrm{e}^{-\lambda}) である。右辺はゼロ切断 Poisson 分布の平均 E[X]E[X] なので、最尤推定量はモーメント推定量と一致する。この方程式は λ\lambda について解けない。

(2) 2階微分は

ℓ′′(λ)=−nxˉλ2+ne−λ(1−e−λ)2\ell''(\lambda)=-\frac{n\bar x}{\lambda^2}+\frac{n\mathrm{e}^{-\lambda}}{(1-\mathrm{e}^{-\lambda})^2}

(ddλ(1−e−λ)−1=−e−λ(1−e−λ)−2\frac{\mathrm{d}}{\mathrm{d}\lambda}(1-\mathrm{e}^{-\lambda})^{-1}=-\mathrm{e}^{-\lambda}(1-\mathrm{e}^{-\lambda})^{-2} に負号が付く)。Newton 法は

λk+1=λk−ℓ′(λk)ℓ′′(λk)=λk−xˉ/λk−1/(1−e−λk)−xˉ/λk2+e−λk/(1−e−λk)2\lambda_{k+1}=\lambda_k-\frac{\ell'(\lambda_k)}{\ell''(\lambda_k)} =\lambda_k-\frac{\bar x/\lambda_k-1/(1-\mathrm{e}^{-\lambda_k})}{-\bar x/\lambda_k^2+\mathrm{e}^{-\lambda_k}/(1-\mathrm{e}^{-\lambda_k})^2}

で、nn は約分されて消える。

(3) λ0=2\lambda_0=2 とする。e−2=0.13534\mathrm{e}^{-2}=0.13534、1−e−2=0.864661-\mathrm{e}^{-2}=0.86466 である。これを使うと

ℓ′(λ0)/n=1−1.15652=−0.15652,ℓ′′(λ0)/n=−0.5+0.13534/0.74764=−0.31898,λ1=2−0.15652/0.31898=1.5093\begin{aligned}\ell'(\lambda_0)/n&=1-1.15652=-0.15652,\\ \ell''(\lambda_0)/n&=-0.5+0.13534/0.74764=-0.31898,\\ \lambda_1&=2-0.15652/0.31898=1.5093\end{aligned}

となる。同じ計算を続けると

λ1=1.5093,λ2=1.5897,λ3=1.5936,\lambda_1=1.5093,\qquad\lambda_2=1.5897,\qquad\lambda_3=1.5936,

で、λ4\lambda_4 以降は小数第4位まで 1.59361.5936 のまま変わらない。真の解 λ^=1.593624…\hat\lambda=1.593624\ldots との誤差は0.406, 0.084, 0.0039, 8×10−60.406,\ 0.084,\ 0.0039,\ 8\times10^{-6} と減り、1回ごとにほぼ2乗になっている(定理 11.13)。ℓ′′(λ^)/n≈−0.4675\ell''(\hat\lambda)/n\approx-0.4675 より、標準誤差の推定は 1/50×0.4675≈0.2071/\sqrt{50\times0.4675}\approx0.207 である。

EM アルゴリズム

観測データ y\bm y だけでは尤度が複雑でも、観測されなかったデータ z\bm z があれば尤度が簡単になる、という場合がある。典型的な例は次の3つである。

  • 打ち切りのある寿命データ:打ち切られた個体の本当の寿命が z\bm z。
  • 混合分布:各観測がどの成分から来たかのラベルが z\bm z。
  • いくつかのセルがまとめて観測された多項分布:まとめられる前の内訳が z\bm z。

(y,z)(\bm y,\bm z) を完全データと呼び、その密度を fc(y,z∣θ)f_c(\bm y,\bm z\mid\theta) と書く。完全データの対数尤度を ℓc(θ)=log⁡fc(y,z∣θ)\ell_c(\theta)=\log f_c(\bm y,\bm z\mid\theta) と書く。観測データの尤度と対数尤度は

L(θ)=∫fc(y,z∣θ) dz,ℓ(θ)=log⁡L(θ)L(\theta)=\int f_c(\bm y,\bm z\mid\theta)\,\mathrm{d}\bm z,\qquad \ell(\theta)=\log L(\theta)

である。

定義 11.14(EM アルゴリズム)

初期値 θ0\theta_0 から、k=0,1,2,…k=0,1,2,\dots について次の2段を繰り返す。

  1. E ステップ:観測データと現在の値 θk\theta_k のもとでの z\bm z の条件付き分布で、完全データの対数尤度の期待値をとる。

Q(θ∣θk)=Eθk[ℓc(θ)∣y]=∫log⁡fc(y,z∣θ)  k(z∣y,θk) dz.(11.16)Q(\theta\mid\theta_k)=E_{\theta_k}\bigl[\ell_c(\theta)\bigm|\bm y\bigr]=\int\log f_c(\bm y,\bm z\mid\theta)\;k(\bm z\mid\bm y,\theta_k)\,\mathrm{d}\bm z .\tag{11.16}

ここで k(z∣y,θ)=fc(y,z∣θ)/L(θ)k(\bm z\mid\bm y,\theta)=f_c(\bm y,\bm z\mid\theta)/L(\theta) は、観測データを与えたときの欠測部分の条件付き密度である。2. M ステップ:Q(θ∣θk)Q(\theta\mid\theta_k) を最大化する点を、次の値 θk+1\theta_{k+1} とする。

名前は Expectation(期待値)と Maximization(最大化)の頭文字である(Dempster–Laird–Rubin が一般の形にまとめた)。完全データの分布が、指数型分布族

exp⁡{θ⊤T(y,z)−A(θ)}\exp\{\theta^\top T(\bm y,\bm z)-A(\theta)\}

の形だとする。このとき ℓc\ell_c は十分統計量 TT について1次式なので、計算は次のように簡単になる。

  • E ステップは、TT の条件付き期待値 Tk=Eθk[T∣y]T_k=E_{\theta_k}[T\mid\bm y] を計算するだけでよい。
  • M ステップは、完全データの最尤推定量の式の TT に TkT_k を入れるだけになる。

定理 11.15(EM アルゴリズムは尤度を減らさない ★★)

EM アルゴリズムの列は ℓ(θk+1)≥ℓ(θk)\ell(\theta_{k+1})\ge\ell(\theta_k) を満たす。

証明

まず次の分解から始める。

fc(y,z∣θ)=L(θ) k(z∣y,θ)f_c(\bm y,\bm z\mid\theta)=L(\theta)\,k(\bm z\mid\bm y,\theta)

この対数をとり、両辺を k(z∣y,θk)k(\bm z\mid\bm y,\theta_k) で積分する。ℓ(θ)\ell(\theta) は z\bm z によらないので

ℓ(θ)=Q(θ∣θk)−H(θ∣θk),H(θ∣θk)=∫log⁡k(z∣y,θ)  k(z∣y,θk) dz(11.17)\ell(\theta)=Q(\theta\mid\theta_k)-H(\theta\mid\theta_k),\qquad H(\theta\mid\theta_k)=\int\log k(\bm z\mid\bm y,\theta)\;k(\bm z\mid\bm y,\theta_k)\,\mathrm{d}\bm z\tag{11.17}

を得る。HH について、Jensen の不等式(log⁡\log は凹)から

H(θ∣θk)−H(θk∣θk)=∫log⁡k(z∣y,θ)k(z∣y,θk) k(z∣y,θk) dz≤log⁡∫k(z∣y,θ) dz=log⁡1=0H(\theta\mid\theta_k)-H(\theta_k\mid\theta_k)=\int\log\frac{k(\bm z\mid\bm y,\theta)}{k(\bm z\mid\bm y,\theta_k)}\,k(\bm z\mid\bm y,\theta_k)\,\mathrm{d}\bm z \le\log\int k(\bm z\mid\bm y,\theta)\,\mathrm{d}\bm z=\log1=0

である(左辺は Kullback–Leibler 情報量に負号を付けたもの)。したがって

ℓ(θk+1)−ℓ(θk)={Q(θk+1∣θk)−Q(θk∣θk)}−{H(θk+1∣θk)−H(θk∣θk)}≥0.\ell(\theta_{k+1})-\ell(\theta_k)=\bigl\{Q(\theta_{k+1}\mid\theta_k)-Q(\theta_k\mid\theta_k)\bigr\}-\bigl\{H(\theta_{k+1}\mid\theta_k)-H(\theta_k\mid\theta_k)\bigr\}\ge0 .

第1の括弧は M ステップの定義から 0 以上、第2の括弧は今示したとおり 0 以下である。

証明からわかるとおり、M ステップで QQ を最大化しきらなくても単調性は保たれる。Q(θk+1∣θk)≥Q(θk∣θk)Q(\theta_{k+1}\mid\theta_k)\ge Q(\theta_k\mid\theta_k) となる θk+1\theta_{k+1} を選べばよい(一般化 EM)。

また (11.17) を θ\theta で微分すると、次が分かる。H(⋅∣θk)H(\cdot\mid\theta_k) は θ=θk\theta=\theta_k で最大なので、

ℓ′(θk)=∂Q(θ∣θk)∂θ∣θ=θk\ell'(\theta_k)=\frac{\partial Q(\theta\mid\theta_k)}{\partial\theta}\Bigr|_{\theta=\theta_k}

である。

EM の不動点 θ∗\theta^\ast をとる。つまり θk=θ∗\theta_k=\theta^\ast なら θk+1=θ∗\theta_{k+1}=\theta^\ast となる点である。

これが Q(⋅∣θ∗)Q(\cdot\mid\theta^\ast) の内点の最大点なら、そこで ∂Q/∂θ=0\partial Q/\partial\theta=0 である。すなわち ℓ′(θ∗)=0\ell'(\theta^\ast)=0 となり、不動点は尤度方程式の解である。

ただし単調性が保証するのは尤度が増え続けることだけで、大域的な最大点への収束は保証されない。尤度に複数の山がある混合分布では、初期値を変えて何回か走らせる。

例題 11.5 打ち切りのある指数分布の EM アルゴリズム ★★

オリジナルnn 個の部品の寿命が独立に Ex(λ)\mathrm{Ex}(\lambda) に従う。そのうち rr 個は、時刻 tit_i で故障が観測された。残りの n−rn-r 個は、時刻 cic_i で観測が打ち切られた。打ち切られた個体については、寿命が cic_i より長いことだけが分かる。

観測された時間の合計を T=∑故障ti+∑打ち切りciT=\sum_{\text{故障}}t_i+\sum_{\text{打ち切り}}c_i とする。

  1. 観測データの対数尤度を書き、最尤推定量が λ^=r/T\hat\lambda=r/T であることを示せ。
  2. 打ち切られた個体の本当の寿命を欠測データとして、E ステップと M ステップを書き、EM の更新式が λk+1=n/{T+(n−r)/λk}\lambda_{k+1}=n/\{T+(n-r)/\lambda_k\} になることを示せ。
  3. 更新式の不動点が λ^\hat\lambda であることを示せ。また、その近くで誤差が

λk+1−λ^≈n−rn(λk−λ^)\lambda_{k+1}-\hat\lambda\approx\frac{n-r}{n}(\lambda_k-\hat\lambda)

と1次で減ることを示せ。4. (n,r,T)=(10,6,30)(n,r,T)=(10,6,30)、初期値 λ0=1\lambda_0=1 とする。λ1,λ2,λ3\lambda_1,\lambda_2,\lambda_3 を求めよ。

解答

(1) 故障した個体の寄与は密度 λe−λti\lambda\mathrm{e}^{-\lambda t_i}、打ち切られた個体の寄与は生存確率 P(X>ci)=e−λciP(X>c_i)=\mathrm{e}^{-\lambda c_i} なので

L(λ)=∏故障λe−λti∏打ち切りe−λci=λre−λT,ℓ(λ)=rlog⁡λ−λT.L(\lambda)=\prod_{\text{故障}}\lambda\mathrm{e}^{-\lambda t_i}\prod_{\text{打ち切り}}\mathrm{e}^{-\lambda c_i}=\lambda^r\mathrm{e}^{-\lambda T},\qquad \ell(\lambda)=r\log\lambda-\lambda T .

ℓ′(λ)=r/λ−T=0\ell'(\lambda)=r/\lambda-T=0 から λ^=r/T\hat\lambda=r/T を得る。ℓ′′=−r/λ2<0\ell''=-r/\lambda^2<0 なので、これは最大点である。

(2) 打ち切られた個体の本当の寿命を ziz_i とすると、完全データの対数尤度は

ℓc(λ)=nlog⁡λ−λ(∑故障ti+∑zi)\ell_c(\lambda)=n\log\lambda-\lambda\Bigl(\sum_{\text{故障}}t_i+\sum z_i\Bigr)

である。E ステップでは ziz_i の条件付き期待値が要る。X>ciX>c_i を与えたときの超過分 X−ciX-c_i は、無記憶性から元と同じ指数分布に従う。よって

Eλk[zi∣zi>ci]=ci+1λkE_{\lambda_k}[z_i\mid z_i>c_i]=c_i+\frac1{\lambda_k}

である。したがって

Q(λ∣λk)=nlog⁡λ−λ{∑故障ti+∑打ち切り(ci+1λk)}=nlog⁡λ−λ(T+n−rλk).Q(\lambda\mid\lambda_k)=n\log\lambda-\lambda\Bigl\{\sum_{\text{故障}}t_i+\sum_{\text{打ち切り}}\Bigl(c_i+\frac1{\lambda_k}\Bigr)\Bigr\}=n\log\lambda-\lambda\Bigl(T+\frac{n-r}{\lambda_k}\Bigr).

M ステップでは ∂Q/∂λ=n/λ−(T+(n−r)/λk)=0\partial Q/\partial\lambda=n/\lambda-(T+(n-r)/\lambda_k)=0 を解いて

λk+1=nT+(n−r)/λk\lambda_{k+1}=\frac{n}{T+(n-r)/\lambda_k}

を得る。完全データの最尤推定量「個数÷総時間」の総時間に、打ち切られた個体の残り寿命の期待値 1/λk1/\lambda_k を足したものになっている。

(3) 更新式を λk+1=g(λk)\lambda_{k+1}=g(\lambda_k)、g(λ)=nλ/(λT+n−r)g(\lambda)=n\lambda/(\lambda T+n-r) と書く。不動点の方程式 λ=g(λ)\lambda=g(\lambda) を整理すると λT+n−r=n\lambda T+n-r=n となる。その解は λ=r/T=λ^\lambda=r/T=\hat\lambda である。

微分は g′(λ)=n(n−r)/(λT+n−r)2g'(\lambda)=n(n-r)/(\lambda T+n-r)^2 である。λ=λ^\lambda=\hat\lambda では分母が (r+n−r)2=n2(r+n-r)^2=n^2 になるので、

g′(λ^)=n−rng'(\hat\lambda)=\frac{n-r}{n}

である。λk+1−λ^=g(λk)−g(λ^)≈g′(λ^)(λk−λ^)\lambda_{k+1}-\hat\lambda=g(\lambda_k)-g(\hat\lambda)\approx g'(\hat\lambda)(\lambda_k-\hat\lambda) より、誤差は1回ごとに約 (n−r)/n(n-r)/n 倍になる。欠測の割合が大きいほど収束が遅い。

(4) T=30T=30、n−r=4n-r=4 なので、更新式は次のようになる。

λk+1=1030+4/λk\lambda_{k+1}=\frac{10}{30+4/\lambda_k}

順に代入すると

λ1=1034=0.2941,λ2=1030+13.6=0.2294,λ3=1030+17.44=0.2108.\lambda_1=\frac{10}{34}=0.2941,\qquad \lambda_2=\frac{10}{30+13.6}=0.2294,\qquad \lambda_3=\frac{10}{30+17.44}=0.2108 .

λ^=6/30=0.2\hat\lambda=6/30=0.2 との誤差は、順に 0.094, 0.029, 0.011 である。隣り合う誤差の比はおよそ 0.31, 0.37 で、g′(λ^)=0.4g'(\hat\lambda)=0.4 に近づいていく。

収束の速さと欠測情報

例題 11.5 の収束率 (n−r)/n(n-r)/n は、一般の EM アルゴリズムの性質の特別な場合である。(11.17) を2回微分して θ^\hat\theta で評価する。次の2つの情報量を定める。

Ic=−∂2Q(θ∣θ^)∂θ2∣θ^ (完全データの情報量),Im=−∂2H(θ∣θ^)∂θ2∣θ^ (欠測データの情報量)I_c=-\frac{\partial^2Q(\theta\mid\hat\theta)}{\partial\theta^2}\Bigr|_{\hat\theta}\ (\text{完全データの情報量}),\qquad I_m=-\frac{\partial^2H(\theta\mid\hat\theta)}{\partial\theta^2}\Bigr|_{\hat\theta}\ (\text{欠測データの情報量})

観測データの情報量は、その差 −ℓ′′(θ^)=Ic−Im-\ell''(\hat\theta)=I_c-I_m になる。EM の収束率(更新の写像の θ^\hat\theta での微分)は

g′(θ^)=ImIc=1−−ℓ′′(θ^)Ic(11.18)g'(\hat\theta)=\frac{I_m}{I_c}=1-\frac{-\ell''(\hat\theta)}{I_c}\tag{11.18}

で、完全データの情報のうち欠測で失われた割合に等しい。例題では Ic=n/λ^2I_c=n/\hat\lambda^2、−ℓ′′(λ^)=r/λ^2-\ell''(\hat\lambda)=r/\hat\lambda^2 である。よって g′=1−r/n=(n−r)/ng'=1-r/n=(n-r)/n となり、(3) と一致する。

図

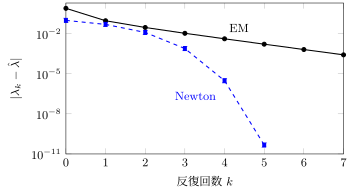
図 11.2 例題 11.5 の打ち切りデータ(λ^=0.2\hat\lambda=0.2)で、EM(実線、λ0=1\lambda_0=1)と Newton 法(破線、λ0=0.3\lambda_0=0.3)の誤差を対数目盛で比べた。EM の誤差は直線的(毎回約 0.40.4 倍)に減り、Newton 法の誤差は折れ曲がって急に減る(毎回ほぼ2乗)。Newton 法の更新式と初期値の条件は確認テスト 11.3-2 で導く

図 11.2 のとおり、EM は1次収束で Newton 法より遅いが、尤度を減らさないので初期値が遠くても破綻しない。Newton 法は2次収束だが、この例では初期値 λ0=1\lambda_0=1 から始めると最初の1回で負の値に飛んで発散する。実務では、EM で解の近くまで進めてから Newton 法に切り替えることもある。また EM では ℓ′′\ell'' が計算されないので、最尤推定量の標準誤差は収束後に別途 (11.18) の関係などを使って求める必要がある。

有限混合分布

EM アルゴリズムが最もよく使われる場面は混合分布である。密度が

f(x∣θ)=π ϕ(x;μ1,σ12)+(1−π) ϕ(x;μ2,σ22)f(x\mid\bm\theta)=\pi\,\phi(x;\mu_1,\sigma_1^2)+(1-\pi)\,\phi(x;\mu_2,\sigma_2^2)

の2成分の正規混合を考える(ϕ(⋅;μ,σ2)\phi(\cdot;\mu,\sigma^2) は正規密度)。対数尤度 ∑ilog⁡f(xi∣θ)\sum_i\log f(x_i\mid\bm\theta) では対数の中に和があるので、尤度方程式は解けない。各観測が成分1から来たかどうかを表すラベル zi∈{0,1}z_i\in\{0,1\}(成分1なら 1)を欠測データとすると、完全データの対数尤度は

ℓc=∑i=1n[zi{log⁡π+log⁡ϕ(xi;μ1,σ12)}+(1−zi){log⁡(1−π)+log⁡ϕ(xi;μ2,σ22)}]\ell_c=\sum_{i=1}^n\Bigl[z_i\{\log\pi+\log\phi(x_i;\mu_1,\sigma_1^2)\}+(1-z_i)\{\log(1-\pi)+\log\phi(x_i;\mu_2,\sigma_2^2)\}\Bigr]

で、ziz_i について1次式である。E ステップでは ziz_i をその条件付き期待値(Bayes の定理による事後確率)

wi(k)=Eθk[zi∣xi]=πkϕ(xi;μ1,k,σ1,k2)πkϕ(xi;μ1,k,σ1,k2)+(1−πk)ϕ(xi;μ2,k,σ2,k2)(11.19)w_i^{(k)}=E_{\bm\theta_k}[z_i\mid x_i]=\frac{\pi_k\phi(x_i;\mu_{1,k},\sigma_{1,k}^2)}{\pi_k\phi(x_i;\mu_{1,k},\sigma_{1,k}^2)+(1-\pi_k)\phi(x_i;\mu_{2,k},\sigma_{2,k}^2)}\tag{11.19}

で置き換える。M ステップは、wi(k)w_i^{(k)} を重みとした重み付きの最尤推定で

πk+1=1n∑iwi(k),μ1,k+1=∑iwi(k)xi∑iwi(k),σ1,k+12=∑iwi(k)(xi−μ1,k+1)2∑iwi(k)\pi_{k+1}=\frac1n\sum_iw_i^{(k)},\qquad \mu_{1,k+1}=\frac{\sum_iw_i^{(k)}x_i}{\sum_iw_i^{(k)}},\qquad \sigma_{1,k+1}^2=\frac{\sum_iw_i^{(k)}(x_i-\mu_{1,k+1})^2}{\sum_iw_i^{(k)}}

となる(成分2は wi(k)w_i^{(k)} を 1−wi(k)1-w_i^{(k)} に替える)。導出は確認テスト 11.3-4 で行う。

なお、2つの分散を別々に推定する正規混合では、大域的な最大点は存在しない。μ1=xi\mu_1=x_i として σ1→0\sigma_1\to0 とすると、尤度が無限大に発散するからである。EM で求めるのは尤度方程式の解のうち、分散が 0 に退化していない局所的な最大点である。

確認テスト

オリジナル

  1. 11.3-1 自然母数の1母数指数型分布族

f(x∣θ)=h(x)exp⁡{θT(x)−A(θ)}f(x\mid\theta)=h(x)\exp\{\theta T(x)-A(\theta)\}

から nn 個の観測を得る。観測情報量 −ℓ′′(θ)-\ell''(\theta) が Fisher 情報量 In(θ)I_n(\theta) に一致することを示せ。したがって Newton 法とスコア法が同じ反復になることを説明せよ。2. 11.3-2 例題 11.5 の対数尤度 ℓ(λ)=rlog⁡λ−λT\ell(\lambda)=r\log\lambda-\lambda T に Newton 法を使う。更新式が λk+1=2λk−λk2T/r\lambda_{k+1}=2\lambda_k-\lambda_k^2T/r になることを示せ。誤差 ek=λk−λ^e_k=\lambda_k-\hat\lambda が ek+1=−(T/r)ek2e_{k+1}=-(T/r)e_k^2 を厳密に満たすことを示せ。0<λ0<2λ^0<\lambda_0<2\hat\lambda のとき、かつそのときに限り λ^\hat\lambda に収束することを示せ。3. 11.3-3 4つのセルの多項分布を考える。セルの確率は

(12+θ4, 1−θ4, 1−θ4, θ4)(0<θ<1)\Bigl(\frac12+\frac\theta4,\ \frac{1-\theta}4,\ \frac{1-\theta}4,\ \frac\theta4\Bigr)\qquad(0<\theta<1)

で、観測度数は (y1,y2,y3,y4)=(80,25,21,24)(y_1,y_2,y_3,y_4)=(80,25,21,24) とする。第1セルを確率 12\frac12 の部分と θ4\frac\theta4 の部分に分けた内訳を欠測データとして、EM の更新式を導け。θ0=0.5\theta_0=0.5 から θ1\theta_1 を求めよ。また、尤度方程式を2次方程式に直して最尤推定値を求めよ。4. 11.3-4 2成分の正規混合で、両成分の分散が 1 と既知、未知母数が (π,μ1,μ2)(\pi,\mu_1,\mu_2) であるとする。M ステップの更新式

πk+1=1n∑wi(k),μ1,k+1=∑wi(k)xi∑wi(k)\pi_{k+1}=\frac1n\sum w_i^{(k)},\qquad \mu_{1,k+1}=\frac{\sum w_i^{(k)}x_i}{\sum w_i^{(k)}}

を QQ の最大化から導け。5. 11.3-5 位置母数の Cauchy 分布 f(x∣θ)={π(1+(x−θ)2)}−1f(x\mid\theta)=\{\pi(1+(x-\theta)^2)\}^{-1} から1個の観測 x=0x=0 を得た。Newton 法の更新式が

θk+1=−2θk31−θk2\theta_{k+1}=-\frac{2\theta_k^3}{1-\theta_k^2}

になることを示せ。さらに次を示せ。

  • ∣θ0∣<1/3\lvert \theta_0\rvert <1/\sqrt3 なら θ^=0\hat\theta=0 に収束する。
  • ∣θ0∣>1/3\lvert \theta_0\rvert >1/\sqrt3(∣θ0∣≠1\lvert \theta_0\rvert \ne1)なら収束しない。

木下の勉強ステータス

木下はまだこの記事を勉強していません。

AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com

← AI生成教科書『資格試験』の記事一覧へ