相対エントロピーから情報と物理を組み立てる 第1部 第3章 §1.3.4 ★★★ 結合分布と「独立だと仮定した分布」の D D D
独立だと仮定した分布と比べる
2つの確率変数の関係を測るには、実際の結合分布 p X Y p_{XY} p X Y X X X Y Y Y p X p Y p_Xp_Y p X p Y p X ( x ) p Y ( y ) p_X(x)p_Y(y) p X ( x ) p Y ( y )
定義 1.3.6(相互情報量)
I ( X ; Y ) ≔ D ( p X Y ∥ p X p Y ) = ∑ x , y p X Y ( x , y ) ln p X Y ( x , y ) p X ( x ) p Y ( y ) (1.3.13) I(X;Y)\coloneqq D(p_{XY}\,\|\,p_Xp_Y)=\sum_{x,y}p_{XY}(x,y)\ln\frac{p_{XY}(x,y)}{p_X(x)p_Y(y)}\tag{1.3.13} I ( X ; Y ) : = D ( p X Y ∥ p X p Y ) = x , y ∑ p X Y ( x , y ) ln p X ( x ) p Y ( y ) p X Y ( x , y ) ( 1.3.13 )
を X X X Y Y Y 相互情報量 と呼ぶ。
p X Y ( x , y ) > 0 p_{XY}(x,y)>0 p X Y ( x , y ) > 0 p X ( x ) > 0 p_X(x)>0 p X ( x ) > 0 p Y ( y ) > 0 p_Y(y)>0 p Y ( y ) > 0 I ( X ; Y ) I(X;Y) I ( X ; Y ) p X Y / ( p X p Y ) = p X ∣ Y / p X p_{XY}/(p_Xp_Y)=p_{X|Y}/p_X p X Y / ( p X p Y ) = p X ∣ Y / p X
I ( X ; Y ) = H ( X ) − H ( X ∣ Y ) = H ( Y ) − H ( Y ∣ X ) = H ( X ) + H ( Y ) − H ( X , Y ) . (1.3.14) I(X;Y)=H(X)-H(X\,|\,Y)=H(Y)-H(Y\,|\,X)=H(X)+H(Y)-H(X,Y) .\tag{1.3.14} I ( X ; Y ) = H ( X ) − H ( X ∣ Y ) = H ( Y ) − H ( Y ∣ X ) = H ( X ) + H ( Y ) − H ( X , Y ) . ( 1.3.14 )
1つ目の等号は、ln ( p X ∣ Y ( x ∣ y ) / p X ( x ) ) = − ln p X ( x ) − ( − ln p X ∣ Y ( x ∣ y ) ) \ln\bigl(p_{X|Y}(x\,|\,y)/p_X(x)\bigr)=-\ln p_X(x)-\bigl(-\ln p_{X|Y}(x\,|\,y)\bigr) ln ( p X ∣ Y ( x ∣ y ) / p X ( x ) ) = − ln p X ( x ) − ( − ln p X ∣ Y ( x ∣ y ) ) Y Y Y X X X Y Y Y Y Y Y X X X (1.3.13) は X , Y X,Y X , Y Y Y Y X X X X X X Y Y Y (1.3.12) を代入したものである。Y = X Y=X Y = X H ( X ∣ X ) = 0 H(X\,|\,X)=0 H ( X ∣ X ) = 0 I ( X ; X ) = H ( X ) I(X;X)=H(X) I ( X ; X ) = H ( X )
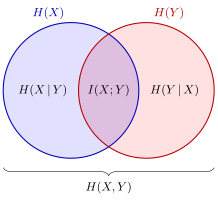
図 1.3.3 は、式 (1.3.12) と (1.3.14) の関係を面積で表したものである。2つの円全体が H ( X , Y ) H(X,Y) H ( X , Y ) H ( X ) H(X) H ( X ) H ( Y ) H(Y) H ( Y ) I ( X ; Y ) I(X;Y) I ( X ; Y )
図 1.3.3 2変数のエントロピーと相互情報量の関係。左の円が H ( X ) H(X) H ( X ) H ( Y ) H(Y) H ( Y ) H ( X , Y ) H(X,Y) H ( X , Y ) I ( X ; Y ) I(X;Y) I ( X ; Y ) (1.3.12) ・(1.3.14) の加減がこの面積の関係と同じ形をしている。
非負性から出てくる2つの不等式
I ( X ; Y ) I(X;Y) I ( X ; Y ) I ( X ; Y ) ≥ 0 I(X;Y)\ge0 I ( X ; Y ) ≥ 0 p X Y = p X p Y p_{XY}=p_Xp_Y p X Y = p X p Y X X X Y Y Y (1.3.14) の形に読み替えると、2つの不等式になる。
H ( X ∣ Y ) ≤ H ( X ) , H ( X , Y ) ≤ H ( X ) + H ( Y ) . (1.3.15) H(X\,|\,Y)\le H(X),\qquad H(X,Y)\le H(X)+H(Y) .\tag{1.3.15} H ( X ∣ Y ) ≤ H ( X ) , H ( X , Y ) ≤ H ( X ) + H ( Y ) . ( 1.3.15 )
1つ目は「条件を付けると、平均のエントロピーは増えない」、2つ目は「結合エントロピーは和を超えない」(劣加法性 )である。どちらも等号は独立のときに限る。劣加法性は、量子情報に移ると von Neumann エントロピーの劣加法性になり、そのさらに強い形(強劣加法性)が量子データ処理不等式と同じ内容になる。これは 第3部第3章 で扱う。
減るのは平均だけ
式 (1.3.15) の H ( X ∣ Y ) H(X\,|\,Y) H ( X ∣ Y ) y y y y y y H ( X ∣ Y = y ) H(X\,|\,Y=y) H ( X ∣ Y = y ) H ( X ) H(X) H ( X ) 1.3.3 の分布では H ( X ) = h b ( 1 / 4 ) ≈ 0.562 H(X)=h_{\mathrm b}(1/4)\approx0.562 H ( X ) = h b ( 1/4 ) ≈ 0.562 Y = 1 Y=1 Y = 1 X X X H ( X ∣ Y = 1 ) = ln 2 ≈ 0.693 H(X\,|\,Y=1)=\ln2\approx0.693 H ( X ∣ Y = 1 ) = ln 2 ≈ 0.693 Y = 0 Y=0 Y = 0 X X X 1 2 ln 2 ≈ 0.347 \frac12\ln2\approx0.347 2 1 ln 2 ≈ 0.347 I ( X ; Y ) = H ( X ) − H ( X ∣ Y ) = h b ( 1 / 4 ) − 1 2 ln 2 ≈ 0.216 I(X;Y)=H(X)-H(X\,|\,Y)=h_{\mathrm b}(1/4)-\frac12\ln2\approx0.216 I ( X ; Y ) = H ( X ) − H ( X ∣ Y ) = h b ( 1/4 ) − 2 1 ln 2 ≈ 0.216
条件付き相互情報量と連鎖律
3つ目の確率変数 Z Z Z Z = z Z=z Z = z X X X Y Y Y z z z
I ( X ; Y ∣ Z ) ≔ H ( X ∣ Z ) − H ( X ∣ Y , Z ) = ∑ z p Z ( z ) D ( p X Y ∣ Z ( ⋅ , ⋅ ∣ z ) ∥ p X ∣ Z ( ⋅ ∣ z ) p Y ∣ Z ( ⋅ ∣ z ) ) (1.3.16) I(X;Y\,|\,Z)\coloneqq H(X\,|\,Z)-H(X\,|\,Y,Z)=\sum_zp_Z(z)\,D\bigl(p_{XY|Z}(\cdot,\cdot\,|\,z)\,\big\|\,p_{X|Z}(\cdot\,|\,z)\,p_{Y|Z}(\cdot\,|\,z)\bigr)\tag{1.3.16} I ( X ; Y ∣ Z ) : = H ( X ∣ Z ) − H ( X ∣ Y , Z ) = z ∑ p Z ( z ) D ( p X Y ∣ Z ( ⋅ , ⋅ ∣ z ) p X ∣ Z ( ⋅ ∣ z ) p Y ∣ Z ( ⋅ ∣ z ) ) ( 1.3.16 )
を条件付き相互情報量 と呼ぶ。右辺は D D D I ( X ; Y ∣ Z ) ≥ 0 I(X;Y\,|\,Z)\ge0 I ( X ; Y ∣ Z ) ≥ 0 Z Z Z X X X Y Y Y X X X Y Y Y Z Z Z H ( X ) − H ( X ∣ Y , Z ) H(X)-H(X\,|\,Y,Z) H ( X ) − H ( X ∣ Y , Z ) H ( X ) − H ( X ∣ Y ) H(X)-H(X\,|\,Y) H ( X ) − H ( X ∣ Y ) H ( X ∣ Y ) − H ( X ∣ Y , Z ) H(X\,|\,Y)-H(X\,|\,Y,Z) H ( X ∣ Y ) − H ( X ∣ Y , Z ) 相互情報量の連鎖律
I ( X ; Y , Z ) = I ( X ; Y ) + I ( X ; Z ∣ Y ) (1.3.17) I(X;Y,Z)=I(X;Y)+I(X;Z\,|\,Y)\tag{1.3.17} I ( X ; Y , Z ) = I ( X ; Y ) + I ( X ; Z ∣ Y ) ( 1.3.17 )
を得る。Y Y Y Z Z Z X X X Y Y Y Y Y Y Z Z Z I ( X ; Z ∣ Y ) = 0 I(X;Z\,|\,Y)=0 I ( X ; Z ∣ Y ) = 0 X → Y → Z X\to Y\to Z X → Y → Z
例題 1.3.4 2値対称通信路の相互情報量 ★★★
オリジナル 送信者が X ∈ { 0 , 1 } X\in\{0,1\} X ∈ { 0 , 1 } 1 / 2 1/2 1/2 Y Y Y 1 − ε 1-\varepsilon 1 − ε X X X ε \varepsilon ε 0 < ε < 1 / 2 0<\varepsilon <1/2 0 < ε < 1/2
(1) p Y p_Y p Y H ( Y ∣ X ) H(Y\,|\,X) H ( Y ∣ X ) I ( X ; Y ) = ln 2 − h b ( ε ) I(X;Y)=\ln2-h_{\mathrm b}(\varepsilon ) I ( X ; Y ) = ln 2 − h b ( ε ) (2) ε = 0.1 \varepsilon =0.1 ε = 0.1 I ( X ; Y ) I(X;Y) I ( X ; Y ) (3) 同じ値を、定義 (1.3.13) の D ( p X Y ∥ p X p Y ) D(p_{XY}\,\|\,p_Xp_Y) D ( p X Y ∥ p X p Y )
解答 (1) p Y ( 1 ) = 1 2 ε + 1 2 ( 1 − ε ) = 1 2 p_Y(1)=\frac12\varepsilon +\frac12(1-\varepsilon )=\frac12 p Y ( 1 ) = 2 1 ε + 2 1 ( 1 − ε ) = 2 1 p Y p_Y p Y H ( Y ) = ln 2 H(Y)=\ln2 H ( Y ) = ln 2 X = x X=x X = x Y Y Y ( 1 − ε , ε ) (1-\varepsilon ,\varepsilon ) ( 1 − ε , ε ) H ( Y ∣ X = x ) = h b ( ε ) H(Y\,|\,X=x)=h_{\mathrm b}(\varepsilon ) H ( Y ∣ X = x ) = h b ( ε ) x x x H ( Y ∣ X ) = h b ( ε ) H(Y\,|\,X)=h_{\mathrm b}(\varepsilon ) H ( Y ∣ X ) = h b ( ε ) (1.3.14) の2つ目の形から I ( X ; Y ) = H ( Y ) − H ( Y ∣ X ) = ln 2 − h b ( ε ) I(X;Y)=H(Y)-H(Y\,|\,X)=\ln2-h_{\mathrm b}(\varepsilon ) I ( X ; Y ) = H ( Y ) − H ( Y ∣ X ) = ln 2 − h b ( ε )
(2) h b ( 0.1 ) = − 0.1 ln 0.1 − 0.9 ln 0.9 ≈ 0.3251 h_{\mathrm b}(0.1)=-0.1\ln0.1-0.9\ln0.9\approx0.3251 h b ( 0.1 ) = − 0.1 ln 0.1 − 0.9 ln 0.9 ≈ 0.3251 I ( X ; Y ) ≈ 0.6931 − 0.3251 = 0.3681 I(X;Y)\approx0.6931-0.3251=0.3681 I ( X ; Y ) ≈ 0.6931 − 0.3251 = 0.3681 ln 2 \ln2 ln 2 0.531 0.531 0.531 1.1.3 で数値だけ先に出した値である。1ビットを送っても、受け手に伝わる情報は平均で約 0.53 0.53 0.53
(3) p X Y ( x , y ) p_{XY}(x,y) p X Y ( x , y ) x = y x=y x = y ( 1 − ε ) / 2 (1-\varepsilon )/2 ( 1 − ε ) /2 x ≠ y x\ne y x = y ε / 2 \varepsilon /2 ε /2 p X ( x ) p Y ( y ) = 1 / 4 p_X(x)p_Y(y)=1/4 p X ( x ) p Y ( y ) = 1/4
D ( p X Y ∥ p X p Y ) = 2 ⋅ 1 − ε 2 ln ( 2 ( 1 − ε ) ) + 2 ⋅ ε 2 ln ( 2 ε ) = ln 2 + ( 1 − ε ) ln ( 1 − ε ) + ε ln ε = ln 2 − h b ( ε ) D(p_{XY}\,\|\,p_Xp_Y)=2\cdot\frac{1-\varepsilon }{2}\ln\bigl(2(1-\varepsilon )\bigr)+2\cdot\frac{\varepsilon }{2}\ln(2\varepsilon )=\ln2+(1-\varepsilon )\ln(1-\varepsilon )+\varepsilon \ln\varepsilon =\ln2-h_{\mathrm b}(\varepsilon ) D ( p X Y ∥ p X p Y ) = 2 ⋅ 2 1 − ε ln ( 2 ( 1 − ε ) ) + 2 ⋅ 2 ε ln ( 2 ε ) = ln 2 + ( 1 − ε ) ln ( 1 − ε ) + ε ln ε = ln 2 − h b ( ε )
で、(1) と一致する。
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com