相対エントロピーから情報と物理を組み立てる 第1部 第7章 §1.7.4 ★★ 最尤推定は経験分布との D を最小にする推定で、観測が多いとき Cramér–Rao の下限に達する
最尤推定は D の最小化
観測値 x1,…,xn が得られたとき、対数尤度
ℓn(θ):=i=1∑nlnp(xi;θ)(1.7.14)
を最大にする θ を最尤推定量 θ^ML と呼ぶ。観測値の経験分布を p^n(x)=n1#{i:xi=x} とすると、序章の式 (1.1.13) により n1ℓn(θ)=−H(p^n)−D(p^n∥pθ) で、H(p^n) は θ によらない。したがって最尤推定は、経験分布 p^n から相対エントロピーで測って最も近い族の元 pθ を選ぶことである。n→∞ では大数の法則により p^n が真の分布 pθ0 に近づき、D(pθ0∥pθ) は θ=θ0 でだけ 0 になるので、θ^ML は真の値 θ0 に近づく(一致性)。
漸近正規性
θ^ML が θ0 に近いとして、最大の条件 ℓn′(θ^ML)=0 を θ0 のまわりで1次まで展開すると
0=ℓn′(θ0)+ℓn′′(θ0)(θ^ML−θ0)+⋯,n(θ^ML−θ0)≈−ℓn′′(θ0)/nℓn′(θ0)/n
となる。分子はスコアの独立な n 個の和を n で割ったもので、各項は平均 0・分散 J(θ0) なので、中心極限定理によって分散 J(θ0) の正規分布に近づく。分母は大数の法則によって −⟨∂θsθ⟩=J(θ0) に近づく。合わせて
n(θ^ML−θ0) 分布 N(0, J(θ0)1)(1.7.15)
を得る。分散 1/(nJ) は Cramér–Rao の下限そのものである。有限の n では最尤推定量に偏りが残ることがあるが、偏りは O(1/n) で、標準偏差 O(1/n) より速く消える。最尤推定が「n が大きいとき下限に達する」というこの性質を漸近有効性と呼ぶ。この節の議論は 1/n→0 の極限での主要項だけを残したもので、剰余が本当に小さいことの証明には正則条件の第二(3回微分の一様な有界性)と一致性が要る。
近似の裏付け
型 B(極限) | 小さいもの 1/n→0(観測の回数が多い) | 証明 条件付き(Cramér の正則条件:台が θ によらない・3階微分が可積分な関数で一様に押さえられる・0<J<∞・識別可能) | 行き先 近似の数理 第1章
下限を下回る推定量
式 (1.7.15) は「漸近分散が 1/J より小さい推定量は無い」とは言っていない。J. L. Hodges は、標本平均を0 の近くでだけ 0 に丸める推定量が、θ=0 の1点で漸近分散 0 を持ち、それ以外では標本平均と同じ漸近分散を持つことを示した(L. Le Cam (1953), Univ. California Publ. Statist. 1, 277–330 に収録)。このような推定量は、下限を下回る点の近くの θ では成績が悪い。「正規近似の分散が 1/J を下回る点は、測度 0 の集合に限られる」という形で下限を言い直したのが Le Cam の定理である。
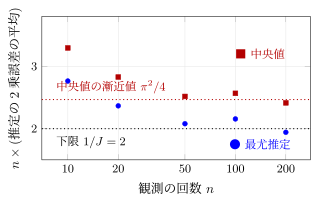
図 1.7.2 Cauchy 分布の位置パラメータを、標本の中央値と最尤推定で推定したときの2乗誤差の平均に n を掛けたもの(各 n で4000回の乱数実験。verify_ch1-07.py が出した値)。点線は厳密な漸近値で、最尤推定は Cramér–Rao の下限 1/J=2 に、中央値は π2/4≈2.47 に近づく。
例題 1.7.4 Cauchy 分布の位置:平均は使えず、中央値より最尤が良い ★★
オリジナルX が位置 θ の Cauchy 分布 p(x;θ)=π(1+(x−θ)2)1 に従う。
- J(θ)=21 を示せ。
- 標本の中央値 θ~n の漸近分散は、密度 p の中央での値を使って 1/(4np(θ;θ)2) で与えられる。これを求め、Cramér–Rao の下限との比(漸近効率)を求めよ。
- 標本平均が θ の推定に使えない理由を述べよ。
解答
(1) u=x−θ とおくと sθ=1+u22u なので
J=∫−∞∞(1+u2)24u2π(1+u2)du=π4∫−∞∞(1+u2)3u2du=π4⋅8π=21
である(u=tanφ と置くと ∫u2(1+u2)−3du=∫−π/2π/2sin2φcos2φdφ=π/8)。
(2) p(θ;θ)=1/π なので漸近分散は π2/(4n)≈2.47/n である。下限は 1/(nJ)=2/n なので、漸近効率は (2/n)/(π2/(4n))=8/π2≈0.811。中央値は下限の約8割の効率で、最尤推定(漸近分散 2/n)より誤差が大きい。図 1.7.2 の乱数実験はこの2つの値に近づいている。
(3) Cauchy 分布は平均を持たない(∫∣x∣pdx が発散する)。n 個の標本平均はもとと同じ Cauchy 分布に従い、n を増やしても広がりが縮まない。分散が有限という Cramér–Rao の前提を満たさない推定量なので、下限と比べる対象にならない。
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com
