数理統計 第4章 §4.2 ★★★ 条件付き期待値と全分散の公式、密度の因数分解による独立性の判定。階層モデルの計算と十分統計量(第6章)の前提
条件付き確率関数と条件付き密度
離散型では、P(X=x)>0 のとき事象の条件付き確率をそのまま使い、
p(y∣x)=P(Y=y∣X=x)=pX(x)p(x,y)
を X=x が与えられたときの Y の条件付き確率関数と呼ぶ。連続型では P(X=x)=0 なので割り算をそのまま使うことはできない。そこで、x から幅 h の区間で条件を付けてから、幅を0に近づける。f が連続なら
P(Y≤y∣x<X≤x+h)=∫xx+hfX(s)ds∫xx+h∫−∞yf(s,t)dtds ⟶ fX(x)∫−∞yf(x,t)dt(h→0)
となる(分子と分母を h で割り、積分の平均値の極限をとった)。右辺を y で微分したものを密度として採用する。
定義 4.6(条件付き密度)
fX(x)>0 となる x について
f(y∣x)=fX(x)f(x,y)(4.7)
を、X=x が与えられたときの Y の条件付き密度と呼ぶ。y の関数として非負で、(4.3) から積分は1である。
(4.7) を書き直すと次の形になる。
f(x,y)=fX(x)f(y∣x)
これは、同時密度を「まず X を引き、その値に応じて Y を引く」という2段の手続きで組み立てる式として読める。階層モデル(次の例題)やベイズ推定(第10章)の事後分布は、この形から出発する。
条件付き期待値・全期待値の法則・全分散の公式
定義 4.7(条件付き期待値)
m(x)=E[Y∣X=x]=∫yf(y∣x)dy
を、X=x が与えられたときの Y の条件付き期待値と呼ぶ。確率変数 X を代入したものを E[Y∣X] と書く。これは X の関数なので確率変数である。同様に
V[Y∣X=x]=E[(Y−m(x))2∣X=x]
を条件付き分散と呼び、X を代入したものを V[Y∣X] と書く。
定理 4.8(全期待値の法則・全分散の公式 ★★★)
期待値と分散が存在するとき、次が成り立つ。
E[Y]V[Y]=E[E[Y∣X]],=E[V[Y∣X]]+V[E[Y∣X]].(4.8)(4.9)
さらに、X の任意の関数 h(X) について次が成り立つ。
E[h(X)Y∣X]=h(X)E[Y∣X]
証明
(4.8) は次の計算で示せる。
E[m(X)]=∫m(x)fX(x)dx=∫∫yf(y∣x)fX(x)dydx=∬yf(x,y)dxdy=E[Y]
後半の性質を示す。X=x を条件とすると h(X)=h(x) は定数なので、次が成り立つ。
E[h(X)Y∣X=x]=∫h(x)yf(y∣x)dy=h(x)m(x)
(4.9):Y−E[Y]={Y−m(X)}+{m(X)−E[Y]} と分けて2乗の期待値をとると
V[Y]=E[{Y−m(X)}2]+E[{m(X)−E[Y]}2]+2E[{Y−m(X)}{m(X)−E[Y]}].
右辺の3つの項を順に見る。
- 第3項は、h(X)=m(X)−E[Y] とおき、(4.8) と後半の性質を使うと0になる。
E[E[{Y−m(X)}h(X)∣X]]=E[h(X){m(X)−m(X)}]=0
2. 第1項は、(4.8) を {Y−m(X)}2 に使うと次になる。
E[E[{Y−m(X)}2∣X]]=E[V[Y∣X]]
3. 第2項は、E[m(X)]=E[Y] なので V[m(X)] である。
全分散の公式 (4.9) の右辺の2つの項は、次のように読める。
- 第1項は「X を固定したあとに残る Y のばらつきの平均」である。
- 第2項は「X が動くことによる Y の平均の動き」である。
分散分析の平方和の分解(第9章・実験計画法)は、この式の標本版である。
同じ分解からもう1つの性質が出る。X の任意の関数 g(X) をとる。上の証明と同じく、Y−g(X) を2つの差に分けて2乗の期待値をとると
E[{Y−g(X)}2]=E[{Y−m(X)}2]+E[{m(X)−g(X)}2] ≥ E[{Y−m(X)}2](4.10)
となる(交差項は同じ理由で0)。すなわち、2乗誤差を最小にする予測の関数は E[Y∣X] である。E[Y∣X=x] を x の関数とみたものを回帰関数と呼ぶ。正確には「Y の X への回帰関数」であり、この名前の理由はここにある。
独立性
定義 4.9(独立)
すべての x,y について次が成り立つとする。
F(x,y)=FX(x)FY(y)
このとき X と Y は独立であるという。n 個の場合は F(x1,…,xn)=∏iFXi(xi) で定める。
密度を持つ場合、この条件は f(x,y)=fX(x)fY(y)(ほとんどすべての点で)と同値である(分布関数を x,y で微分する方向と、密度の積を積分する方向の両方で確かめられる)。このとき f(y∣x)=fY(y) となる。X の値を知っても Y の分布は変わらない。
定理 4.10(因数分解による独立性の判定 ★★★)
同時密度が、指示関数まで含めたすべての (x,y) で次の形に書けるとする。
f(x,y)=g(x)h(y)(g は x だけ、h は y だけの非負関数)
このとき次が成り立つ。
- (i) X と Y は独立である。
- (ii) 周辺密度 fX は g の定数倍である。同様に fY は h の定数倍である。
証明
G=∫g、H=∫h とおく。このとき 1=∬f=GH である。周辺密度とその積は次のとおりである。
fX(x)fX(x)fY(y)=g(x)∫h(y)dy=g(x)H,fY(y)=h(y)G=g(x)h(y)GH=f(x,y)
よって独立である。
台が長方形でなければ独立でない
同時密度 f(x,y)=8xy(0<y<x<1)は、2つの因子の積に見える。しかし台の条件 y<x を指示関数で書くと、次の形になる。
f(x,y)=8xy1{0<y<x<1}
この指示関数 1{y<x} は、片方の変数だけの関数どうしの積には分けられない。実際、X=0.1 を知ると Y<0.1 に限られる。Y の分布は X の値によって変わる。定理 4.10 を使うときは、台が {x∈A}×{y∈B} という直積の形をしているかを必ず先に確かめる。
独立なら、任意の関数 g,h について E[g(X)h(Y)]=E[g(X)]E[h(Y)] が成り立つ(二重積分が積に分かれる)。特に Cov(X,Y)=E[XY]−E[X]E[Y]=0、V[X+Y]=V[X]+V[Y] であり、積率母関数について
MX+Y(t)=E[etXetY]=MX(t)MY(t)(4.11)
が成り立つ。第2章で示した「積率母関数が一致すれば分布が一致する」と組み合わせると、独立な和の分布を、積率母関数の積の形から読み取る方法になる(第3章の再生性)。
逆向きは成り立たない。X∼N(0,1)、Y=X2 とする。E[X3]=0 から
Cov(X,Y)=E[X3]−E[X]E[X2]=0
だが、Y は X の関数として決まっているので独立ではない。無相関は独立より弱い条件である。ただし §4.4 で示すように、(X,Y) が2変量正規分布に従う場合に限っては、無相関と独立が同値になる。
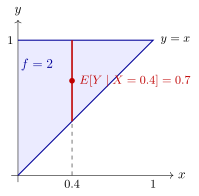
図 4.1 台 {0<x<y<1}(青)上の一様分布。X=0.4 を固定した縦線(赤)が台を横切る区間 (0.4,1) の上で、Y の条件付き分布は一様になる。条件付き期待値はその中点 0.7 である。
例題 4.2 三角形の上の一様分布と全分散の公式 ★★
オリジナル(X,Y) の同時密度を次で定める(図 4.1)。
f(x,y)={20(0<x<y<1)(それ以外)
- 周辺密度 fX(x) と、条件付き密度 f(y∣x) を求めよ。
- E[Y∣X] と V[Y∣X] を求めよ。
- 全期待値の法則と全分散の公式を使って E[Y] と V[Y] を求めよ。それらが、周辺密度 fY から直接求めた値と一致することを確かめよ。
解答
- 0<x<1 を固定すると、縦線が台を横切るのは x<y<1 である。fX(x)=∫x12dy=2(1−x)(0<x<1)。条件付き密度は次のとおりである。
f(y∣x)=2(1−x)2=1−x1(x<y<1)
よって Y∣X=x は区間 (x,1) 上の一様分布である。2. 区間 (x,1) 上の一様分布の平均は中点、分散は長さの2乗の 1/12 である。よって次を得る。
E[Y∣X]=21+X,V[Y∣X]=12(1−X)2
3. まず X の平均と分散を求める。
E[X]V[X]=∫012x(1−x)dx=31,E[X2]=∫012x2(1−x)dx=61=61−91=181
全期待値の法則から E[Y]=E[21+X]=21(1+31)=32。全分散の公式の2つの項は
E[12(1−X)2]=121∫012(1−x)3dx=121⋅21=241,V[21+X]=4V[X]=721
で、V[Y]=241+721=724=181 である。直接求めると次のとおりで、一致する。
fY(y)E[Y]V[Y]=∫0y2dx=2y(0<y<1)=∫012y2dy=32,E[Y2]=∫012y3dy=21=21−94=181
例題 4.3 ポアソン分布の間引き(階層モデル) ★★★
オリジナルある店に1日に来る客の数 N は Po(λ) に従う。各客は他と独立に確率 p で商品を買う。
買った客の数を X とする。N=n が与えられたとき X∼Bin(n,p) である。q=1−p とおく。
- X∼Po(λp) を示せ。
- 全期待値の法則と全分散の公式で E[X] と V[X] を求め、(1) と矛盾しないことを確かめよ。
- 買わなかった客の数 N−X と X が独立であることを示せ。
- λ=10、p=0.3 とする。このとき P(X=0) と Cov(N,X) を求めよ。
解答
- k≥0 を固定し、N=n で場合分けして足し合わせる。和は n≥k の範囲でとる。m=n−k とおくと
P(X=k)=n=k∑∞n!e−λλn(kn)pkqn−k=k!e−λ(λp)km=0∑∞m!(λq)m=k!e−λ(λp)keλq=k!e−λp(λp)k
となり、X∼Po(λp) である。2. E[X∣N]=Np、V[X∣N]=Npq なので、次を得る。
E[X]V[X]=E[Np]=λp=E[Npq]+V[Np]=λpq+p2λ=λp(q+p)=λp
これは Po(λp) の平均と分散に一致する。3. P(X=k,N−X=m)=P(N=k+m)P(X=k∣N=k+m) を計算すると
(k+m)!e−λλk+m⋅k!m!(k+m)!pkqm=k!e−λp(λp)k⋅m!e−λq(λq)m
となる(e−λ=e−λpe−λq を使った)。
同時確率関数は k だけの関数と m だけの関数の積である。台 {0,1,2,…}2 も直積である。よって定理 4.10 の離散版から、X と N−X は独立である。また N−X∼Po(λq) である。4. P(X=0)=e−3=0.0498。N=X+(N−X) と (3) の独立性から、次を得る。
Cov(N,X)=V[X]+Cov(N−X,X)=λp=3
確認テスト
オリジナル
- 4.2-1 次の同時密度のそれぞれについて、X と Y が独立かどうかを理由とともに答えよ。(a) f(x,y)=6xy2(0<x<1, 0<y<1)。(b) f(x,y)=8xy(0<y<x<1)。
- 4.2-2 X∼U(0,1) とし、Y の条件付き分布を次で定める。
Y∣X=x ∼ U(0,x)
全期待値の法則と全分散の公式で E[Y] と V[Y] を求めよ。また Y の周辺密度を求めよ。3. 4.2-3 N を Po(λ) に従う確率変数とする。X1,X2,… は N と独立で、互いに独立同分布とする。その平均を μ、分散を σ2 とする。次の確率変数を考える。
S=i=1∑NXi(N=0 なら S=0)
E[S]=λμ、V[S]=λ(σ2+μ2) を示せ。さらに λ=3、Xi∼Ex(2) のときの値を求めよ。4. 4.2-4 X∼N(0,1)、Y=X2 とする。Cov(X,Y)=0 を確かめよ。次に、次の2つを数値で比べよ。
P(∣X∣≤1, Y≤1),P(∣X∣≤1)P(Y≤1)
これにより、X と Y が独立でないことを示せ。
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com
