tecktom.com

推定量の評価

2026年10月15日24分で読めますAI生成教科書『資格試験』第6章 統計的推定
目次
  1. 不偏性と平均二乗誤差
  2. 一致性
  3. Fisher 情報量
  4. Cramér–Rao の不等式
  5. 最尤推定量の漸近正規性
  6. 確認テスト
  7. 木下の層

AI 生成・木下が未勉強

数理統計 第6章 §6.3 ★★★ 不偏性・平均二乗誤差・一致性、Fisher 情報量と Cramér–Rao の下限、最尤推定量の漸近正規性

推定量 θ^\hat\theta は確率変数なので、その良さは分布で測る。次の3つを順に定義する。

  • 不偏性:分布の中心が真の値にあるか。
  • 平均二乗誤差:真の値の周りにどれだけ集まるか。
  • 一致性:標本を増やせば真の値に近づくか。

不偏性と平均二乗誤差

定義 6.7(不偏推定量・偏り・平均二乗誤差)

すべての θ∈Θ\theta\in\Theta で Eθ[θ^]=θE_\theta[\hat\theta]=\theta が成り立つ推定量を不偏推定量という。b(θ)=Eθ[θ^]−θb(\theta)=E_\theta[\hat\theta]-\theta を偏り(バイアス)、MSEθ(θ^)=Eθ[(θ^−θ)2]\mathrm{MSE}_\theta(\hat\theta)=E_\theta[(\hat\theta-\theta)^2] を平均二乗誤差という。

命題 6.8(平均二乗誤差の分解 ★★★)

MSEθ(θ^)=Vθ[θ^]+b(θ)2.\mathrm{MSE}_\theta(\hat\theta)=V_\theta[\hat\theta]+b(\theta)^2.

証明

m=Eθ[θ^]m=E_\theta[\hat\theta] とおき、θ^−θ=(θ^−m)+(m−θ)\hat\theta-\theta=(\hat\theta-m)+(m-\theta) と分けて2乗の期待値を取る。m−θ=b(θ)m-\theta=b(\theta) は定数で、E[θ^−m]=0E[\hat\theta-m]=0 である。よって交差項 2b(θ)E[θ^−m]2b(\theta)E[\hat\theta-m] は消え、

E[(θ^−θ)2]=E[(θ^−m)2]+b(θ)2E[(\hat\theta-\theta)^2]=E[(\hat\theta-m)^2]+b(\theta)^2

となる。

不偏分散 S2S^2 が σ2\sigma^2 の不偏推定量であることを確かめておく。平方和は

∑(Xi−μ)2=∑(Xi−Xˉ)2+n(Xˉ−μ)2\sum(X_i-\mu)^2=\sum(X_i-\bar X)^2+n(\bar X-\mu)^2

と分かれる(交差項 2(Xˉ−μ)∑(Xi−Xˉ)2(\bar X-\mu)\sum(X_i-\bar X) は 0 になる)。両辺の期待値を取ると

E[∑(Xi−Xˉ)2]=nσ2−n⋅σ2n=(n−1)σ2E\Bigl[\sum(X_i-\bar X)^2\Bigr]=n\sigma^2-n\cdot\frac{\sigma^2}{n}=(n-1)\sigma^2

である。これを n−1n-1 で割ったものが不偏分散なので、E[S2]=σ2E[S^2]=\sigma^2 である。この計算は正規性を使っていない。

不偏であることは、平均二乗誤差が小さいことを保証しない。正規母集団で、平方和を定数 cc で割った推定量

σ^c2=1c∑(Xi−Xˉ)2\hat\sigma^2_c=\frac1c\sum(X_i-\bar X)^2

を比べる。平方和を W=∑(Xi−Xˉ)2W=\sum(X_i-\bar X)^2 とおく。第5章 §5.2 で示したとおり、W/σ2W/\sigma^2 は自由度 n−1n-1 のカイ二乗分布に従う。その平均は n−1n-1、分散は 2(n−1)2(n-1) なので

E[W]=(n−1)σ2,V[W]=2(n−1)σ4E[W]=(n-1)\sigma^2,\qquad V[W]=2(n-1)\sigma^4

である。よって

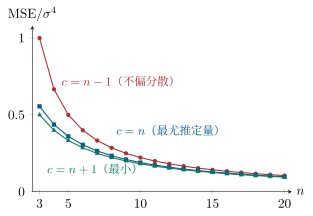
MSE(σ^c2)σ4=2(n−1)c2+(n−1c−1)2.(6.6)\frac{\mathrm{MSE}(\hat\sigma^2_c)}{\sigma^4}=\frac{2(n-1)}{c^2}+\Bigl(\frac{n-1}{c}-1\Bigr)^2.\tag{6.6}

u=1/cu=1/c とおいて右辺を uu で微分すると

4(n−1)u+2(n−1){(n−1)u−1}=2(n−1){(n+1)u−1}4(n-1)u+2(n-1)\{(n-1)u-1\}=2(n-1)\{(n+1)u-1\}

となる。よって u=1/(n+1)u=1/(n+1) のとき最小になる。代表的な3つの cc で値を並べると次のとおりである。

  • c=n+1c=n+1(最小):2(n−1)+4(n+1)2=2n+1\dfrac{2(n-1)+4}{(n+1)^2}=\dfrac{2}{n+1}。
  • c=nc=n(最尤推定量):2n−1n2\dfrac{2n-1}{n^2}。
  • c=n−1c=n-1(不偏分散):2n−1\dfrac{2}{n-1}。

平均二乗誤差では c=n+1c=n+1 が最も小さく、不偏分散が最も大きい(図 6.2)。偏りを少し許すと分散が減り、合計が小さくなる例である。
図

図 6.2 正規母集団で ∑(Xi−Xˉ)2/c\sum(X_i-\bar X)^2/c を σ2\sigma^2 の推定量に使ったときの平均二乗誤差 (6.6)。どの nn でも c=n+1c=n+1 が最小、不偏分散 c=n−1c=n-1 が最大である。

平均二乗誤差の小ささで推定量を選ぶとき、すべての θ\theta で一様に最小となる推定量は一般に存在しない。定数の推定量 θ^≡θ0\hat\theta\equiv\theta_0 は、真の値が θ0\theta_0 のとき誤差 0 である。したがって一様最小な推定量があるとすれば、どの真の値でも誤差 0 でなければならず、不可能である。

そこで推定量の範囲を不偏推定量に絞り、その中で分散が最小のもの(一様最小分散不偏推定量)を探す、という考え方が出てくる。この探索は第10章 §10.2 で Rao–Blackwell・Lehmann–Scheffé の定理として完成する。この章では、不偏推定量の分散がどこまで小さくなりうるかの下限を求める。

一致性

定義 6.9(一致推定量)

推定量の列 θ^n\hat\theta_n が、すべての真の値 θ\theta と、すべての正の数について

lim⁡n→∞Pθ(∣θ^n−θ∣>ε)=0\lim_{n\to\infty}P_\theta(\lvert \hat\theta_n-\theta\rvert >\varepsilon)=0

を満たすとする(真の値に確率収束する)。このとき θ^n\hat\theta_n を一致推定量という。

命題 6.10(平均二乗誤差による十分条件 ★★)

n→∞n\to\infty で MSEθ(θ^n)→0\mathrm{MSE}_\theta(\hat\theta_n)\to0 なら、その推定量の列は一致推定量である。

証明

Markov の不等式を (θ^n−θ)2(\hat\theta_n-\theta)^2 に使うと

P(∣θ^n−θ∣>ε)≤P((θ^n−θ)2≥ε2)≤MSEθ(θ^n)ε2→0.P(\lvert \hat\theta_n-\theta\rvert >\varepsilon)\le P((\hat\theta_n-\theta)^2\ge\varepsilon^2)\le\frac{\mathrm{MSE}_\theta(\hat\theta_n)}{\varepsilon^2}\to0.

命題 6.8 と合わせると、「偏りと分散がともに 0 に収束すれば一致推定量」と読める。一様分布 U(0,θ)\mathrm{U}(0,\theta) の X(n)X_{(n)} は直接確かめることもできる。0<ε<θ0<\varepsilon<\theta について

P(∣X(n)−θ∣>ε)=P(X(n)<θ−ε)=(1−εθ)n→0P(\lvert X_{(n)}-\theta\rvert >\varepsilon)=P(X_{(n)}<\theta-\varepsilon)=\Bigl(1-\frac\varepsilon\theta\Bigr)^n\to0

である。

Fisher 情報量

ここから先は、次の正則条件を仮定する。

  1. (i) 密度が正になる xx の範囲が θ\theta によらない。
  2. (ii) Θ\Theta は開区間で、log⁡f(x;θ)\log f(x;\theta) はパラメータについて2回微分可能である。
  3. (iii) 次のような積分をパラメータで微分するとき、積分と微分の順序を交換できる。

∫f(x;θ) dx,∫T(x)fn(x;θ) dx\int f(x;\theta)\,\mathrm{d} x,\qquad\int T(\bm{x})f_n(\bm{x};\theta)\,\mathrm{d}\bm{x}

指数型分布族は正則条件を満たす。U(0,θ)\mathrm{U}(0,\theta) は (i) を満たさない。

定義 6.11(スコアと Fisher 情報量)

s(x;θ)=∂∂θlog⁡f(x;θ)s(x;\theta)=\frac{\partial }{\partial \theta}\log f(x;\theta) をスコア関数、

I(θ)=Eθ[s(X;θ)2](6.7)I(\theta)=E_\theta\bigl[s(X;\theta)^2\bigr]\tag{6.7}

を1標本あたりの Fisher 情報量という。大きさ nn の標本の対数尤度を ℓ(θ)=∑ilog⁡f(Xi;θ)\ell(\theta)=\sum_i\log f(X_i;\theta) とする。これについて In(θ)=Eθ[(∂ℓ/∂θ)2]I_n(\theta)=E_\theta[(\partial\ell/\partial\theta)^2] とおく。

補題 6.12(スコアの平均と分散 ★★★)

正則条件のもとで、

Eθ[s(X;θ)]=0,I(θ)=Vθ[s(X;θ)]=−Eθ[∂2∂θ2log⁡f(X;θ)],In(θ)=nI(θ).E_\theta[s(X;\theta)]=0,\qquad I(\theta)=V_\theta[s(X;\theta)]=-E_\theta\Bigl[\frac{\partial^2}{\partial\theta^2}\log f(X;\theta)\Bigr],\qquad I_n(\theta)=nI(\theta).

証明

∫f(x;θ) dx=1\int f(x;\theta)\,\mathrm{d} x=1 をパラメータで微分する。∂f/∂θ=s f\partial f/\partial\theta=s\,f だから

0=∫∂f∂θdx=∫s(x;θ)f(x;θ) dx=Eθ[s]0=\int\frac{\partial f}{\partial \theta}\mathrm{d} x=\int s(x;\theta)f(x;\theta)\,\mathrm{d} x=E_\theta[s]

である。これをもう一度 θ\theta で微分すると

0=∫(∂s∂θf+s∂f∂θ)dx=∫∂s∂θf dx+∫s2f dx=Eθ[∂2log⁡f∂θ2]+Eθ[s2].0=\int\Bigl(\frac{\partial s}{\partial \theta}f+s\frac{\partial f}{\partial \theta}\Bigr)\mathrm{d} x=\int\frac{\partial s}{\partial \theta}f\,\mathrm{d} x+\int s^2f\,\mathrm{d} x =E_\theta\Bigl[\frac{\partial^2\log f}{\partial\theta^2}\Bigr]+E_\theta[s^2].

平均が 0 なので E[s2]=V[s]E[s^2]=V[s] で、2つ目の等式を得る。最後に、∂ℓ/∂θ=∑is(Xi;θ)\partial\ell/\partial\theta=\sum_i s(X_i;\theta) は平均 0 の独立な確率変数の和である。よって分散は和になり、In=nII_n=nI である。

2つの表し方のうち、−E[∂2log⁡f/∂θ2]-E[\partial^2\log f/\partial\theta^2] の方が計算は楽なことが多い。2階導関数が XX について1次式になる分布では期待値がすぐ取れるからである。

Cramér–Rao の不等式

定理 6.13(Cramér–Rao の不等式 ★★★)

正則条件を仮定する。統計量 T=T(X)T=T(\bm{X}) が、すべての真の値で Eθ[T]=g(θ)E_\theta[T]=g(\theta) を満たすとする(つまり不偏推定量)。さらに分散が有限なら

Vθ[T]≥g′(θ)2nI(θ).(6.8)V_\theta[T]\ge\frac{g'(\theta)^2}{nI(\theta)}.\tag{6.8}

等号が成り立つための必要十分条件は、ある a(θ)a(\theta) があって、確率1で次の式が成り立つことである。

∂ℓ∂θ=a(θ)(T−g(θ))\frac{\partial\ell}{\partial\theta}=a(\theta)\bigl(T-g(\theta)\bigr)

証明

g(θ)=∫T(x)fn(x;θ) dxg(\theta)=\int T(\bm{x})f_n(\bm{x};\theta)\,\mathrm{d}\bm{x} をパラメータで微分し、正則条件 (iii) で微分と積分を交換する。∂fn/∂θ=(∂ℓ/∂θ)fn\partial f_n/\partial\theta=(\partial\ell/\partial\theta)f_n だから

g′(θ)=∫T(x)∂ℓ∂θfn(x;θ) dx=Eθ[T∂ℓ∂θ]=Covθ(T,∂ℓ∂θ).g'(\theta)=\int T(\bm{x})\frac{\partial \ell}{\partial \theta}f_n(\bm{x};\theta)\,\mathrm{d}\bm{x}=E_\theta\Bigl[T\frac{\partial \ell}{\partial \theta}\Bigr]=\mathrm{Cov}_\theta\Bigl(T,\frac{\partial \ell}{\partial \theta}\Bigr).

最後の等号は補題 6.12 の E[∂ℓ/∂θ]=0E[\partial\ell/\partial\theta]=0 による。Cauchy–Schwarz の不等式 Cov(U,W)2≤V[U]V[W]\mathrm{Cov}(U,W)^2\le V[U]V[W] を使うと

g′(θ)2≤Vθ[T]⋅Vθ[∂ℓ∂θ]=Vθ[T]⋅nI(θ)g'(\theta)^2\le V_\theta[T]\cdot V_\theta\Bigl[\frac{\partial \ell}{\partial \theta}\Bigr]=V_\theta[T]\cdot nI(\theta)

となり、(6.8) が従う。Cauchy–Schwarz の等号は、T−E[T]T-E[T] と ∂ℓ/∂θ\partial\ell/\partial\theta が確率1で比例するときに限る(後者は平均が 0 なので中心化は要らない)。すなわち ∂ℓ/∂θ=a(θ)(T−g(θ))\partial\ell/\partial\theta=a(\theta)(T-g(\theta)) のときである。

右辺 g′(θ)2/(nI(θ))g'(\theta)^2/(nI(\theta)) を Cramér–Rao の下限という。g(θ)=θg(\theta)=\theta なら下限は 1/(nI(θ))1/(nI(\theta)) で、「1標本あたりの情報量が大きいほど、そして標本が多いほど、不偏推定量の分散を小さくできる」と読める。分散が下限に一致する不偏推定量を有効推定量という。

等号条件を θ\theta について積分すると、ℓ(θ)=A(θ)T(x)−B(θ)+H(x)\ell(\theta)=A(\theta)T(\bm{x})-B(\theta)+H(\bm{x}) の形になる。これは指数型分布族 (6.3)(k=1k=1)の形である。したがって有効推定量が存在するのは、指数型分布族で、しかも推定したい量が十分統計量の期待値 g(θ)=E[T]g(\theta)=E[T] である場合に限られる。たとえば正規分布の μ\mu には Xˉ\bar X が有効推定量だが、例題 6.5 で見るように、同じ族でも推定する量の選び方によって下限が達成されないことがある。

正則条件が成り立たない場合

U(0,θ)\mathrm{U}(0,\theta) では台が θ\theta に依存するので、Cramér–Rao の不等式は使えない。実際、不偏推定量 n+1nX(n)\frac{n+1}{n}X_{(n)} の分散は θ2n(n+2)\frac{\theta^2}{n(n+2)} である(確認テスト 6.3-3)。この分散は 1/n1/n でなく 1/n21/n^2 の速さで小さくなる。

形式的に I(θ)=E[(∂log⁡f/∂θ)2]=1/θ2I(\theta)=E[(\partial\log f/\partial\theta)^2]=1/\theta^2 と計算して下限 θ2/n\theta^2/n を出すと、それより小さい分散の不偏推定量があることになり矛盾する。「下限を計算せよ」と問われたら、まず台が θ\theta によらないかを確かめる。

情報理論から見た Fisher 情報量

パラメータを θ\theta から θ+δ\theta+\delta に少しずらした2つの分布を考える。その Kullback–Leibler 情報量(§6.4)をずれについて展開すると、2次の項 12I(θ)δ2\frac12I(\theta)\delta^2 に Fisher 情報量が現れる。この見方と、Cramér–Rao の不等式・最尤推定の漸近有効性の関係は、虎の巻『相対エントロピーから情報と物理を組み立てる』第1部第7章でも扱う。

例題 6.4 ポアソン分布の Cramér–Rao の下限 ★★★

オリジナルX1,…,XnX_1,\dots,X_n が独立に Po(λ)\mathrm{Po}(\lambda) に従う(パラメータは正)。

  1. Fisher 情報量 I(λ)I(\lambda) を求めよ。
  2. Xˉ\bar X が λ\lambda の有効推定量であることを示せ。
  3. g(λ)=e−λ=P(X1=0)g(\lambda)=\mathrm{e}^{-\lambda}=P(X_1=0) の不偏推定量の分散の下限を求めよ。
解答

(1) 対数密度とその導関数は

log⁡f(x;λ)=xlog⁡λ−λ−log⁡x!,s=xλ−1,∂2log⁡f∂λ2=−xλ2\log f(x;\lambda)=x\log\lambda-\lambda-\log x!,\qquad s=\frac{x}{\lambda}-1,\qquad\frac{\partial^2\log f}{\partial\lambda^2}=-\frac{x}{\lambda^2}

である。補題 6.12 から

I(λ)=−E[−Xλ2]=λλ2=1λI(\lambda)=-E\Bigl[-\frac{X}{\lambda^2}\Bigr]=\frac{\lambda}{\lambda^2}=\frac1\lambda

である。(確かめとして E[s2]=V[X]/λ2=λ/λ2=1/λE[s^2]=V[X]/\lambda^2=\lambda/\lambda^2=1/\lambda でも同じ値になる。)

(2) E[Xˉ]=λE[\bar X]=\lambda で不偏、V[Xˉ]=λ/nV[\bar X]=\lambda/n である。下限は 1/(nI(λ))=λ/n1/(nI(\lambda))=\lambda/n で、分散と一致する。よって Xˉ\bar X は有効推定量である。等号条件の形でも確かめられる。

∂ℓ∂λ=∑Xiλ−n=nλ(Xˉ−λ)\frac{\partial \ell}{\partial \lambda}=\frac{\sum X_i}{\lambda}-n=\frac{n}{\lambda}(\bar X-\lambda)

で、a(λ)=n/λa(\lambda)=n/\lambda の比例関係になっている。

(3) g′(λ)=−e−λg'(\lambda)=-\mathrm{e}^{-\lambda} なので、下限は

g′(λ)2nI(λ)=e−2λn/λ=λe−2λn.\frac{g'(\lambda)^2}{nI(\lambda)}=\frac{\mathrm{e}^{-2\lambda}}{n/\lambda}=\frac{\lambda\mathrm{e}^{-2\lambda}}{n}.

e−λ\mathrm{e}^{-\lambda} は十分統計量 ∑Xi\sum X_i の期待値の形ではないので、等号を達成する不偏推定量は存在しない。e−λ\mathrm{e}^{-\lambda} の不偏推定量 (1−1/n)∑Xi(1-1/n)^{\sum X_i} の分散は、第10章で導くとおり

e−2λ(eλ/n−1)\mathrm{e}^{-2\lambda}(\mathrm{e}^{\lambda/n}-1)

である。eλ/n−1>λ/n\mathrm{e}^{\lambda/n}-1>\lambda/n なので、この分散は下限より真に大きい。

例題 6.5 ベータ型の分布で推定量の分散と下限を比べる ★★★

オリジナル例題 6.1・6.2 の設定(密度 f(x;θ)=θxθ−1f(x;\theta)=\theta x^{\theta-1}、区間 (0,1)(0,1))を考える。n≥3n\ge3 とし、T=−∑log⁡XiT=-\sum\log X_i とする。

  1. Fisher 情報量 I(θ)I(\theta) を求めよ。
  2. 最尤推定量 θ^=n/T\hat\theta=n/T の期待値を求め、偏りを除いた不偏推定量 θ∗\theta^* を作れ。
  3. V[θ∗]V[\theta^*] を求め、Cramér–Rao の下限と比べよ。
  4. 1/θ1/\theta の推定量 T/nT/n は有効推定量であることを示せ。
解答

(1) log⁡f=log⁡θ+(θ−1)log⁡x\log f=\log\theta+(\theta-1)\log x より ∂2log⁡f/∂θ2=−1/θ2\partial^2\log f/\partial\theta^2=-1/\theta^2。よって I(θ)=1/θ2I(\theta)=1/\theta^2。

(2) 例題 6.1 (3) から T∼Ga(n,1/θ)T\sim\mathrm{Ga}(n,1/\theta)。r<nr<n について

E[T−r]=∫0∞t−rθntn−1e−θtΓ(n)dt=θnΓ(n)⋅Γ(n−r)θn−r=θrΓ(n−r)Γ(n)E[T^{-r}]=\int_0^\infty t^{-r}\frac{\theta^n t^{n-1}\mathrm{e}^{-\theta t}}{\Gamma(n)}\mathrm{d} t=\frac{\theta^n}{\Gamma(n)}\cdot\frac{\Gamma(n-r)}{\theta^{n-r}}=\theta^r\frac{\Gamma(n-r)}{\Gamma(n)}

(∫0∞tn−r−1e−θtdt=Γ(n−r)/θn−r\int_0^\infty t^{n-r-1}\mathrm{e}^{-\theta t}\mathrm{d} t=\Gamma(n-r)/\theta^{n-r} を使った)。r=1,2r=1,2 では

E[T−1]=θn−1,E[T−2]=θ2(n−1)(n−2).E[T^{-1}]=\frac{\theta}{n-1},\qquad E[T^{-2}]=\frac{\theta^2}{(n-1)(n-2)}.

したがって E[θ^]=nθn−1E[\hat\theta]=\dfrac{n\theta}{n-1} で、偏りは θn−1\dfrac{\theta}{n-1}。θ∗=n−1nθ^=n−1T\theta^*=\dfrac{n-1}{n}\hat\theta=\dfrac{n-1}{T} は不偏である。

(3) V[θ∗]=(n−1)2E[T−2]−θ2=θ2(n−1n−2−1)=θ2n−2V[\theta^*]=(n-1)^2E[T^{-2}]-\theta^2=\theta^2\Bigl(\dfrac{n-1}{n-2}-1\Bigr)=\dfrac{\theta^2}{n-2}。下限は 1/(nI(θ))=θ2/n1/(nI(\theta))=\theta^2/n で、V[θ∗]/(θ2/n)=n/(n−2)>1V[\theta^*]/(\theta^2/n)=n/(n-2)>1。θ∗\theta^* は下限を達成しないが、比は n→∞n\to\infty で 1 に近づく。なお最尤推定量そのものの平均二乗誤差は、分散

V[θ^]=n2E[T−2]−(Eθ^)2=n2θ2(n−1)2(n−2)V[\hat\theta]=n^2E[T^{-2}]-(E\hat\theta)^2=\frac{n^2\theta^2}{(n-1)^2(n-2)}

に偏りの2乗を足して得る。結果は次のとおりで、θ∗\theta^* の値より大きい。

MSE(θ^)=(n+2)θ2(n−1)(n−2) > θ2n−2=(n−1)θ2(n−1)(n−2)=V[θ∗]\mathrm{MSE}(\hat\theta)=\frac{(n+2)\theta^2}{(n-1)(n-2)}\ >\ \frac{\theta^2}{n-2}=\frac{(n-1)\theta^2}{(n-1)(n-2)}=V[\theta^*]

(4) E[T/n]=E[Y1]=1/θE[T/n]=E[Y_1]=1/\theta で不偏、V[T/n]=V[Y1]/n=1/(nθ2)V[T/n]=V[Y_1]/n=1/(n\theta^2)。g(θ)=1/θg(\theta)=1/\theta の下限はg′(θ)2/(nI(θ))=(1/θ4)/(n/θ2)=1/(nθ2)g'(\theta)^2/(nI(\theta))=(1/\theta^4)/(n/\theta^2)=1/(n\theta^2) で一致する。等号条件の形でも、∂ℓ/∂θ=n/θ−T=−n(T/n−1/θ)\partial\ell/\partial\theta=n/\theta-T=-n\bigl(T/n-1/\theta\bigr) と比例関係になっている。同じ統計モデルで、1/θ1/\theta には有効推定量があり、θ\theta にはない。

最尤推定量の漸近正規性

有限の標本では、最尤推定量は不偏とも有効とも限らない。しかし nn が大きいときには、下限 1/(nI(θ))1/(nI(\theta)) を分散とする正規分布に近づく。

定理 6.14(最尤推定量の漸近正規性 ★★★)

正則条件に加えて、次の2つを仮定する。

  • 対数尤度の3階導関数が、真の値の近くで可積分な関数で押さえられる。
  • 最尤推定量 θ^n\hat\theta_n が一致推定量である。

このとき

n (θ^n−θ)→ d N(0,1I(θ))(n→∞).(6.9)\sqrt n\,(\hat\theta_n-\theta)\xrightarrow{\ d\ }\mathrm{N}\Bigl(0,\frac{1}{I(\theta)}\Bigr)\qquad(n\to\infty).\tag{6.9}

証明の筋道

尤度方程式 ℓ′(θ^n)=0\ell'(\hat\theta_n)=0 を真の値 θ\theta の周りで展開する。θ^n\hat\theta_n と真の値の間のある θ~n\tilde\theta_n について

0=ℓ′(θ)+(θ^n−θ)ℓ′′(θ~n)0=\ell'(\theta)+(\hat\theta_n-\theta)\ell''(\tilde\theta_n)

となる。両辺を整えて

n (θ^n−θ)=ℓ′(θ)/n−ℓ′′(θ~n)/n.\sqrt n\,(\hat\theta_n-\theta)=\frac{\ell'(\theta)/\sqrt n}{-\ell''(\tilde\theta_n)/n}.

分子と分母を別々に調べる。

  1. 分子は正規分布に収束する。 分子の ℓ′(θ)=∑is(Xi;θ)\ell'(\theta)=\sum_i s(X_i;\theta) は、平均 0・分散 I(θ)I(\theta) の独立同分布の和である。中心極限定理により、分子は N(0,I(θ))\mathrm{N}(0,I(\theta)) に分布収束する。
  2. 分母は I(θ)I(\theta) に収束する。 一致性と3階導関数の仮定から、分母と −ℓ′′(θ)/n-\ell''(\theta)/n の差は 0 に確率収束する。その −ℓ′′(θ)/n-\ell''(\theta)/n は、大数の法則で −E[∂2log⁡f/∂θ2]=I(θ)-E[\partial^2\log f/\partial\theta^2]=I(\theta) に確率収束する。

Slutsky の定理(第5章 §5.3)から、比は次の分布に分布収束する。

N(0,I(θ))I(θ)=N(0,1I(θ))\frac{\mathrm{N}(0,I(\theta))}{I(\theta)}=\mathrm{N}\Bigl(0,\frac{1}{I(\theta)}\Bigr)

最尤推定量の関数の漸近分布は、次のデルタ法で出す。

命題 6.15(デルタ法 ★★★)

n(θ^n−θ)→dN(0,τ2)\sqrt n(\hat\theta_n-\theta)\xrightarrow{d}\mathrm{N}(0,\tau^2) とする。関数 gg が真の値で微分可能で、g′(θ)≠0g'(\theta)\ne0 なら

n(g(θ^n)−g(θ))→dN(0,g′(θ)2τ2).\sqrt n\bigl(g(\hat\theta_n)-g(\theta)\bigr)\xrightarrow{d}\mathrm{N}\bigl(0,g'(\theta)^2\tau^2\bigr).

証明

差を次のように書く。

g(θ^n)−g(θ)=g′(θ)(θ^n−θ)+rn(θ^n−θ)g(\hat\theta_n)-g(\theta)=g'(\theta)(\hat\theta_n-\theta)+r_n(\hat\theta_n-\theta)

θ^n\hat\theta_n は真の値に確率収束するので、rnr_n は 0 に確率収束する。n(θ^n−θ)\sqrt n(\hat\theta_n-\theta) は分布収束するので確率的に有界である。よって第2項に n\sqrt n を掛けたものは 0 に確率収束する。Slutsky の定理から結論を得る。

最尤推定量に定理 6.14 と命題 6.15 を続けて使う。すると g(θ^n)g(\hat\theta_n) の漸近分散は g′(θ)2/(nI(θ))g'(\theta)^2/(nI(\theta)) となる。これは Cramér–Rao の下限と一致する。この意味で最尤推定量は漸近有効である。

(6.9) の I(θ)I(\theta) を I(θ^n)I(\hat\theta_n) で置き換えると、近似 95% 信頼区間

θ^n±z0.025nI(θ^n)(z0.025=1.960)\hat\theta_n\pm\frac{z_{0.025}}{\sqrt{nI(\hat\theta_n)}}\qquad(z_{0.025}=1.960)

が得られる。区間推定の組み立ては第8章 §8.2 で扱う。

関連:最尤推定を相対エントロピーの最小化として読む

虎の巻『相対エントロピーから情報と物理を組み立てる』第1部第7章「Fisher 情報と Cramér–Rao」の「最尤推定と漸近有効性」の節は、最尤推定を経験分布との相対エントロピーの最小化と読み、漸近分散 1/(nI(θ))1/(nI(\theta)) が Cramér–Rao の下限に達することを同じ見方で導いている。本節の定理 6.14 の「なぜ I(θ)I(\theta) が出るか」を腑に落としたいときに読むとよい。

確認テスト

オリジナル

  1. 6.3-1 成功確率 pp のベルヌーイ試行(0<p<10<p<1)を考える。Fisher 情報量 I(p)I(p) を求めよ。また、標本比率 Xˉ\bar X が有効推定量であることを示せ。
  2. 6.3-2 Xi∼N(μ,σ2)X_i\sim\mathrm{N}(\mu,\sigma^2) で、平均は既知、分散 v=σ2v=\sigma^2 が未知とする。I(v)I(v) を求めよ。また、v^=1n∑(Xi−μ)2\hat v=\frac1n\sum(X_i-\mu)^2 が有効推定量であることを示せ。
  3. 6.3-3 Xi∼U(0,θ)X_i\sim\mathrm{U}(0,\theta) とする。(a) θ1=n+1nX(n)\theta_1=\frac{n+1}{n}X_{(n)} が不偏であることを示し、分散を求めよ。(b) 積率推定量 θ2=2Xˉ\theta_2=2\bar X の分散を求めよ。n≥2n\ge2 では θ1\theta_1 の方が分散が小さいことを示せ。
  4. 6.3-4 Xi∼Ex(λ)X_i\sim\mathrm{Ex}(\lambda) とする。(a) I(λ)I(\lambda) を補題 6.12 の2通りの式で求めよ。(b) 最尤推定量 λ^=1/Xˉ\hat\lambda=1/\bar X の漸近分布を書け。(c) λ∗=(n−1)/∑Xi\lambda^*=(n-1)/\sum X_i(n≥3n\ge3)が不偏であることを示し、分散を求めて Cramér–Rao の下限と比べよ。
  5. 6.3-5 正規母集団の不偏分散 S2S^2 が σ2\sigma^2 の一致推定量であることを、平均二乗誤差を用いて示せ。

木下の勉強ステータス

木下はまだこの記事を勉強していません。

AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com

← AI生成教科書『資格試験』の記事一覧へ