数理統計 第11章 §11.1 ★ 目標分布を定常分布に持つマルコフ連鎖を作り、その標本平均で期待値を近似する。正しさの根拠は詳細つり合い
第6章から第10章までの議論では、最尤推定量は尤度方程式を手で解いて閉じた式で書け、事後分布の平均は共役事前分布のおかげで積分の公式から求まった。実際のデータ解析では、この2つはどちらも成り立たないことが多い。
尤度方程式が λ / ( 1 − e − λ ) = x ˉ \lambda/(1-\mathrm{e}^{-\lambda})=\bar x λ / ( 1 − e − λ ) = x ˉ ∫ L ( θ ) π ( θ ) d θ \int L(\theta)\pi(\theta)\,\mathrm{d}\theta ∫ L ( θ ) π ( θ ) d θ
1つめは、分布から乱数を発生させ、その平均で積分を近似するモンテカルロ法である。規格化定数が分からない分布からでも乱数を作れるようにする道具がマルコフ連鎖モンテカルロ法(MCMC)で、§11.1 で扱う。2つめは、推定量の分布そのものが手で求まらないとき、データから作った経験分布で母集団を置き換えて標準誤差や偏りを見積もるブートストラップ法で、§11.2 で扱う。3つめは、尤度方程式を反復で解く Newton–Raphson 法とEM アルゴリズムで、§11.3 で扱う。
1級の統計数理で計算機を使う問題は出ない。この章の内容が問われるとすれば、紙の上で導ける部分である。具体的には、棄却法で採択される乱数の密度が目標の密度になることの証明と採択確率、Metropolis–Hastings 法の推移核が詳細つり合いを満たすことの確認、ブートストラップ分布の平均と分散を経験分布から厳密に計算すること、Newton 法と EM アルゴリズムの更新式を尤度から導き、不動点が最尤推定量であることと収束の速さを示すこと、の4種類である。どれも第6章の尤度と第4章の条件付き分布の計算の応用なので、この章ではその計算を省かずに書く。
モンテカルロ積分
密度 f f f X X X
μ h = E [ h ( X ) ] = ∫ h ( x ) f ( x ) d x \mu_h=E[h(X)]=\int h(x)f(x)\,\mathrm{d} x μ h = E [ h ( X )] = ∫ h ( x ) f ( x ) d x
ここで h h h f f f X 1 , … , X N X_1,\dots,X_N X 1 , … , X N
μ ^ h = 1 N ∑ t = 1 N h ( X t ) (11.1) \hat\mu_h=\frac1N\sum_{t=1}^N h(X_t)\tag{11.1} μ ^ h = N 1 t = 1 ∑ N h ( X t ) ( 11.1 )
は μ h \mu_h μ h N → ∞ N\to\infty N → ∞ μ h \mu_h μ h σ h 2 = V [ h ( X ) ] \sigma_h^2=V[h(X)] σ h 2 = V [ h ( X )]
V [ μ ^ h ] = σ h 2 N , N ( μ ^ h − μ h ) は近似的に N ( 0 , σ h 2 ) に従う V[\hat\mu_h]=\frac{\sigma_h^2}{N},\qquad \sqrt N(\hat\mu_h-\mu_h)\ \text{は近似的に}\ \mathrm N(0,\sigma_h^2)\ \text{に従う} V [ μ ^ h ] = N σ h 2 , N ( μ ^ h − μ h ) は近似的に N ( 0 , σ h 2 ) に従う
である(後半は中心極限定理による)。σ h 2 \sigma_h^2 σ h 2 h ( X t ) h(X_t) h ( X t ) モンテカルロ積分 と呼ぶ。
誤差が 1 / N 1/\sqrt N 1/ N d d d
確率 p = P ( X ∈ A ) p=P(X\in A) p = P ( X ∈ A ) h = 1 A h=\bm 1_A h = 1 A h ( X t ) h(X_t) h ( X t ) p p p σ h 2 = p ( 1 − p ) \sigma_h^2=p(1-p) σ h 2 = p ( 1 − p ) p p p
p ( 1 − p ) / N p = 1 − p N p \frac{\sqrt{p(1-p)/N}}{p}=\sqrt{\frac{1-p}{Np}} p p ( 1 − p ) / N = N p 1 − p
になる。p p p N N N
f f f g g g g g g f > 0 f>0 f > 0 g g g Y 1 , … , Y N Y_1,\dots,Y_N Y 1 , … , Y N
μ ~ h = 1 N ∑ t = 1 N h ( Y t ) f ( Y t ) g ( Y t ) (11.2) \tilde\mu_h=\frac1N\sum_{t=1}^N h(Y_t)\frac{f(Y_t)}{g(Y_t)}\tag{11.2} μ ~ h = N 1 t = 1 ∑ N h ( Y t ) g ( Y t ) f ( Y t ) ( 11.2 )
で近似してもよい。E g [ h ( Y ) f ( Y ) / g ( Y ) ] = ∫ h ( y ) f ( y ) d y = μ h E_g[h(Y)f(Y)/g(Y)]=\int h(y)f(y)\,\mathrm{d} y=\mu_h E g [ h ( Y ) f ( Y ) / g ( Y )] = ∫ h ( y ) f ( y ) d y = μ h 重点サンプリング と呼び、比 f / g f/g f / g g g g ∣ h ∣ f \lvert h\rvert f ∣ h ∣ f
乱数の生成:逆関数法と棄却法
計算機は区間 ( 0 , 1 ) (0,1) ( 0 , 1 ) U ( 0 , 1 ) \mathrm U(0,1) U ( 0 , 1 )
定理 11.1(逆関数法 ★★)
分布関数 F F F
F − 1 ( u ) = inf { x : F ( x ) ≥ u } ( 0 < u < 1 ) F^{-1}(u)=\inf\{x:F(x)\ge u\}\qquad(0<u<1) F − 1 ( u ) = inf { x : F ( x ) ≥ u } ( 0 < u < 1 )
U ∼ U ( 0 , 1 ) U\sim\mathrm U(0,1) U ∼ U ( 0 , 1 ) X = F − 1 ( U ) X=F^{-1}(U) X = F − 1 ( U ) F F F
証明 F F F
F − 1 ( u ) ≤ x ⟺ u ≤ F ( x ) F^{-1}(u)\le x\iff u\le F(x) F − 1 ( u ) ≤ x ⟺ u ≤ F ( x )
(⇒ \Rightarrow ⇒ F − 1 ( u ) ≤ x F^{-1}(u)\le x F − 1 ( u ) ≤ x F ( F − 1 ( u ) ) ≥ u F(F^{-1}(u))\ge u F ( F − 1 ( u )) ≥ u F F F F ( x ) ≥ F ( F − 1 ( u ) ) ≥ u F(x)\ge F(F^{-1}(u))\ge u F ( x ) ≥ F ( F − 1 ( u )) ≥ u (⇐ \Leftarrow ⇐ u ≤ F ( x ) u\le F(x) u ≤ F ( x ) x x x { x : F ( x ) ≥ u } \{x:F(x)\ge u\} { x : F ( x ) ≥ u } F − 1 ( u ) ≤ x F^{-1}(u)\le x F − 1 ( u ) ≤ x
したがって
P ( X ≤ x ) = P ( F − 1 ( U ) ≤ x ) = P ( U ≤ F ( x ) ) = F ( x ) P(X\le x)=P(F^{-1}(U)\le x)=P(U\le F(x))=F(x) P ( X ≤ x ) = P ( F − 1 ( U ) ≤ x ) = P ( U ≤ F ( x )) = F ( x )
である。
逆関数法は F − 1 F^{-1} F − 1 F − 1 F^{-1} F − 1
定理 11.2(棄却法 ★★)
目標の密度を f f f g g g M M M x x x
f ( x ) ≤ M g ( x ) f(x)\le Mg(x) f ( x ) ≤ M g ( x )
が成り立つとする。次の手続きを考える。
Y ∼ g Y\sim g Y ∼ g U ∼ U ( 0 , 1 ) U\sim\mathrm U(0,1) U ∼ U ( 0 , 1 ) U ≤ f ( Y ) / { M g ( Y ) } U\le f(Y)/\{Mg(Y)\} U ≤ f ( Y ) / { M g ( Y )} X = Y X=Y X = Y
このとき次が成り立つ。
採択された X X X f f f
1回の試行で採択される確率は 1 / M 1/M 1/ M
採択までの試行回数は成功確率 1 / M 1/M 1/ M M M M
証明 1回の試行で「Y ≤ x Y\le x Y ≤ x Y = y Y=y Y = y f ( y ) / { M g ( y ) } f(y)/\{Mg(y)\} f ( y ) / { M g ( y )}
P ( Y ≤ x , U ≤ f ( Y ) M g ( Y ) ) = ∫ − ∞ x f ( y ) M g ( y ) g ( y ) d y = 1 M ∫ − ∞ x f ( y ) d y . (11.3) P\Bigl(Y\le x,\ U\le\frac{f(Y)}{Mg(Y)}\Bigr)=\int_{-\infty}^x\frac{f(y)}{Mg(y)}\,g(y)\,\mathrm{d} y=\frac1M\int_{-\infty}^xf(y)\,\mathrm{d} y .\tag{11.3} P ( Y ≤ x , U ≤ M g ( Y ) f ( Y ) ) = ∫ − ∞ x M g ( y ) f ( y ) g ( y ) d y = M 1 ∫ − ∞ x f ( y ) d y . ( 11.3 )
x → ∞ x\to\infty x → ∞ P ( 採択 ) = 1 / M P(\text{採択})=1/M P ( 採択 ) = 1/ M Y Y Y
P ( Y ≤ x ∣ 採択 ) = P ( Y ≤ x , 採択 ) P ( 採択 ) = ∫ − ∞ x f ( y ) d y P(Y\le x\mid\text{採択})=\frac{P(Y\le x,\ \text{採択})}{P(\text{採択})}=\int_{-\infty}^xf(y)\,\mathrm{d} y P ( Y ≤ x ∣ 採択 ) = P ( 採択 ) P ( Y ≤ x , 採択 ) = ∫ − ∞ x f ( y ) d y
となる。これは f f f 1 / M 1/M 1/ M
f ≤ M g f\le Mg f ≤ M g 1 ≤ M 1\le M 1 ≤ M M M M M M M sup x f ( x ) / g ( x ) \sup_x f(x)/g(x) sup x f ( x ) / g ( x )
f f f f = c f ~ f=c\tilde f f = c f ~ f ~ \tilde f f ~ f ~ ≤ M ~ g \tilde f\le\tilde Mg f ~ ≤ M ~ g M ~ \tilde M M ~
U ≤ f ~ ( Y ) M ~ g ( Y ) U\le\frac{\tilde f(Y)}{\tilde Mg(Y)} U ≤ M ~ g ( Y ) f ~ ( Y )
となり、c c c 1 / ( c M ~ ) 1/(c\tilde M) 1/ ( c M ~ )
例題 11.1 指数分布から半正規分布を作る棄却法 ★★
オリジナル 半正規分布の密度
f ( x ) = 2 / π e − x 2 / 2 ( x > 0 ) f(x)=\sqrt{2/\pi}\,\mathrm{e}^{-x^2/2}\qquad(x>0) f ( x ) = 2/ π e − x 2 /2 ( x > 0 )
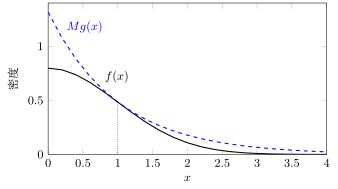
に従う乱数を、棄却法で作る。提案には指数分布 E x ( 1 ) \mathrm{Ex}(1) Ex ( 1 ) g ( x ) = e − x ( x > 0 ) g(x)=\mathrm{e}^{-x}\ (x>0) g ( x ) = e − x ( x > 0 )
f ( x ) ≤ M g ( x ) ( x > 0 ) f(x)\le Mg(x)\ (x>0) f ( x ) ≤ M g ( x ) ( x > 0 ) M M M 採択の条件 U ≤ f ( Y ) / { M g ( Y ) } U\le f(Y)/\{Mg(Y)\} U ≤ f ( Y ) / { M g ( Y )}
採択確率と、1つの乱数を得るまでの平均の試行回数を求めよ。
解答 (1) 比は f ( x ) / g ( x ) = 2 / π exp ( x − x 2 / 2 ) f(x)/g(x)=\sqrt{2/\pi}\,\exp(x-x^2/2) f ( x ) / g ( x ) = 2/ π exp ( x − x 2 /2 ) x − x 2 / 2 x-x^2/2 x − x 2 /2 1 − x 1-x 1 − x x = 1 x=1 x = 1 1 / 2 1/2 1/2 M M M
M = sup x > 0 f ( x ) g ( x ) = 2 π e 1 / 2 = 2 e π ≈ 1.3155. M=\sup_{x>0}\frac{f(x)}{g(x)}=\sqrt{\frac2\pi}\,\mathrm{e}^{1/2}=\sqrt{\frac{2\mathrm{e}}{\pi}}\approx1.3155 . M = x > 0 sup g ( x ) f ( x ) = π 2 e 1/2 = π 2 e ≈ 1.3155.
(2) f ( y ) / { M g ( y ) } = exp ( y − y 2 / 2 − 1 / 2 ) = exp { − ( y − 1 ) 2 / 2 } f(y)/\{Mg(y)\}=\exp(y-y^2/2-1/2)=\exp\{-(y-1)^2/2\} f ( y ) / { M g ( y )} = exp ( y − y 2 /2 − 1/2 ) = exp { − ( y − 1 ) 2 /2 }
U ≤ exp { − ( Y − 1 ) 2 2 } ⟺ − log U ≥ ( Y − 1 ) 2 2 U\le\exp\Bigl\{-\frac{(Y-1)^2}{2}\Bigr\}\quad\Longleftrightarrow\quad -\log U\ge\frac{(Y-1)^2}{2} U ≤ exp { − 2 ( Y − 1 ) 2 } ⟺ − log U ≥ 2 ( Y − 1 ) 2
である。右の形にすると、− log U -\log U − log U E x ( 1 ) \mathrm{Ex}(1) Ex ( 1 )
(3) 定理 11.2 から採択確率は 1 / M = π / ( 2 e ) ≈ 0.7602 1/M=\sqrt{\pi/(2\mathrm{e})}\approx0.7602 1/ M = π / ( 2 e ) ≈ 0.7602 M ≈ 1.3155 M\approx1.3155 M ≈ 1.3155 ± \pm ± N ( 0 , 1 ) \mathrm N(0,1) N ( 0 , 1 )
図 11.1 例題 11.1 の棄却法。実線が半正規分布の密度 f f f M g = 2 e / π e − x Mg=\sqrt{2\mathrm{e}/\pi}\,\mathrm{e}^{-x} M g = 2 e / π e − x x = 1 x=1 x = 1 Y Y Y g g g ( Y , U M g ( Y ) ) (Y,UMg(Y)) ( Y , U M g ( Y )) M − 1 ≈ 0.32 M-1\approx0.32 M − 1 ≈ 0.32 M M M
マルコフ連鎖と定常分布
ベイズ推測の事後分布 π ( θ ∣ x ) ∝ L ( θ ) π ( θ ) \pi(\theta\mid\bm x)\propto L(\theta)\pi(\theta) π ( θ ∣ x ) ∝ L ( θ ) π ( θ ) M M M
そこで、独立な乱数を作ることはあきらめ、目標分布を定常分布に持つマルコフ連鎖を走らせて、その軌道の平均で期待値を近似する。これがマルコフ連鎖モンテカルロ法である。マルコフ連鎖の一般論は第12章 §12.5 で扱う。ここでは MCMC に要る定義と結果だけを書く。
状態空間 X \mathcal X X X 0 , X 1 , X 2 , … X_0,X_1,X_2,\dots X 0 , X 1 , X 2 , … t t t
P ( X t + 1 ∈ A ∣ X t = x , X t − 1 , … , X 0 ) = P ( X t + 1 ∈ A ∣ X t = x ) P(X_{t+1}\in A\mid X_t=x,X_{t-1},\dots,X_0)=P(X_{t+1}\in A\mid X_t=x) P ( X t + 1 ∈ A ∣ X t = x , X t − 1 , … , X 0 ) = P ( X t + 1 ∈ A ∣ X t = x )
が成り立ち、右辺が t t t (時間的に一様な)マルコフ連鎖 と呼ぶ。右辺を ( x , A ) (x,A) ( x , A ) 推移核 と呼び、K ( x , A ) K(x,A) K ( x , A ) K ( x , ⋅ ) K(x,\cdot) K ( x , ⋅ ) k ( x , y ) k(x,y) k ( x , y ) P = ( p i j ) P=(p_{ij}) P = ( p ij ) p i j = P ( X t + 1 = j ∣ X t = i ) p_{ij}=P(X_{t+1}=j\mid X_t=i) p ij = P ( X t + 1 = j ∣ X t = i )
定義 11.3(定常分布と詳細つり合い)
分布 π \pi π
∫ π ( x ) k ( x , y ) d x = π ( y ) ( すべての y ) (11.4) \int\pi(x)k(x,y)\,\mathrm{d} x=\pi(y)\qquad(\text{すべての }y)\tag{11.4} ∫ π ( x ) k ( x , y ) d x = π ( y ) ( すべての y ) ( 11.4 )
を満たすとき、π \pi π k k k 定常分布 と呼ぶ。X t ∼ π X_t\sim\pi X t ∼ π X t + 1 ∼ π X_{t+1}\sim\pi X t + 1 ∼ π
π ( x ) k ( x , y ) = π ( y ) k ( y , x ) ( すべての x , y ) (11.5) \pi(x)k(x,y)=\pi(y)k(y,x)\qquad(\text{すべての }x,y)\tag{11.5} π ( x ) k ( x , y ) = π ( y ) k ( y , x ) ( すべての x , y ) ( 11.5 )
が成り立つとき、k k k π \pi π 詳細つり合い を満たす、あるいは可逆であるという。有限状態では π i p i j = π j p j i \pi_ip_{ij}=\pi_jp_{ji} π i p ij = π j p j i
命題 11.4(詳細つり合いなら定常 ★★)
推移核 k k k π \pi π π \pi π k k k
証明 (11.5) の両辺を x x x
∫ π ( x ) k ( x , y ) d x = π ( y ) ∫ k ( y , x ) d x = π ( y ) \int\pi(x)k(x,y)\,\mathrm{d} x=\pi(y)\int k(y,x)\,\mathrm{d} x=\pi(y) ∫ π ( x ) k ( x , y ) d x = π ( y ) ∫ k ( y , x ) d x = π ( y )
最後の等号は、k ( y , ⋅ ) k(y,\cdot) k ( y , ⋅ ) y y y
定常条件 (11.4) は、y y y x x x (11.5) は2点 x , y x,y x , y
定常分布を持つだけでは、連鎖がそこへ近づく保証は無い。次の定理(証明は第12章 §12.5 に譲る)が、軌道の平均を使ってよい根拠である。
定理 11.5(エルゴード定理)
推移核 k k k π \pi π
初期値によらず、X t X_t X t π \pi π
E π ∣ h ( X ) ∣ < ∞ E_\pi\lvert h(X)\rvert <\infty E π ∣ h ( X )∣ < ∞
1 N ∑ t = 1 N h ( X t ) ⟶ E π [ h ( X ) ] ( N → ∞ ) \frac1N\sum_{t=1}^Nh(X_t)\longrightarrow E_\pi[h(X)]\qquad(N\to\infty) N 1 t = 1 ∑ N h ( X t ) ⟶ E π [ h ( X )] ( N → ∞ )
が成り立つ。
Metropolis–Hastings 法
定義 11.6(Metropolis–Hastings 法)
目標の密度 π \pi π q ( x , y ) q(x,y) q ( x , y ) x x x y y y X t = x X_t=x X t = x X t + 1 X_{t+1} X t + 1
候補 Y ∼ q ( x , ⋅ ) Y\sim q(x,\cdot) Y ∼ q ( x , ⋅ ) U ∼ U ( 0 , 1 ) U\sim\mathrm U(0,1) U ∼ U ( 0 , 1 )
採択確率
α ( x , y ) = min { 1 , π ( y ) q ( y , x ) π ( x ) q ( x , y ) } (11.6) \alpha(x,y)=\min\Bigl\{1,\ \frac{\pi(y)q(y,x)}{\pi(x)q(x,y)}\Bigr\}\tag{11.6} α ( x , y ) = min { 1 , π ( x ) q ( x , y ) π ( y ) q ( y , x ) } ( 11.6 )
を計算し、次のように決める。
U ≤ α ( x , Y ) U\le\alpha(x,Y) U ≤ α ( x , Y ) X t + 1 = Y X_{t+1}=Y X t + 1 = Y そうでなければ X t + 1 = x X_{t+1}=x X t + 1 = x
採択確率 (11.6) には π \pi π π ( y ) / π ( x ) \pi(y)/\pi(x) π ( y ) / π ( x )
定理 11.7(MH 法は詳細つり合いを満たす ★★)
MH 法の推移核は、y ≠ x y\neq x y = x k ( x , y ) = q ( x , y ) α ( x , y ) k(x,y)=q(x,y)\alpha(x,y) k ( x , y ) = q ( x , y ) α ( x , y )
r ( x ) = 1 − ∫ q ( x , y ) α ( x , y ) d y r(x)=1-\int q(x,y)\alpha(x,y)\,\mathrm{d} y r ( x ) = 1 − ∫ q ( x , y ) α ( x , y ) d y
で、連鎖は x x x π \pi π π \pi π
証明 x x x x = y x=y x = y (11.5) の両辺は同じ式なので自明に等しい。x ≠ y x\neq y x = y π ( y ) q ( y , x ) ≤ π ( x ) q ( x , y ) \pi(y)q(y,x)\le\pi(x)q(x,y) π ( y ) q ( y , x ) ≤ π ( x ) q ( x , y )
α ( x , y ) = π ( y ) q ( y , x ) π ( x ) q ( x , y ) , α ( y , x ) = 1 \alpha(x,y)=\frac{\pi(y)q(y,x)}{\pi(x)q(x,y)},\qquad \alpha(y,x)=1 α ( x , y ) = π ( x ) q ( x , y ) π ( y ) q ( y , x ) , α ( y , x ) = 1
なので
π ( x ) k ( x , y ) = π ( x ) q ( x , y ) π ( y ) q ( y , x ) π ( x ) q ( x , y ) = π ( y ) q ( y , x ) = π ( y ) q ( y , x ) α ( y , x ) = π ( y ) k ( y , x ) . \pi(x)k(x,y)=\pi(x)q(x,y)\frac{\pi(y)q(y,x)}{\pi(x)q(x,y)}=\pi(y)q(y,x)=\pi(y)q(y,x)\alpha(y,x)=\pi(y)k(y,x). π ( x ) k ( x , y ) = π ( x ) q ( x , y ) π ( x ) q ( x , y ) π ( y ) q ( y , x ) = π ( y ) q ( y , x ) = π ( y ) q ( y , x ) α ( y , x ) = π ( y ) k ( y , x ) .
逆向きの不等号の場合は x x x y y y π ( x ) k ( x , y ) = min { π ( x ) q ( x , y ) , π ( y ) q ( y , x ) } \pi(x)k(x,y)=\min\{\pi(x)q(x,y),\pi(y)q(y,x)\} π ( x ) k ( x , y ) = min { π ( x ) q ( x , y ) , π ( y ) q ( y , x )} x , y x,y x , y 11.4 から π \pi π
提案密度の選び方で、よく使う形が2つある。
ランダムウォーク Metropolis 法 :提案が対称で q ( x , y ) = q ( y , x ) q(x,y)=q(y,x) q ( x , y ) = q ( y , x ) Y = x + ε Y=x+\varepsilon Y = x + ε ε ∼ N ( 0 , s 2 ) \varepsilon\sim\mathrm N(0,s^2) ε ∼ N ( 0 , s 2 )
α ( x , y ) = min { 1 , π ( y ) / π ( x ) } \alpha(x,y)=\min\{1,\pi(y)/\pi(x)\} α ( x , y ) = min { 1 , π ( y ) / π ( x )}
になる。密度が上がる候補は必ず採択し、下がる候補は比の確率で採択する。2. 独立型 MH 法 :q ( x , y ) = g ( y ) q(x,y)=g(y) q ( x , y ) = g ( y ) w = π / g w=\pi/g w = π / g min { 1 , w ( y ) / w ( x ) } \min\{1,w(y)/w(x)\} min { 1 , w ( y ) / w ( x )}
歩幅の選び方と自己相関
ランダムウォーク Metropolis 法の歩幅 s s s
小さすぎる :候補はほとんど採択されるが1歩の移動が小さく、連鎖は分布の中をゆっくりしか動かない。大きすぎる :候補は分布の裾へ飛ぶのでほとんど棄却され、同じ点にとどまり続ける。
どちらの場合も X t X_t X t X t + 1 X_{t+1} X t + 1 s s s
Gibbs サンプラー
多次元の分布 π ( x 1 , … , x d ) \pi(x_1,\dots,x_d) π ( x 1 , … , x d ) x j x_j x j x − j x_{-j} x − j 完全条件付き分布 π ( x j ∣ x − j ) \pi(x_j\mid x_{-j}) π ( x j ∣ x − j ) Gibbs サンプラー は、成分を1つずつ順に完全条件付き分布から引き直す方法である。2次元なら、現在の ( x 1 ( t ) , x 2 ( t ) ) (x_1^{(t)},x_2^{(t)}) ( x 1 ( t ) , x 2 ( t ) )
x 1 ( t + 1 ) ∼ π ( x 1 ∣ x 2 ( t ) ) , x 2 ( t + 1 ) ∼ π ( x 2 ∣ x 1 ( t + 1 ) ) x_1^{(t+1)}\sim\pi(x_1\mid x_2^{(t)}),\qquad x_2^{(t+1)}\sim\pi(x_2\mid x_1^{(t+1)}) x 1 ( t + 1 ) ∼ π ( x 1 ∣ x 2 ( t ) ) , x 2 ( t + 1 ) ∼ π ( x 2 ∣ x 1 ( t + 1 ) )
の順に更新する。
命題 11.8(成分の更新は π \pi π
( X 1 , X 2 ) ∼ π (X_1,X_2)\sim\pi ( X 1 , X 2 ) ∼ π X 1 X_1 X 1 π ( x 1 ∣ X 2 ) \pi(x_1\mid X_2) π ( x 1 ∣ X 2 ) ( X 1 ′ , X 2 ) (X_1',X_2) ( X 1 ′ , X 2 ) π \pi π
証明 ( X 1 ′ , X 2 ) (X_1',X_2) ( X 1 ′ , X 2 ) X 2 X_2 X 2
π 2 ( x 2 ) π ( x 1 ′ ∣ x 2 ) = π ( x 1 ′ , x 2 ) \pi_2(x_2)\,\pi(x_1'\mid x_2)=\pi(x_1',x_2) π 2 ( x 2 ) π ( x 1 ′ ∣ x 2 ) = π ( x 1 ′ , x 2 )
である。
2つの成分の更新はどちらも π \pi π π \pi π
例題 11.2 2変量正規分布の Gibbs サンプラー ★★
オリジナル 目標分布を、平均 0、分散 1、相関係数 ρ \rho ρ ∣ ρ ∣ < 1 \lvert \rho\rvert <1 ∣ ρ ∣ < 1
完全条件付き分布 X ∣ Y = y X\mid Y=y X ∣ Y = y Y ∣ X = x Y\mid X=x Y ∣ X = x
第1成分の列 X 0 , X 1 , … X_0,X_1,\dots X 0 , X 1 , …
X t + 1 = ρ 2 X t + η t + 1 , η t は独立に N ( 0 , 1 − ρ 4 ) X_{t+1}=\rho^2X_t+\eta_{t+1},\qquad \eta_t\ \text{は独立に}\ \mathrm N(0,1-\rho^4) X t + 1 = ρ 2 X t + η t + 1 , η t は独立に N ( 0 , 1 − ρ 4 )
また、X 0 = x 0 X_0=x_0 X 0 = x 0 X t X_t X t C o v ( X t , X t + k ) = ρ 2 k \mathrm{Cov}(X_t,X_{t+k})=\rho^{2k} Cov ( X t , X t + k ) = ρ 2 k X ˉ N = 1 N ∑ t = 1 N X t \bar X_N=\frac1N\sum_{t=1}^NX_t X ˉ N = N 1 ∑ t = 1 N X t N N N 1 / N 1/N 1/ N
1 + ρ 2 1 − ρ 2 \frac{1+\rho^2}{1-\rho^2} 1 − ρ 2 1 + ρ 2
倍になることを示せ。ρ = 0.9 \rho=0.9 ρ = 0.9
解答 (1) 第4章の2変量正規の条件付き分布から X ∣ Y = y ∼ N ( ρ y , 1 − ρ 2 ) X\mid Y=y\sim\mathrm N(\rho y,1-\rho^2) X ∣ Y = y ∼ N ( ρ y , 1 − ρ 2 ) Y ∣ X = x ∼ N ( ρ x , 1 − ρ 2 ) Y\mid X=x\sim\mathrm N(\rho x,1-\rho^2) Y ∣ X = x ∼ N ( ρ x , 1 − ρ 2 ) Z t , Z t ′ Z_t,Z_t' Z t , Z t ′ N ( 0 , 1 ) \mathrm N(0,1) N ( 0 , 1 )
Y t = ρ X t + 1 − ρ 2 Z t , X t + 1 = ρ Y t + 1 − ρ 2 Z t ′ Y_t=\rho X_t+\sqrt{1-\rho^2}\,Z_t,\qquad X_{t+1}=\rho Y_t+\sqrt{1-\rho^2}\,Z_t' Y t = ρ X t + 1 − ρ 2 Z t , X t + 1 = ρ Y t + 1 − ρ 2 Z t ′
と書ける(Y Y Y X X X
(2) 第1式を第2式に代入すると
X t + 1 = ρ 2 X t + η t + 1 , η t + 1 = ρ 1 − ρ 2 Z t + 1 − ρ 2 Z t ′ X_{t+1}=\rho^2X_t+\eta_{t+1},\qquad \eta_{t+1}=\rho\sqrt{1-\rho^2}\,Z_t+\sqrt{1-\rho^2}\,Z_t' X t + 1 = ρ 2 X t + η t + 1 , η t + 1 = ρ 1 − ρ 2 Z t + 1 − ρ 2 Z t ′
である。η t + 1 \eta_{t+1} η t + 1
ρ 2 ( 1 − ρ 2 ) + ( 1 − ρ 2 ) = ( 1 − ρ 2 ) ( 1 + ρ 2 ) = 1 − ρ 4 \rho^2(1-\rho^2)+(1-\rho^2)=(1-\rho^2)(1+\rho^2)=1-\rho^4 ρ 2 ( 1 − ρ 2 ) + ( 1 − ρ 2 ) = ( 1 − ρ 2 ) ( 1 + ρ 2 ) = 1 − ρ 4
である。η t + 1 \eta_{t+1} η t + 1 X 0 , … , X t X_0,\dots,X_t X 0 , … , X t X t X_t X t ϕ = ρ 2 \phi=\rho^2 ϕ = ρ 2 X 0 = x 0 X_0=x_0 X 0 = x 0
X t = ρ 2 t x 0 + ∑ s = 1 t ρ 2 ( t − s ) η s X_t=\rho^{2t}x_0+\sum_{s=1}^{t}\rho^{2(t-s)}\eta_s X t = ρ 2 t x 0 + s = 1 ∑ t ρ 2 ( t − s ) η s
となり、
X t ∼ N ( ρ 2 t x 0 , ( 1 − ρ 4 ) ∑ j = 0 t − 1 ρ 4 j ) = N ( ρ 2 t x 0 , 1 − ρ 4 t ) X_t\sim\mathrm N\Bigl(\rho^{2t}x_0,\ (1-\rho^4)\sum_{j=0}^{t-1}\rho^{4j}\Bigr)=\mathrm N\bigl(\rho^{2t}x_0,\ 1-\rho^{4t}\bigr) X t ∼ N ( ρ 2 t x 0 , ( 1 − ρ 4 ) j = 0 ∑ t − 1 ρ 4 j ) = N ( ρ 2 t x 0 , 1 − ρ 4 t )
である。t → ∞ t\to\infty t → ∞ N ( 0 , 1 ) \mathrm N(0,1) N ( 0 , 1 ) ρ 2 t \rho^{2t} ρ 2 t
(3) 定常状態では V [ X t ] = 1 V[X_t]=1 V [ X t ] = 1 X t + k = ρ 2 k X t + ( 独立な項 ) X_{t+k}=\rho^{2k}X_t+(\text{独立な項}) X t + k = ρ 2 k X t + ( 独立な項 ) X t X_t X t
C o v ( X t , X t + k ) = ρ 2 k V [ X t ] = ρ 2 k \mathrm{Cov}(X_t,X_{t+k})=\rho^{2k}V[X_t]=\rho^{2k} Cov ( X t , X t + k ) = ρ 2 k V [ X t ] = ρ 2 k
となる。ϕ = ρ 2 \phi=\rho^2 ϕ = ρ 2
V [ X ˉ N ] = 1 N 2 ∑ s = 1 N ∑ t = 1 N ϕ ∣ s − t ∣ = 1 N 2 { N + 2 ∑ k = 1 N − 1 ( N − k ) ϕ k } = 1 N { 1 + 2 ∑ k = 1 N − 1 ( 1 − k N ) ϕ k } . V[\bar X_N]=\frac1{N^2}\sum_{s=1}^N\sum_{t=1}^N\phi^{\lvert s-t\rvert }=\frac1{N^2}\Bigl\{N+2\sum_{k=1}^{N-1}(N-k)\phi^k\Bigr\}
=\frac1N\Bigl\{1+2\sum_{k=1}^{N-1}\Bigl(1-\frac kN\Bigr)\phi^k\Bigr\}. V [ X ˉ N ] = N 2 1 s = 1 ∑ N t = 1 ∑ N ϕ ∣ s − t ∣ = N 2 1 { N + 2 k = 1 ∑ N − 1 ( N − k ) ϕ k } = N 1 { 1 + 2 k = 1 ∑ N − 1 ( 1 − N k ) ϕ k } .
N → ∞ N\to\infty N → ∞ ∑ k k ϕ k / N → 0 \sum_k k\phi^k/N\to0 ∑ k k ϕ k / N → 0
1 + 2 ϕ 1 − ϕ = 1 + ϕ 1 − ϕ 1+\frac{2\phi}{1-\phi}=\frac{1+\phi}{1-\phi} 1 + 1 − ϕ 2 ϕ = 1 − ϕ 1 + ϕ
したがって
V [ X ˉ N ] ≈ 1 N ⋅ 1 + ρ 2 1 − ρ 2 V[\bar X_N]\approx\frac1N\cdot\frac{1+\rho^2}{1-\rho^2} V [ X ˉ N ] ≈ N 1 ⋅ 1 − ρ 2 1 + ρ 2
である。ρ = 0.9 \rho=0.9 ρ = 0.9 ( 1 + 0.81 ) / ( 1 − 0.81 ) = 1.81 / 0.19 ≈ 9.53 (1+0.81)/(1-0.81)=1.81/0.19\approx9.53 ( 1 + 0.81 ) / ( 1 − 0.81 ) = 1.81/0.19 ≈ 9.53 N N N N / 9.53 N/9.53 N /9.53
この N ( 1 − ϕ ) / ( 1 + ϕ ) N(1-\phi)/(1+\phi) N ( 1 − ϕ ) / ( 1 + ϕ ) 有効標本サイズ と呼ぶ。成分間の相関が強い分布では、Gibbs サンプラーの1歩の動きが小さくなる。
確認テスト
オリジナル
11.1-1 U ∼ U ( 0 , 1 ) U\sim\mathrm U(0,1) U ∼ U ( 0 , 1 ) X = − λ − 1 log U X=-\lambda^{-1}\log U X = − λ − 1 log U E x ( λ ) \mathrm{Ex}(\lambda) Ex ( λ ) F − 1 ( U ) F^{-1}(U) F − 1 ( U ) 11.1-2 密度 f ( x ) = 6 x ( 1 − x ) ( 0 < x < 1 ) f(x)=6x(1-x)\ (0<x<1) f ( x ) = 6 x ( 1 − x ) ( 0 < x < 1 ) B e t a ( 2 , 2 ) \mathrm{Beta}(2,2) Beta ( 2 , 2 ) U ( 0 , 1 ) \mathrm U(0,1) U ( 0 , 1 ) M M M 11.1-3 状態 1, 2 の2状態マルコフ連鎖の推移確率行列を
P = ( 1 − a a b 1 − b ) ( 0 < a , b < 1 ) P=\begin{pmatrix}1-a&a\\ b&1-b\end{pmatrix}\qquad(0<a,b<1) P = ( 1 − a b a 1 − b ) ( 0 < a , b < 1 )
とする。定常分布 π \pi π P n P^n P n π \pi π ∣ 1 − a − b ∣ n \lvert 1-a-b\rvert ^n ∣ 1 − a − b ∣ n 11.1-4 2次元の目標分布 π ( x 1 , x 2 ) \pi(x_1,x_2) π ( x 1 , x 2 )
q ( ( x 1 , x 2 ) , ( y 1 , x 2 ) ) = π ( y 1 ∣ x 2 ) q((x_1,x_2),(y_1,x_2))=\pi(y_1\mid x_2) q (( x 1 , x 2 ) , ( y 1 , x 2 )) = π ( y 1 ∣ x 2 )
とする。採択確率 (11.6) が常に 1 になることを示せ。5. 11.1-5 Z ∼ N ( 0 , 1 ) Z\sim\mathrm N(0,1) Z ∼ N ( 0 , 1 ) p = P ( Z > 2 ) p=P(Z>2) p = P ( Z > 2 ) N N N p p p N N N p = 0.02275 p=0.02275 p = 0.02275
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com