相対エントロピーから情報と物理を組み立てる 第1部 第2章 §1.2.5 ★★★ 真の分布 p の系列を別の分布 q で評価すると、1文字あたりの驚きは H(p)+D(p∥q) に集まる。この巻で D が最初に現れる場所
比べる2つの分布
ここまでは、系列を生む分布と、驚きを計算する分布が同じ p だった。実際には、情報源の本当の分布 p は分からず、手元のモデル q で確率を見積もることが多い。たとえば英文の圧縮器は、英文の文字の頻度について何らかの仮定 q を持って符号を作る。このとき、p から出た系列を q で評価した1文字あたりの驚き−n1lnqn(Xn) がどこへ集まるかを調べる。この節が比べる2つの分布は、真の分布 p と仮定した分布 q である。
定理 1.2.8(取り違えた分布での AEP ★★★)
X1,X2,… は分布 p に従う独立同分布とし、p(x)>0 となる x では q(x)>0 とする。このとき、n→∞ で確率収束の意味で
−n1lnqn(Xn) ⟶ −x∑p(x)lnq(x)=H(p)+D(p∥q).(1.2.15)
証明
−n1lnqn(Xn)=n1∑i(−lnq(Xi)) は、独立同分布の確率変数 −lnq(Xi) の標本平均である。p のもとでの期待値は −∑xp(x)lnq(x) で、有限のアルファベットで q>0 の範囲だけを見ているので分散も有限である。大数の弱法則から確率収束する。期待値は−∑plnq=−∑plnp+∑pln(p/q)=H(p)+D(p∥q) と分けられる。
右辺の −∑xp(x)lnq(x) を交差エントロピーと呼ぶ(機械学習の損失関数の名前でもある)。式 (1.2.15) は、分布を取り違えると平均の驚きが D(p∥q) だけ増えることを言っている。q=u なら −∑plnu=ln∣X∣ なので、式 (1.2.6) に戻る。次の章で示す D(p∥q)≥0(等号は q=p のときに限る)を使うと、交差エントロピーを最小にする q は真の分布 p そのものである。平均して最も驚かずに済むのは、正しい分布で予想したときに限る。この性質が、最尤推定(第1部第7章)と最大エントロピー原理(第2部第1章)の両方の出発点になる。
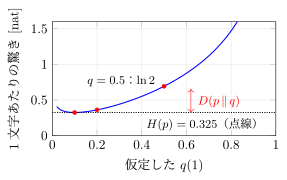
図 1.2.4 真の分布 p(1)=0.1 の系列を q で評価したときの、1文字あたりの驚きの収束先 H(p)+D(p∥q)(実線)。q=p で最小値 H(p)(点線)に接し、そこからの高さが D(p∥q) である。
q のもとで p の典型集合が出る確率
取り違えた結果をもう1つの向きから見る。p の典型集合 Aϵ(n) に入る系列が、q のもとでどれくらいの確率で出るかを考える。p にとって典型で、しかも q で評価した驚きも式 (1.2.15) の値に近い系列の集合を
Bϵ(n)={xn∈Aϵ(n): −n1lnqn(xn)−H(p)−D(p∥q)≤ϵ}
とする。定理 1.2.8 から p のもとでの確率は n→∞ で 1 に近づき、元の数は ∣Aϵ(n)∣≤en(H+ϵ) 以下である。Bϵ(n) の元の q のもとでの確率は e−n(H+D−ϵ) 以下なので
qn(Bϵ(n))≤en(H+ϵ)e−n(H+D−ϵ)=e−n(D(p∥q)−2ϵ)(1.2.16)
となる。p から出たように見える系列を q が出す確率は、n について e−nD(p∥q) の速さで小さくなる。下からも同じ指数で押さえられることは定理 1.2.6 (c) と同じ手順で示せる。2つの仮説 p,q のどちらから出た系列かを判定するとき、誤って q を p と見なす確率の減り方の指数が D である、という Stein の補題の中身がこれで、第1部第8章で正確に述べる。
例題 1.2.5 公平な硬貨と思い込んだときの損 ★★
オリジナル真の分布は p(1)=0.1 の2値の情報源とする。
- (1) q(1)=0.5(公平な硬貨)と仮定したとき、1文字あたりの驚きの収束先と D(p∥q) を nat で求めよ。
- (2) q(1)=0.2 と仮定したときについて同じものを求めよ。
- (3) (1) の D を使って、n=100 のとき公平な硬貨が p の典型系列を出す確率の指数を見積もり、例題 1.2.4 (2) の割合と比べよ。
解答
(1) どの系列も qn(xn)=2−n なので、1文字あたりの驚きは系列によらず ln2≈0.6931 nat である。D(p∥q)=ln2−H(p)≈0.6931−0.3251=0.3681 nat。序章の例題 1.1.1 と同じ組(0 と 1 の呼び方を入れ替えただけ)で、同じ値になる。公平な硬貨を仮定すると、2値の系列には1文字 1 ビットの符号が要り、真の分布を知っていれば 0.469 ビットで済むところを 0.531 ビット余分に使う。
(2) −0.1ln0.2−0.9ln0.8≈0.1609+0.2008=0.3618 nat。D(p∥q)=0.1ln0.20.1+0.9ln0.80.9≈0.0367 nat で、収束先は 0.3251+0.0367=0.3618 と一致する。真の値に近い q ほど余分な驚きは小さい。
(3) 式 (1.2.16) から、指数はおよそ −nD=−36.8 である。例題 1.2.4 (2) の割合 9.6×10⁻¹⁶ の対数は −34.6 で、指数の主要部が一致する。公平な硬貨のもとではすべての系列が等確率なので、qn(Aϵ(n)) は典型集合が全系列に占める割合そのものになる。差の 2.2 は、n=100 で n1ln∣Aϵ(n)∣ がまだ H から 0.022 ずれていることに由来する(ϵ の範囲内のずれ)。
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com
