比べる2つの分布:知っていることを満たす分布と参照分布
AI 生成・木下が未勉強
相対エントロピーから情報と物理を組み立てる 第2部 第1章 §2.1.1 ★★★ 部分的な知識を「期待値の拘束」として書き、拘束を満たす分布のうち参照分布に最も近いものを選ぶ、という問題を立てる
統計力学の教科書は、カノニカル分布 を「系と熱浴を合わせた全体の等重率」から導く。この章では同じ分布を、まったく別の問いの答えとして導く。その問いは「系について平均エネルギーしか知らないとき、どの確率分布を使って予言するのが正しいか」である。E. T. Jaynes はこの問いに、知っていることを満たす分布のうち Shannon エントロピーが最大のものを使え、と答えた1E. T. Jaynes (1957), Phys. Rev. 106, 620–630。下の脚注へ。これが最大エントロピー原理である。
この巻の言葉では、Shannon エントロピーを最大にすることは一様分布に対する相対エントロピーを最小にすることと同じである(第1部第1章)。したがってこの章で比べる2つの分布は、「知っていることを満たす分布 」と「何も知らないときに使う参照分布 」であり、当てる性質は の非負性である。2.1.1節で問題を立て、2.1.2節で解が指数型の分布になり、しかも一意であることを、 の Pythagoras の等式から示す。2.1.3節で拘束を平均エネルギーに選ぶとカノニカル分布と温度が出ることを、2.1.4節で粒子数・占有数・連続変数へ広げるとグランドカノニカル分布・Fermi 分布と Bose 分布・Maxwell 分布が出ることを示す。2.1.5節では、この推論がなぜ当たるのかを数え上げで確かめる。拘束を満たす標本の経験分布は、標本の数が大きいと最大エントロピーの分布に集中する。2.1.6節で統計力学の授業の導き方(系と熱浴・最も確からしい分布)と統計学の最尤推定に対応させ、2.1.7節でまとめる。
この章の対数はすべて自然対数で、Shannon エントロピー の単位は nat である。熱力学のエントロピーは とする。相空間の上の力学から同じ分布を導く読み方は 解析力学から様々な理論分野を組み立てる 第3部第3章 にあり、この章はその情報の側の対である。
部分的な知識を拘束として書く
有限個の値をとる確率変数 (値の集合 )について、いくつかの関数 の期待値だけが分かっているとする。
を拘束を満たす分布の集合と呼ぶ。サイコロなら で「出目の平均が 」、熱浴と接した系なら で「平均エネルギーが 」である。 には普通、無数の分布が入っている。予言に使う分布を1つに決めるには、何か別の基準が要る。
Jaynes の答えは、 の中で Shannon エントロピー が最大の分布を選ぶことである。理由は次のとおりである。 は、 の値を知ったときの驚きの平均で、分布 を使う人がまだ知らないことの量である(第1部第2章)。 の中で が小さい分布を選ぶと、拘束からは出てこない何かを知っていると仮定したことになる。 が最大の分布は、拘束に書いたこと以外は何も仮定しない分布である。
参照分布との相対エントロピーで言い直す
値が 個のとき、一様分布 に対する相対エントロピーは
である(第1部第1章)。 は によらないので、 を最大にすることと を最小にすることは同じである。一様分布は「拘束を知る前に使っていた分布」とみなせる。最大エントロピー原理は、拘束を知る前の分布から、拘束を満たす範囲でできるだけ動かない分布を選ぶ規則と読める。
この読み方をすると、一様分布でない参照分布 を使う一般化がすぐに書ける。
を最小相対エントロピー原理と呼ぶ2S. Kullback (1959), Information Theory and Statistics (Wiley) が「最小判別情報」の名で導入した。J. E. Shore and R. W. Johnson (1980), IEEE Trans. Inf. Theory 26, 26–37 は、推論の一貫性についてのいくつかの公理から、拘束を取り入れる規則がこの形に限られることを示した。下の脚注へ。 が一様分布のとき最大エントロピー原理に戻る。比べる2つの分布は、拘束を満たす と、拘束を知る前の である。 は「何も知らないときに、どの値を同じ重みで数えるか」を決める分布で、連続変数ではこの選び方が物理の中身になる(2.1.4節)。
の向き
式 (2.1.3) では、動かす分布 が左の引数にある。 は「 が正しいとき、 と見分ける手がかり」の量なので、これを最小にすることは「拘束を満たす分布のうち、参照分布と最も見分けにくいもの」を選ぶことになる。逆向きの を最小にすると、拘束を満たす指数型の分布でなく、別の分布が出る(例題 2.1.1 の後の注意)。2.1.5節で示すように、標本の数え上げから自然に出てくるのは左に を置く向きである。
サイコロの例
出目 のサイコロについて、「多数回振ったときの出目の平均が だった」とだけ聞いたとする。 には、 だけが出るサイコロ、 と が半々のサイコロなど、無数の分布が入る。最大エントロピーの分布は次の節の一般論で の形になり、 は平均が になるように決まる。図 2.1.1 に、平均を , , , と変えたときの最大エントロピーの分布を示す。平均が のときは拘束から何も分からないのと同じで、一様分布に戻る。平均が より大きいと となり、大きい目ほど確率が高い。平均 と平均 の分布は互いに左右を裏返したもので、 の符号だけが違う。
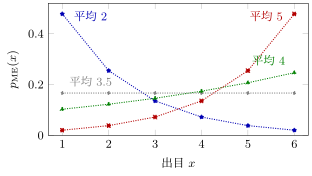
図 2.1.1 サイコロの出目の平均だけが分かっているときの最大エントロピーの分布 。平均 , , , のとき , , , 。どれも厳密な値で、点は verify_ch2-01.py で計算した。
例題 2.1.1 平均が のサイコロ ★★★
オリジナル出目の平均が であることだけが分かっているサイコロを考える。
- (1) ()とおいて、平均が になる を求める方程式を書け。数値で解いて , と分布を求めよ。
- (2) この分布の を求め、一様分布の と比べよ。 だけが出る分布、 と が半々の分布の とも比べよ。
解答
(1) 平均は で、分母を払うと
の項は係数 で消えた。 で割ると で、左辺は で 、 で と符号を変える。二分法で 、 を得る。分布は
で、目が1つ増えるごとに確率が 倍になる。
(2) nat で、一様分布の nat より nat だけ小さい。この差が、平均が と知ったことで減った「知らないことの量」である。 だけが出る分布は 、 と が半々の分布は で、どちらも平均 を満たすが、拘束にない「 しか出ない」「 と しか出ない」という知識を仮定している。
逆向きの を最小にすると
の中で ( は一様分布)を最小にすると、未定乗数の条件は 、すなわち になり、指数型にならない。2つの独立な系を並べたとき、最大エントロピーの分布は積 になる(指数関数の積は指数関数)が、この形は積に分かれない。物理の予言として使うには、独立な系の分布が積に分かれることが要る。Shore と Johnson の公理にもこの要請が入っている。
1 E. T. Jaynes (1957), Phys. Rev. 106, 620–630。
2 S. Kullback (1959), Information Theory and Statistics (Wiley) が「最小判別情報」の名で導入した。J. E. Shore and R. W. Johnson (1980), IEEE Trans. Inf. Theory 26, 26–37 は、推論の一貫性についてのいくつかの公理から、拘束を取り入れる規則がこの形に限られることを示した。
木下の勉強ステータス
木下はまだこの記事を勉強していません。
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com
← AI生成教科書『虎の巻』の記事一覧へ