tecktom.com

当てる D の性質:Fokker–Planck の流れは D を減らす

2026年10月15日9分で読めますAI生成教科書『虎の巻』第4部 第1章 確率熱力学の入口
目次
  1. データ処理不等式からの見方
  2. 減る速さ=エントロピー生成の速さ
  3. 木下の層

AI 生成・木下が未勉強

相対エントロピーから情報と物理を組み立てる 第4部 第1章 §4.1.2 ★★★ 設定を止めると D(pt ∥ πλ)D(p_t\,\|\,\pi_\lambda) は単調に減り、減る速さは確率の流れの2乗の平均=エントロピー生成の速さ Σ˙≥0\dot\Sigma\ge0 に等しい

データ処理不等式からの見方

設定 λ\lambda を止めて時間 τ\tau だけ待つ操作は、時刻 tt の分布を時刻 t+τt+\tau の分布へ移す確率の核 Kτ(x′ ∣ x)K_\tau(x'\,|\,x) で書ける。Kτ(x′∣x)K_\tau(x'|x) は、位置 xx から出発した粒子が時間 τ\tau 後に x′x' にいる確率密度で、pt+τ(x′)=∫Kτ(x′∣x) pt(x) dxp_{t+\tau}(x')=\int K_\tau(x'|x)\,p_t(x)\,\mathrm{d} x である。これは第1部第1章の確率行列(通信路)WW の連続版で、しかも平衡分布を動かさない(∫Kτ(x′∣x)πλ(x) dx=πλ(x′)\int K_\tau(x'|x)\pi_\lambda(x)\,\mathrm{d} x=\pi_\lambda(x'))。データ処理不等式(第1部第1章・第1部第4章)を ptp_t と πλ\pi_\lambda の組に当てると

D(pt+τ ∥ πλ)=D(Kτpt ∥ Kτπλ)≤D(pt ∥ πλ)(4.1.9)D(p_{t+\tau}\,\|\,\pi_\lambda)=D(K_\tau p_t\,\|\,K_\tau\pi_\lambda)\le D(p_t\,\|\,\pi_\lambda)\tag{4.1.9}

になる。設定を止めている限り、今の分布と平衡分布の DD は時間とともに減ることはあっても増えることはない。これが第1部第1章の「等温の第二法則」の連続版である。式 (4.1.9) から分かるのは減るという向きだけで、減る量までは分からない。減る速さは Fokker–Planck 方程式から直接計算することができる。

減る速さ=エントロピー生成の速さ

定理 4.1.1(DD の減る速さ ★★★)

設定 λ\lambda を止めたとき、ptp_t が式 (4.1.2) に従い、無限遠で pp と jj が十分速く0になるなら

ddtD(pt ∥ πλ)=−Σ˙,Σ˙≔γkBT∫j(x,t)2p(x,t) dx=kBTγ∫p (∂xln⁡pπλ)2dx ≥0.(4.1.10)\frac{\mathrm{d} }{\mathrm{d} t}D(p_t\,\|\,\pi_\lambda)=-\dot\Sigma,\qquad \dot\Sigma\coloneqq\frac{\gamma}{ k_{\mathrm B} T}\int\frac{j(x,t)^2}{p(x,t)}\,\mathrm{d} x=\frac{ k_{\mathrm B} T}{\gamma}\int p\,\Bigl(\partial_x\ln\frac{p}{\pi_\lambda}\Bigr)^2\mathrm{d} x\ \ge0 .\tag{4.1.10}

等号は pt=πλp_t=\pi_\lambda のときに限る。

証明

πλ\pi_\lambda は時間によらないので、∫∂tp dx=0\int\partial_tp\,\mathrm{d} x=0 を使って

ddtD=∫∂tp (ln⁡pπλ+1)dx=−∫∂xj ln⁡pπλ dx=∫j ∂xln⁡pπλ dx\frac{\mathrm{d} }{\mathrm{d} t}D=\int\partial_tp\,\Bigl(\ln\frac{p}{\pi_\lambda}+1\Bigr)\mathrm{d} x=-\int\partial_xj\,\ln\frac{p}{\pi_\lambda}\,\mathrm{d} x=\int j\,\partial_x\ln\frac{p}{\pi_\lambda}\,\mathrm{d} x

となる(最後は部分積分で、端の項は無限遠で0)。式 (4.1.4) から ∂xln⁡(p/πλ)=−γj/(kBT p)\partial_x\ln(p/\pi_\lambda)=-\gamma j/( k_{\mathrm B} T\,p) なので、右辺は −γkBT∫j2/p dx-\frac{\gamma}{ k_{\mathrm B} T}\int j^2/p\,\mathrm{d} x になる。2つ目の形は式 (4.1.4) を逆に入れたものである。被積分関数は非負で、0になるのは p/πλp/\pi_\lambda が xx によらない、つまり p=πλp=\pi_\lambda のときに限る。

Σ˙\dot\Sigma はエントロピー生成の速さで、4.1.4 節で設定を動かす場合にもこの量がそのまま第二法則の余りになる。2つ目の形の積分 ∫p (∂xln⁡(p/π))2 dx\int p\,(\partial_x\ln(p/\pi))^2\,\mathrm{d} x は相対 Fisher 情報と呼ばれ、パラメータの代わりに位置 xx で微分した Fisher 情報(第1部第7章)の形をしている。定理 4.1.1 の内容を言葉にすると、平衡分布との DD は、2つの分布の対数の比の傾きが残っている限り減り続ける、ということになる。Σ˙\dot\Sigma は確率の流れの2乗に比例するので、流れが止まらない限り DD は減る。

図

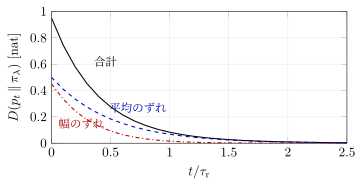
図 4.1.1 調和ばねの中での緩和(例題 4.1.2)。初めの分布は平均が σeq\sigma_{\mathrm{eq}} だけずれ、分散が平衡の3倍である。黒の実線が D(pt ∥ πλ)D(p_t\,\|\,\pi_\lambda)、青の破線が平均のずれの項 12e−2t/τr\frac12\mathrm{e}^{-2t/\tau_{\mathrm r}}、赤の一点鎖線が幅のずれの項。どれも厳密な式から描いた。幅のずれの項は遅い時刻で e−4t/τr\mathrm{e}^{-4t/\tau_{\mathrm r}} のように減り、平均のずれの項より速く消える。

例題 4.1.2 調和ばねの中の緩和で DD と Σ˙\dot\Sigma を比べる ★★

オリジナル調和ばね U=k2(x−λ)2U=\frac k2(x-\lambda)^2 の設定を止め、初めの分布を平均 λ+σeq\lambda+\sigma_{\mathrm{eq}}・分散 3σeq23\sigma_{\mathrm{eq}}^2 の正規分布とする。τr=γ/k\tau_{\mathrm r}=\gamma/k とおく。

  1. (1) 平均 m(t)m(t) と分散 σ2(t)\sigma^2(t) の時間発展を求めよ。
  2. (2) D(pt ∥ πλ)D(p_t\,\|\,\pi_\lambda) を t=0t=0 と t=τrt=\tau_{\mathrm r} で求めよ。
  3. (3) 式 (4.1.10) の Σ˙\dot\Sigma を正規分布について計算し、t=τrt=\tau_{\mathrm r} での値を −dD/dt-\mathrm{d} D/\mathrm{d} t と比べよ。
解答

(1) 式 (4.1.1) の平均をとると γm˙=−k(m−λ)\gamma\dot m=-k(m-\lambda) なので m−λ=σeqe−t/τrm-\lambda=\sigma_{\mathrm{eq}}\mathrm{e}^{-t/\tau_{\mathrm r}} である。分散は d(x−m)2\mathrm{d}(x-m)^2 の平均から dσ2dt=−2kγσ2+2kBTγ\frac{\mathrm{d} \sigma^2}{\mathrm{d} t}=-\frac{2k}{\gamma}\sigma^2+\frac{2 k_{\mathrm B} T}{\gamma} で、s=σ2/σeq2s=\sigma^2/\sigma_{\mathrm{eq}}^2 は s˙=−2τr(s−1)\dot s=-\frac{2}{\tau_{\mathrm r}}(s-1)、つまり s(t)=1+2e−2t/τrs(t)=1+2\mathrm{e}^{-2t/\tau_{\mathrm r}} である。分布は正規分布のまま、平均は e−t/τr\mathrm{e}^{-t/\tau_{\mathrm r}}、幅のずれは e−2t/τr\mathrm{e}^{-2t/\tau_{\mathrm r}} で戻る。

(2) 式 (4.1.8) で、t=0t=0 は 12+12(3−1−ln⁡3)=0.500+0.451=0.951\frac12+\frac12(3-1-\ln3)=0.500+0.451=0.951 nat である。t=τrt=\tau_{\mathrm r} では平均の項が 12e−2=0.0677\frac12\mathrm{e}^{-2}=0.0677、幅の項が s=1+2e−2=1.271s=1+2\mathrm{e}^{-2}=1.271 で 12(s−1−ln⁡s)=0.0156\frac12(s-1-\ln s)=0.0156 なので、合計 0.08320.0832 nat である(図 4.1.1)。

(3) ∂xln⁡(p/πλ)=−(x−m)/σ2+(x−λ)/σeq2\partial_x\ln(p/\pi_\lambda)=-(x-m)/\sigma^2+(x-\lambda)/\sigma_{\mathrm{eq}}^2 で、その2乗の平均は σ2(1/σ2−1/σeq2)2+(m−λ)2/σeq4\sigma^2(1/\sigma^2-1/\sigma_{\mathrm{eq}}^2)^2+(m-\lambda)^2/\sigma_{\mathrm{eq}}^4 である。kBT/γ=σeq2/τrk_{\mathrm B} T/\gamma=\sigma_{\mathrm{eq}}^2/\tau_{\mathrm r} を掛けると

Σ˙=1τr[(s−1)2s+(m−λ)2σeq2].\dot\Sigma=\frac{1}{\tau_{\mathrm r}}\Bigl[\frac{(s-1)^2}{s}+\frac{(m-\lambda)^2}{\sigma_{\mathrm{eq}}^2}\Bigr].

一方、(1) から平均の項 (m−λ)22σeq2\frac{(m-\lambda)^2}{2\sigma_{\mathrm{eq}}^2} の時間微分は −(m−λ)2τrσeq2-\frac{(m-\lambda)^2}{\tau_{\mathrm r}\sigma_{\mathrm{eq}}^2}、幅の項の時間微分は 12(1−1/s)s˙=−(s−1)2τrs\frac12(1-1/s)\dot s=-\frac{(s-1)^2}{\tau_{\mathrm r}s} で、和は確かに −Σ˙-\dot\Sigma に等しい。t=τrt=\tau_{\mathrm r} では (s−1)2/s=0.0577(s-1)^2/s=0.0577、(m−λ)2/σeq2=e−2=0.1353(m-\lambda)^2/\sigma_{\mathrm{eq}}^2=\mathrm{e}^{-2}=0.1353 なので Σ˙=0.193/τr\dot\Sigma=0.193/\tau_{\mathrm r} である。

木下の勉強ステータス

木下はまだこの記事を勉強していません。

AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com

← AI生成教科書『虎の巻』の記事一覧へ