数理統計 第10章 §10.1 ★★ 損失・リスク・優越・許容性の定義。リスクは θ の関数なので、一様に最良な推定量は一般に存在しない
第6章では、最尤法やモーメント法で推定量を作り、不偏性・一致性・Cramér–Rao の下界で評価した。この章では評価の側を一般化する。
推定量 δ(X) が真の値 θ からずれたときの損を、関数で表す。その期待値(リスク)を θ の関数として比べる。リスクは θ の関数なので、2つの推定量のどちらが良いかは一般に θ によって入れ替わる。
そこで比べ方を4つ用意する。
- 推定量の範囲を不偏推定量に限る(§10.2)。
- 変換に対して素直にふるまう同変推定量に限る(§10.3)。
- リスクを事前分布で平均する(§10.4)。
- リスクの最大値で比べる(§10.5)。
1級の統計数理では、この章の道具は次の2つの形で問われる。
- 完備十分統計量を見つけ、簡単な不偏推定量をそれで条件付けて一様最小分散不偏推定量(UMVUE)を作り、その分散を計算する。
- 共役事前分布から事後分布を書き、2乗損失のベイズ推定量(事後平均)を出す。そのリスク関数を計算し、リスクが θ によらなくなる超母数を選んでミニマックス推定量を得る。
どちらも定義を書いて積分や和を最後まで計算する問題で、結果の暗記では点にならない。この章の定理はすべて証明つきで書き、各節の例題でその計算を1回通しで行う。
損失関数とリスク関数
観測 X=(X1,…,Xn) の分布が未知の母数 θ∈Θ で定まっているとする。θ やその関数 g(θ) を推定する関数を推定量と呼ぶ。推定量は δ(X) と書く。
推定値が d で真の値が θ のときの損を、非負の関数で表す。これを損失関数と呼び、L(θ,d) と書く。本書では尤度を L(θ) と書くので、損失関数には筆記体を使う。
定義 10.1(損失関数とリスク関数)
損失関数 L(θ,d)≥0 のもとで、推定量 δ のリスク関数を
R(θ,δ)=Eθ[L(θ,δ(X))](10.1)
で定める。Eθ は、母数が θ のときの分布による期待値である。代表的な損失関数は次の3つである。
L(θ,d)L(θ,d)L(θ,d)=(d−θ)2=w(θ)(d−θ)2=∣d−θ∣(2乗損失),(重み付き2乗損失),(絶対損失).
2乗損失のリスクは平均2乗誤差(MSE)そのもので、分散と偏りの2乗に分かれる。
命題 10.2(MSE の分解 ★★★)
δ の分散が有限なら、偏り b(θ)=Eθ[δ]−θ を使って
Eθ[(δ−θ)2]=Vθ[δ]+b(θ)2.(10.2)
証明
m=Eθ[δ] とおき、δ−θ=(δ−m)+(m−θ) と分ける。2乗して期待値をとると
Eθ[(δ−θ)2]=Eθ[(δ−m)2]+2(m−θ)Eθ[δ−m]+(m−θ)2
となる。中央の項は Eθ[δ−m]=0 によって消える。第1項が Vθ[δ]、第3項が b(θ)2 である。
優越と許容性
定義 10.3(優越・許容的・非許容的)
推定量 δ1 が推定量 δ2 を優越するとは、次の2条件が成り立つことをいう。
- すべての θ∈Θ で R(θ,δ1)≤R(θ,δ2) が成り立つ。
- 少なくとも1つの θ で不等号が狭義になる。
δ を優越する推定量が存在しないとき、δ は許容的(admissible)であるという。許容的でない推定量を非許容的という。
非許容的な推定量は、どの θ でもリスクが下がる取り替え先があるので、使う理由が無い。逆に、許容的であることは良い推定量の最低条件にすぎない。次の例がそれを示す。
定数推定量
θ0 を1つ決め、データを見ずに δ≡θ0 と答える推定量を考える。2乗損失のリスクは (θ0−θ)2 である。これは θ=θ0 では 0 になる。どの推定量もリスクは 0 以上なので、θ=θ0 でこれより小さいリスクを持つ推定量は無い。
したがって、すべての θ で同時にリスクが最小となる推定量 δ∗ があるとする。それはどの θ0 でも R(θ0,δ∗)=0 を満たさなければならない。これは観測から θ が誤差なしに分かることを意味し、普通の統計モデルでは起こらない。
一様に最良な推定量は一般に存在しない。そこで、比べる推定量の範囲を狭めるか(不偏推定量・同変推定量)、リスク関数を1つの数にまとめて比べるか(事前分布での平均・最大値)のどちらかを選ぶ。前者が §10.2 と §10.3、後者が §10.4 と §10.5 の内容である。
正規分布の分散を定数倍の族で比べる
不偏性にこだわるとリスクの意味で損をすることがある。正規母集団の分散を例に、そのことを計算で確かめる。X1,…,Xn が独立に N(μ,σ2) に従い、母数はともに未知とする。偏差平方和を
Q=i=1∑n(Xi−Xˉ)2
と書く(本書の記号では S2=Q/(n−1) である)。第5章で導いたとおり Q/σ2∼χn−12 なので、
E[Q]=(n−1)σ2,V[Q]=2(n−1)σ4
である。
例題 10.1 分散の推定量 cQ の MSE ★★★
オリジナル
上の設定で、正の定数をかけた推定量 δc=cQ を考える。これらを2乗損失 (d−σ2)2 で比べる。
- R(σ2,δc) を c,n,σ2 で表せ。
- リスクを最小にする c を求め、そのときのリスクを求めよ。
- 不偏分散 S2 と最尤推定量のリスクを求めよ。それぞれ c=1/(n−1) と c=1/n に当たる。3つの大小を比べよ。S2 は許容的か。
解答
(1) 命題 10.2 より
R(σ2,δc)=c2V[Q]+(cE[Q]−σ2)2=σ4{2(n−1)c2+((n−1)c−1)2}=σ4{(n−1)(n+1)c2−2(n−1)c+1}.
(2) 波括弧の中は c の2次式で、c2 の係数が正である。c で微分して 0 とおくと
2(n−1)(n+1)c−2(n−1)=0,すなわちc∗=n+11
である。代入すると
R(σ2,δc∗)=σ4{n+1n−1−n+12(n−1)+1}=n+12σ4.
(3) 2つの c を代入すると
c=n−11c=n1:σ4{n−1n+1−2+1}=n−12σ4,:σ4{n2n2−1−n2(n−1)+1}=n2σ4(2n−1)
である。n≥2 で
n+12<n22n−1<n−12
が成り立つ。左右の不等号はそれぞれ次と同値である。
2n2<(2n−1)(n+1)=2n2+n−1,(2n−1)(n−1)=2n2−3n+1<2n2.
3つのリスクはどれも σ4 の定数倍なので、この大小はすべての母数の値で成り立つ。したがって Q/(n+1) は S2 を優越する。2乗損失のもとで S2 は非許容的である。
Q/(n+1) は偏りを持つが、分散を小さくした分だけ MSE が下がる。この例は「不偏性」と「リスクが小さいこと」が別の要請であることを示している。
二項分布の比率を縮小推定量で比べる
X∼Bin(n,p) から p を推定する。標本比率 X/n のほかに、a≥0 として
δa=n+2aX+a
を考える。これは X/n を 1/2 の方へ寄せた推定量である。a=1 のときは Laplace の推定量 (X+1)/(n+2) になる。
例題 10.2 リスクが p によらない縮小推定量 ★★★
オリジナル
2乗損失のもとで次に答えよ。
- R(p,δa) を求めよ。
- リスクが p によらなくなる a を求めよ。そのときのリスクを求めよ。
- max0≤p≤1R(p,X/n) と (2) のリスクを比べよ。
解答
(1) E[X]=np、V[X]=np(1−p) である。これより、δa の偏りと分散は
n+2anp+a−p=n+2aa(1−2p),(n+2a)2np(1−p)
である。命題 10.2 より
R(p,δa)=(n+2a)2np(1−p)+a2(1−2p)2.
(2) 分子を p について展開すると
np−np2+a2(1−4p+4p2)=a2+(n−4a2)p+(4a2−n)p2
となる。これが p によらないのは 4a2=n のときである。すなわち a=n/2 である。そのとき分子は n/4 で、
R(p,δn/2)=(n+n)2n/4=4(n+1)21.
(3) 標本比率のリスクは R(p,X/n)=p(1−p)/n である。これは p=1/2 で最大値 1/(4n) をとる。(n+1)2>n なので
4(n+1)21<4n1
であり、最大リスクは δn/2 の方が小さい。ただし p が 0 や 1 に近いところでは X/n のリスクの方が小さい(図 10.1)。
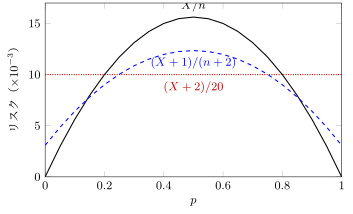
図 10.1 n=16 の二項分布で p を推定するときの2乗損失のリスク。実線が標本比率、破線が Laplace の推定量、点線が例題 10.2 の a=n/2=2 の推定量(リスクは一定で 0.01)。どの曲線も他を一様には下回らない
図 10.1 の3本の曲線はどれも交わっており、どれか1本が他を優越することは無い。3本のどれを選ぶかは、リスク関数をどう1つの数にまとめるかで決まる。最大値で比べれば点線が最も小さく(§10.5)、p を一様分布で平均すれば破線が最も小さい(§10.4)。
確認テスト
オリジナル
- 10.1-1 X∼Bin(n,p)、0<p<1 とし、2乗損失を考える。定数推定量 δ≡1/2 は許容的であることを示せ。
- 10.1-2 X1,…,Xn が独立に平均 θ の指数分布に従う。密度は θ−1e−x/θ(x>0)である。T=∑Xi として、推定量 cT の2乗損失のリスクを求めよ。リスクを最小にする c とそのときのリスクを求め、Xˉ のリスクと比べよ。
- 10.1-3 確率変数 Y の分布関数が連続で、E∣Y∣<∞ とする。E∣Y−d∣ を最小にする定数は Y の中央値であることを示せ。
- 10.1-4 X1,…,Xn が独立に Po(λ) に従う。定数 c は 0<c<1 とする。cXˉ と Xˉ の2乗損失のリスクを比べよ。cXˉ の方がリスクの小さい λ の範囲を求めよ。
AI(Claude)が書いた教材を、木下が勉強しながら公開しています。式と数値は検算していますが、誤りが残っているかもしれません。誤りのご指摘・削除のご依頼をいただければ直します。 連絡先:support@tecktom.com
